Presentación
Whisper es un modelo open source de reconocimiento automático del habla desarrollado por OpenAI para transformar grabaciones de audio en texto.
Presentado en 2022, fue entrenado con 680.000 horas de datos de audio supervisados procedentes de numerosos idiomas y situaciones. Esta diversidad busca especialmente mejorar su robustez frente a acentos, ruido de fondo y vocabulario técnico.
Whisper no se limita a la transcripción. Sus modelos multilingües también pueden identificar el idioma hablado y traducir al inglés una grabación realizada en otro idioma.
El código y los pesos de los modelos se publican bajo licencia MIT, lo que permite instalar Whisper en el propio equipo y construir aplicaciones alrededor de sus capacidades sin depender obligatoriamente de un servicio cloud.
OpenAI ofrece paralelamente el modelo whisper-1 dentro de su API Audio. Esta solución evita ejecutar el modelo en local, pero se factura según la duración del audio procesado.
Funcionalidades
Transcripción de audio
La función principal de Whisper consiste en convertir un archivo que contiene voz en texto.
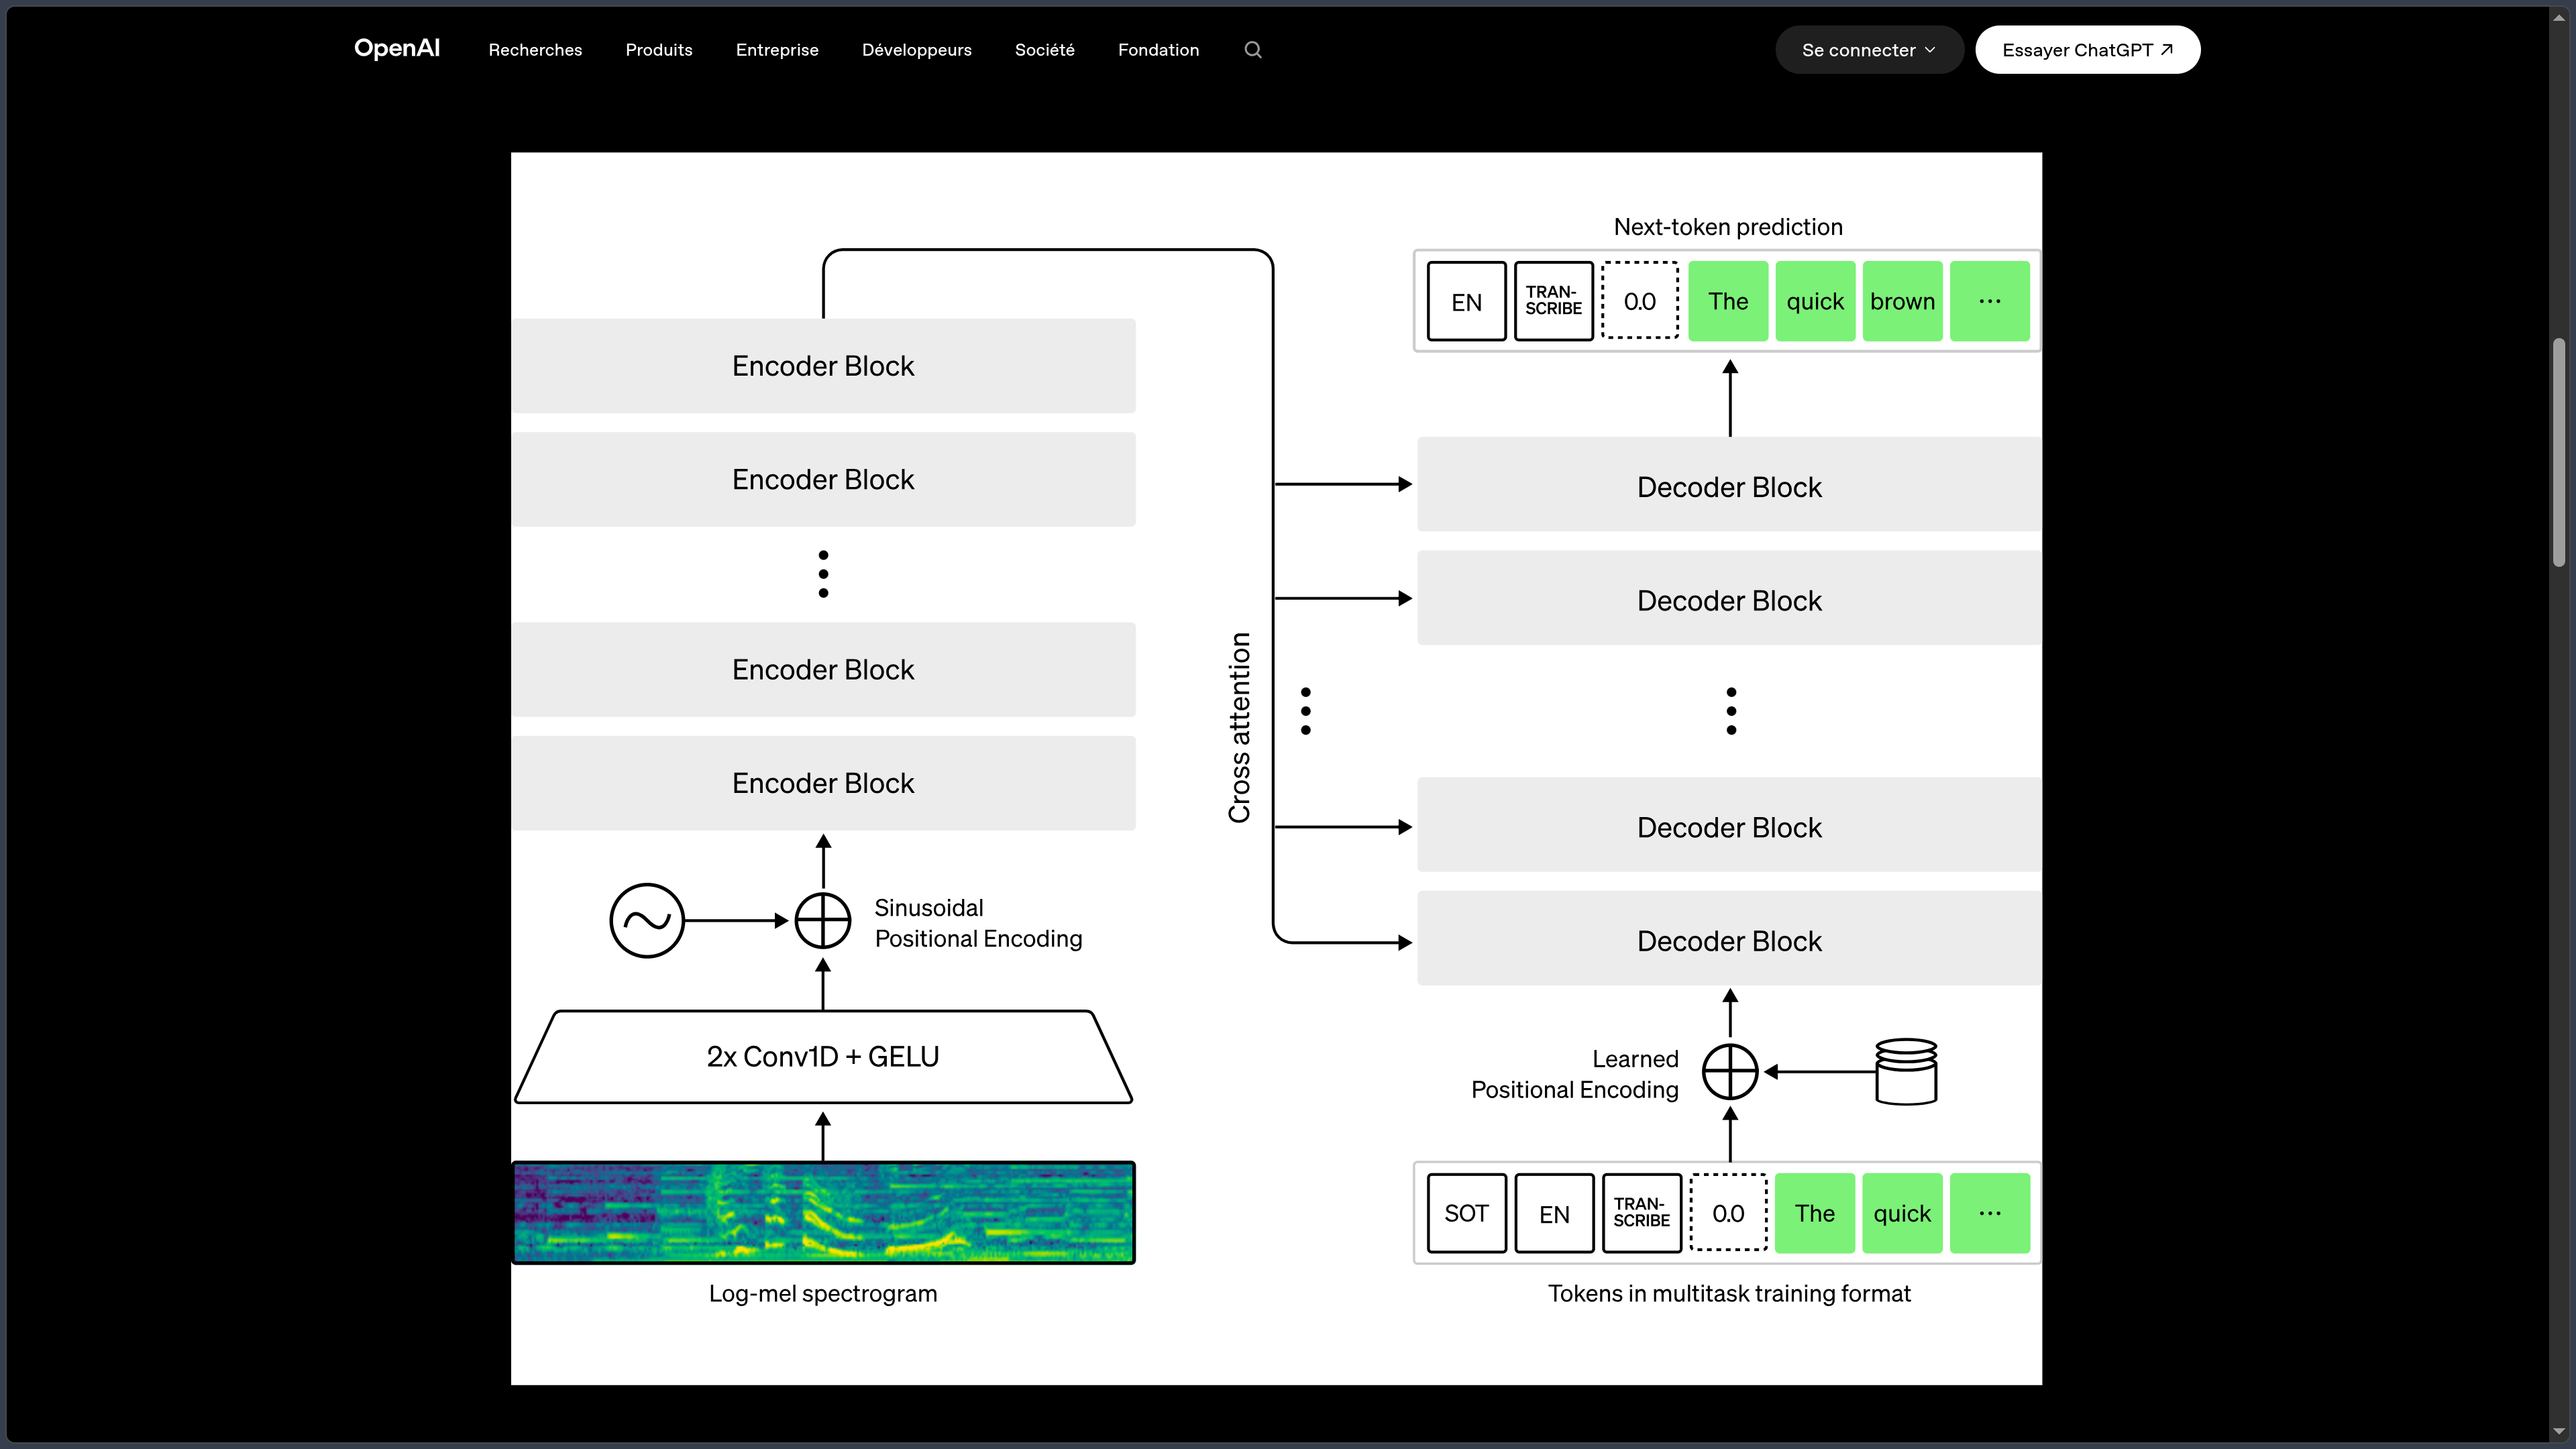
El modelo analiza el audio mediante ventanas sucesivas y produce una transcripción acompañada de información temporal.
Puede utilizarse con entrevistas, podcasts, reuniones, conferencias, vídeos, notas de voz u otros contenidos hablados.
Sin embargo, la precisión depende en gran medida de la calidad del sonido, el idioma, el modelo elegido y las condiciones de grabación.
Reconocimiento multilingüe
Whisper fue entrenado con datos que cubren numerosos idiomas y puede identificar automáticamente el idioma utilizado en una grabación.
Los modelos multilingües transcriben después el habla en su idioma original.
Sin embargo, el rendimiento no es uniforme. Los idiomas con mayor representación en los datos de entrenamiento suelen obtener mejores resultados que aquellos con menos datos disponibles.
Whisper también puede encontrar más dificultades con determinados acentos, dialectos o grabaciones muy cortas y ruidosas.
Traducción al inglés
Los modelos multilingües de Whisper pueden realizar una traducción directa del habla al inglés.
Una grabación en francés, japonés u otro idioma compatible puede así producir directamente texto en inglés sin pasar primero por una transcripción separada y después por un sistema de traducción.
Esta función no es un traductor universal entre todos los pares de idiomas: la tarea de traducción nativa de Whisper tiene como destino el inglés.
El modelo turbo está además optimizado para transcripción y no está destinado a esta tarea de traducción. OpenAI recomienda utilizar un modelo multilingüe como medium o large cuando se necesita traducir al inglés.
Varios tamaños de modelo
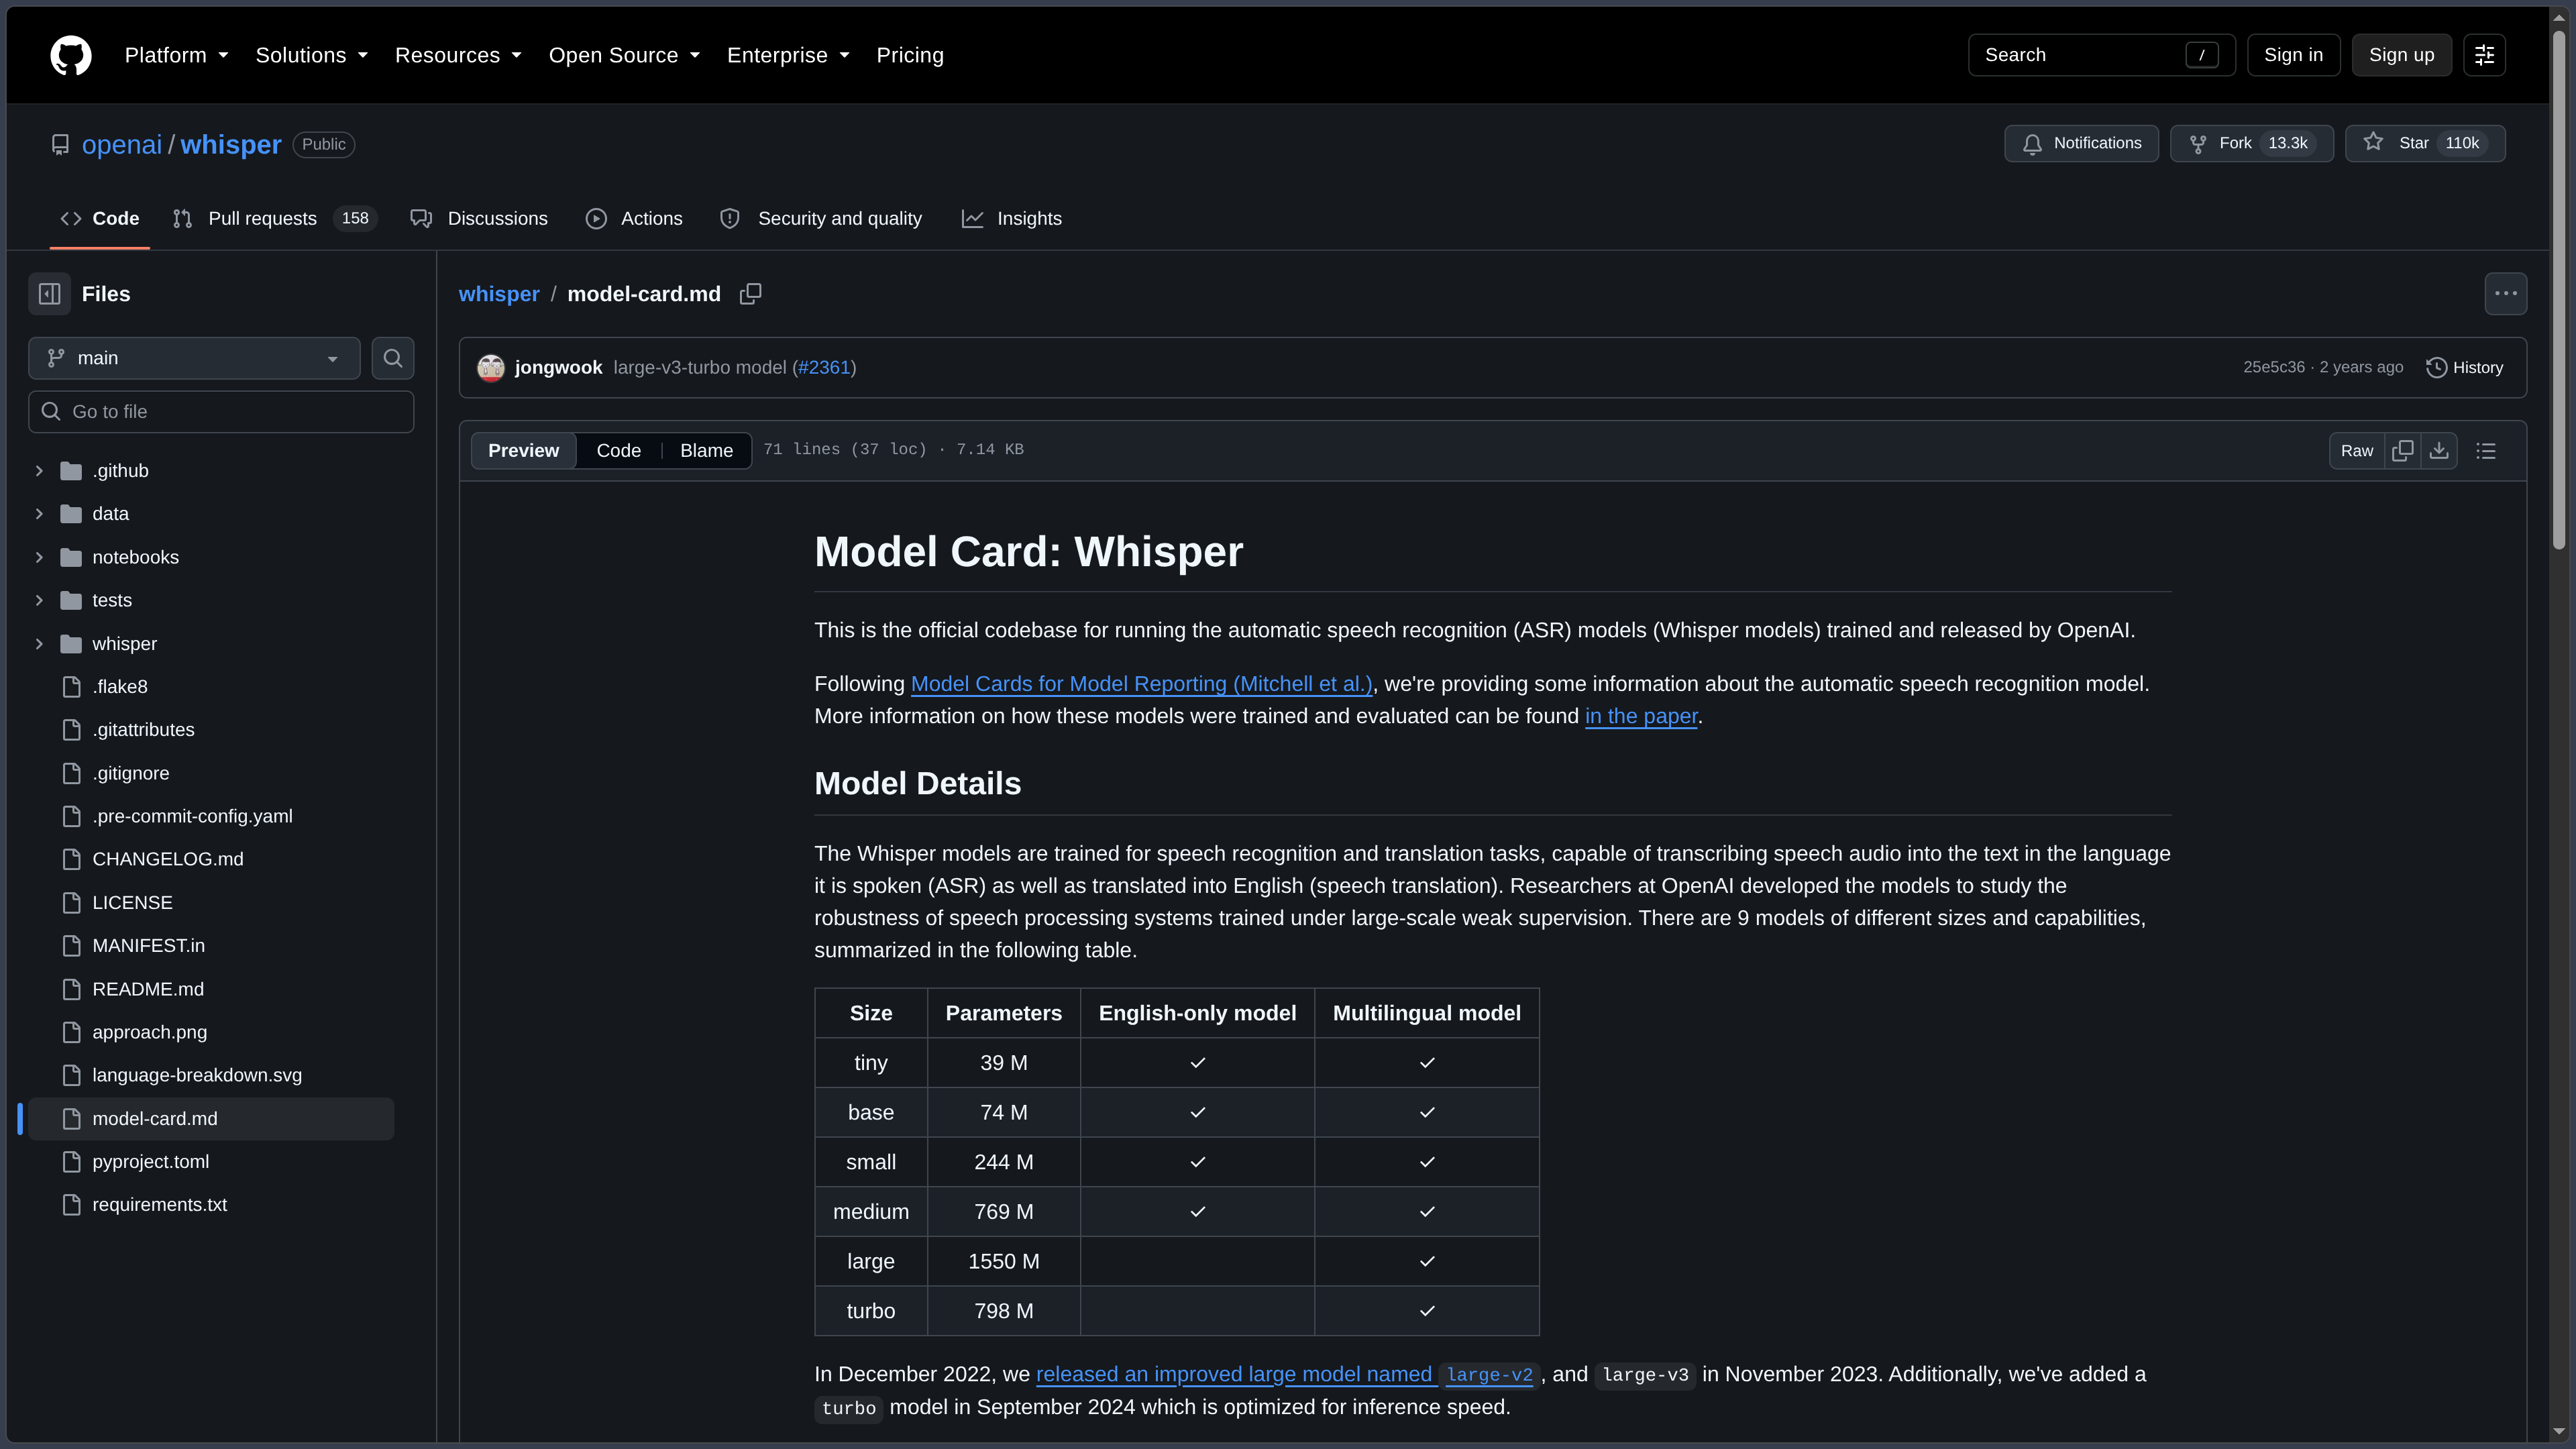
Whisper ofrece varios tamaños de modelo para equilibrar velocidad, consumo de memoria y precisión.
Las principales variantes son tiny, base, small, medium, large y turbo. Las cuatro primeras también disponen de variantes .en especializadas en inglés.
Los requisitos aproximados de memoria GPU van desde alrededor de 1 GB para tiny y base hasta unos 10 GB para large.
turbo necesita alrededor de 6 GB de VRAM y constituye una versión optimizada de large-v3, diseñada para acelerar considerablemente la transcripción manteniendo una precisión cercana a la del modelo grande.
Esta variedad permite adaptar Whisper tanto a equipos modestos como a estaciones de trabajo equipadas con GPU más potentes.
Ejecución local
Whisper puede funcionar directamente en un ordenador sin enviar la grabación a un servicio remoto.
La instalación oficial se basa en Python, PyTorch y FFmpeg, mediante el paquete openai-whisper.
Este enfoque local puede resultar interesante para datos privados, tratamientos automatizados o proyectos en los que se necesita controlar el coste de muchas horas de transcripción.
Sin embargo, el rendimiento depende del hardware. Whisper puede funcionar sobre CPU, pero una GPU compatible acelera considerablemente los modelos más pesados.
Windows, macOS y Linux pueden ejecutar Whisper siempre que el entorno Python y sus dependencias estén correctamente instalados.
Línea de comandos
Whisper ofrece una interfaz de línea de comandos que permite lanzar rápidamente una transcripción sin desarrollar una aplicación completa.
Uno o varios archivos de audio pueden enviarse al programa indicando el modelo, el idioma o la tarea deseada.
Esta interfaz resulta adecuada tanto para tratamientos puntuales como para scripts shell o flujos automatizados que procesan varios archivos de forma consecutiva.
Los formatos realmente utilizables dependen especialmente de FFmpeg, que se encarga de decodificar el audio antes de que lo procese el modelo.
Uso con Python
Whisper también puede integrarse directamente dentro de una aplicación Python.
La biblioteca permite cargar un modelo, transcribir un archivo, detectar un idioma y acceder a funciones de decodificación de nivel más bajo.
Esta integración facilita la creación de herramientas de transcripción, motores de búsqueda en archivos de audio, generadores de subtítulos o pipelines de procesamiento multimedia.
La licencia MIT también permite a los desarrolladores construir sus propias interfaces y servicios alrededor de los modelos.
Marcas de tiempo y subtitulado
Whisper puede producir información temporal asociada a la transcripción.
Estos datos permiten sincronizar texto con un archivo de audio o vídeo y construir subtítulos.
La biblioteca oficial admite especialmente distintos formatos de salida adaptados a usos de transcripción y puede proporcionar marcas de tiempo a nivel de palabra.
Sigue siendo preferible una revisión humana cuando el subtitulado debe respetar con precisión el ritmo, los cambios de interlocutor o las normas editoriales de una producción.
Modelo turbo
El modelo turbo, también conocido como large-v3-turbo, es una versión optimizada de large-v3.
Reduce considerablemente la parte de decodificación para aumentar la velocidad de inferencia manteniendo una pérdida de precisión limitada respecto al modelo grande.
El repositorio oficial lo selecciona actualmente por defecto en los ejemplos habituales de transcripción.
Por tanto, constituye un buen compromiso para procesar grandes cantidades de audio cuando la velocidad importa tanto como la precisión.
Sin embargo, para traducir idiomas extranjeros al inglés deben preferirse los modelos multilingües clásicos frente a turbo.
API de OpenAI
Whisper también puede utilizarse sin instalación local mediante el modelo whisper-1 disponible en la API de OpenAI.
Esta solución ejecuta el modelo en la infraestructura de OpenAI y factura actualmente la transcripción a 0,006 $US por minuto.
Puede simplificar la integración dentro de un servicio Web o una aplicación cuando el usuario no desea gestionar por sí mismo los modelos y el hardware.
Sin embargo, la API y la versión open source deben considerarse dos modos de uso distintos: uno funciona sobre una infraestructura remota de pago y el otro sobre hardware controlado por el usuario.
Casos de uso
Transcribir una entrevista
Una grabación de entrevista puede procesarse con Whisper para obtener una primera versión escrita.
El texto puede después revisarse y corregirse antes de su publicación, archivo o uso dentro de un artículo.
Generar subtítulos
Whisper puede transformar la pista de audio de un vídeo en texto con marcas de tiempo.
Esta información puede servir como base para subtítulos destinados a un vídeo, formación o contenido publicado online.
Indexar podcasts o archivos de audio
Una colección de programas, conferencias o grabaciones puede transcribirse automáticamente.
El texto resultante se vuelve entonces consultable, lo que facilita encontrar un tema, una persona o un fragmento preciso dentro de grandes archivos de audio.
Transcribir contenidos privados en local
Una organización o un usuario puede ejecutar Whisper directamente en su propio equipo para que los archivos de audio no se envíen a una API remota.
Este enfoque requiere más configuración y potencia de cálculo, pero ofrece mayor control sobre el tratamiento de los datos.
Traducir una grabación al inglés
Un contenido hablado en otro idioma puede transformarse directamente en texto inglés utilizando un modelo multilingüe compatible.
Esta función puede servir para preparar una traducción, analizar contenido en otro idioma o crear una primera versión de subtítulos en inglés.
Conclusión
Whisper sigue siendo un modelo open source de reconocimiento de voz especialmente versátil para desarrolladores y creadores que quieren transformar audio en texto.
Su principal interés procede de la combinación entre transcripción multilingüe, identificación de idioma, traducción al inglés y la posibilidad de ejecutar completamente los modelos sobre el propio hardware del usuario.
Los distintos tamaños permiten adaptar el equilibrio entre precisión y recursos disponibles, mientras que turbo ofrece una solución especialmente rápida para la transcripción.
La disponibilidad del código y los pesos bajo licencia MIT también ha favorecido un amplio ecosistema de interfaces, integraciones y variantes construidas alrededor de Whisper.
Sin embargo, el modelo sigue siendo una tecnología de reconocimiento automático y no una herramienta de transcripción infalible. Las alucinaciones, repeticiones, errores con nombres propios y diferencias de rendimiento entre idiomas obligan a revisar el texto cuando debe ser fiable.
OpenAI ofrece actualmente modelos de transcripción más recientes dentro de su API, pero Whisper conserva un interés particular gracias a su ejecución local, apertura y ecosistema.
Para transcribir archivos de audio o vídeo, generar subtítulos, automatizar el tratamiento de contenidos hablados o integrar reconocimiento de voz local dentro de una aplicación, Whisper sigue siendo una base sólida y flexible.
Puntos de atención
-
Whisper es open source bajo licencia MIT. El código y los pesos de los modelos pueden descargarse y ejecutarse localmente sin costes de API.
-
La última release oficial del paquete es v20250625 a 3 de octubre de 2026. Esta versión aporta principalmente correcciones, cambios de compatibilidad y actualizaciones técnicas.
-
turboestá optimizado para transcripción, no para traducción. Para traducir un idioma extranjero al inglés, OpenAI recomienda un modelo multilingüe comomediumolarge. -
Whisper puede alucinar texto. En determinadas condiciones, especialmente con silencio, ruido o señales ambiguas, puede producir palabras que realmente no fueron pronunciadas.
-
El rendimiento varía según idiomas, acentos y dialectos. Una buena precisión en inglés o francés no garantiza resultados equivalentes para todos los idiomas.
-
Whisper no proporciona de forma nativa un sistema completo de diarización de interlocutores. Identificar automáticamente quién habla puede requerir herramientas adicionales.
-
El modelo no está diseñado como un sistema de transcripción en tiempo real listo para usar. Aplicaciones de terceros pueden construir flujos casi en tiempo real alrededor de Whisper, pero este comportamiento no constituye el funcionamiento nativo del modelo.
-
La instalación local requiere un entorno técnico. Python, PyTorch y FFmpeg forman parte de las principales dependencias, y una GPU resulta útil para los modelos más pesados.
-
El repositorio actual declara Python 3.8 o posterior y menciona compatibilidad hasta Python 3.13. La compatibilidad real también depende de las versiones instaladas de PyTorch, FFmpeg y otras dependencias.
-
El modelo
largenecesita alrededor de 10 GB de VRAM yturboalrededor de 6 GB según las estimaciones oficiales. Los modelos pequeños reducen considerablemente las necesidades de hardware a cambio, generalmente, de una precisión inferior. -
La API
whisper-1es un servicio de pago independiente de la ejecución local. Actualmente cuesta 0,006 $US por minuto de transcripción y requiere enviar el archivo a la infraestructura de OpenAI. -
El límite de la API legacy
whisper-1es de 25 MiB por solicitud. Los archivos más grandes deben dividirse o procesarse mediante una estrategia adecuada. -
Una transcripción automática debe revisarse para usos sensibles o profesionales. Los errores sobre cifras, nombres, términos técnicos o frases ambiguas pueden modificar el significado del contenido.