Présentation
Whisper est un modèle open source de reconnaissance automatique de la parole développé par OpenAI pour transformer des enregistrements audio en texte.
Présenté en 2022, il a été entraîné sur 680 000 heures de données audio supervisées provenant de nombreuses langues et situations. Cette diversité vise notamment à améliorer sa robustesse face aux accents, au bruit de fond et au vocabulaire technique.
Whisper ne se limite pas à la transcription. Ses modèles multilingues peuvent également identifier la langue parlée et traduire vers l’anglais un enregistrement réalisé dans une autre langue.
Le code et les poids des modèles sont publiés sous licence MIT, ce qui permet d’installer Whisper sur sa propre machine et de construire des applications autour de ses capacités sans dépendre obligatoirement d’un service cloud.
OpenAI propose parallèlement le modèle whisper-1 dans son API Audio. Cette solution évite de faire fonctionner le modèle localement, mais elle est facturée selon la durée audio traitée.
Fonctionnalités
Transcription audio
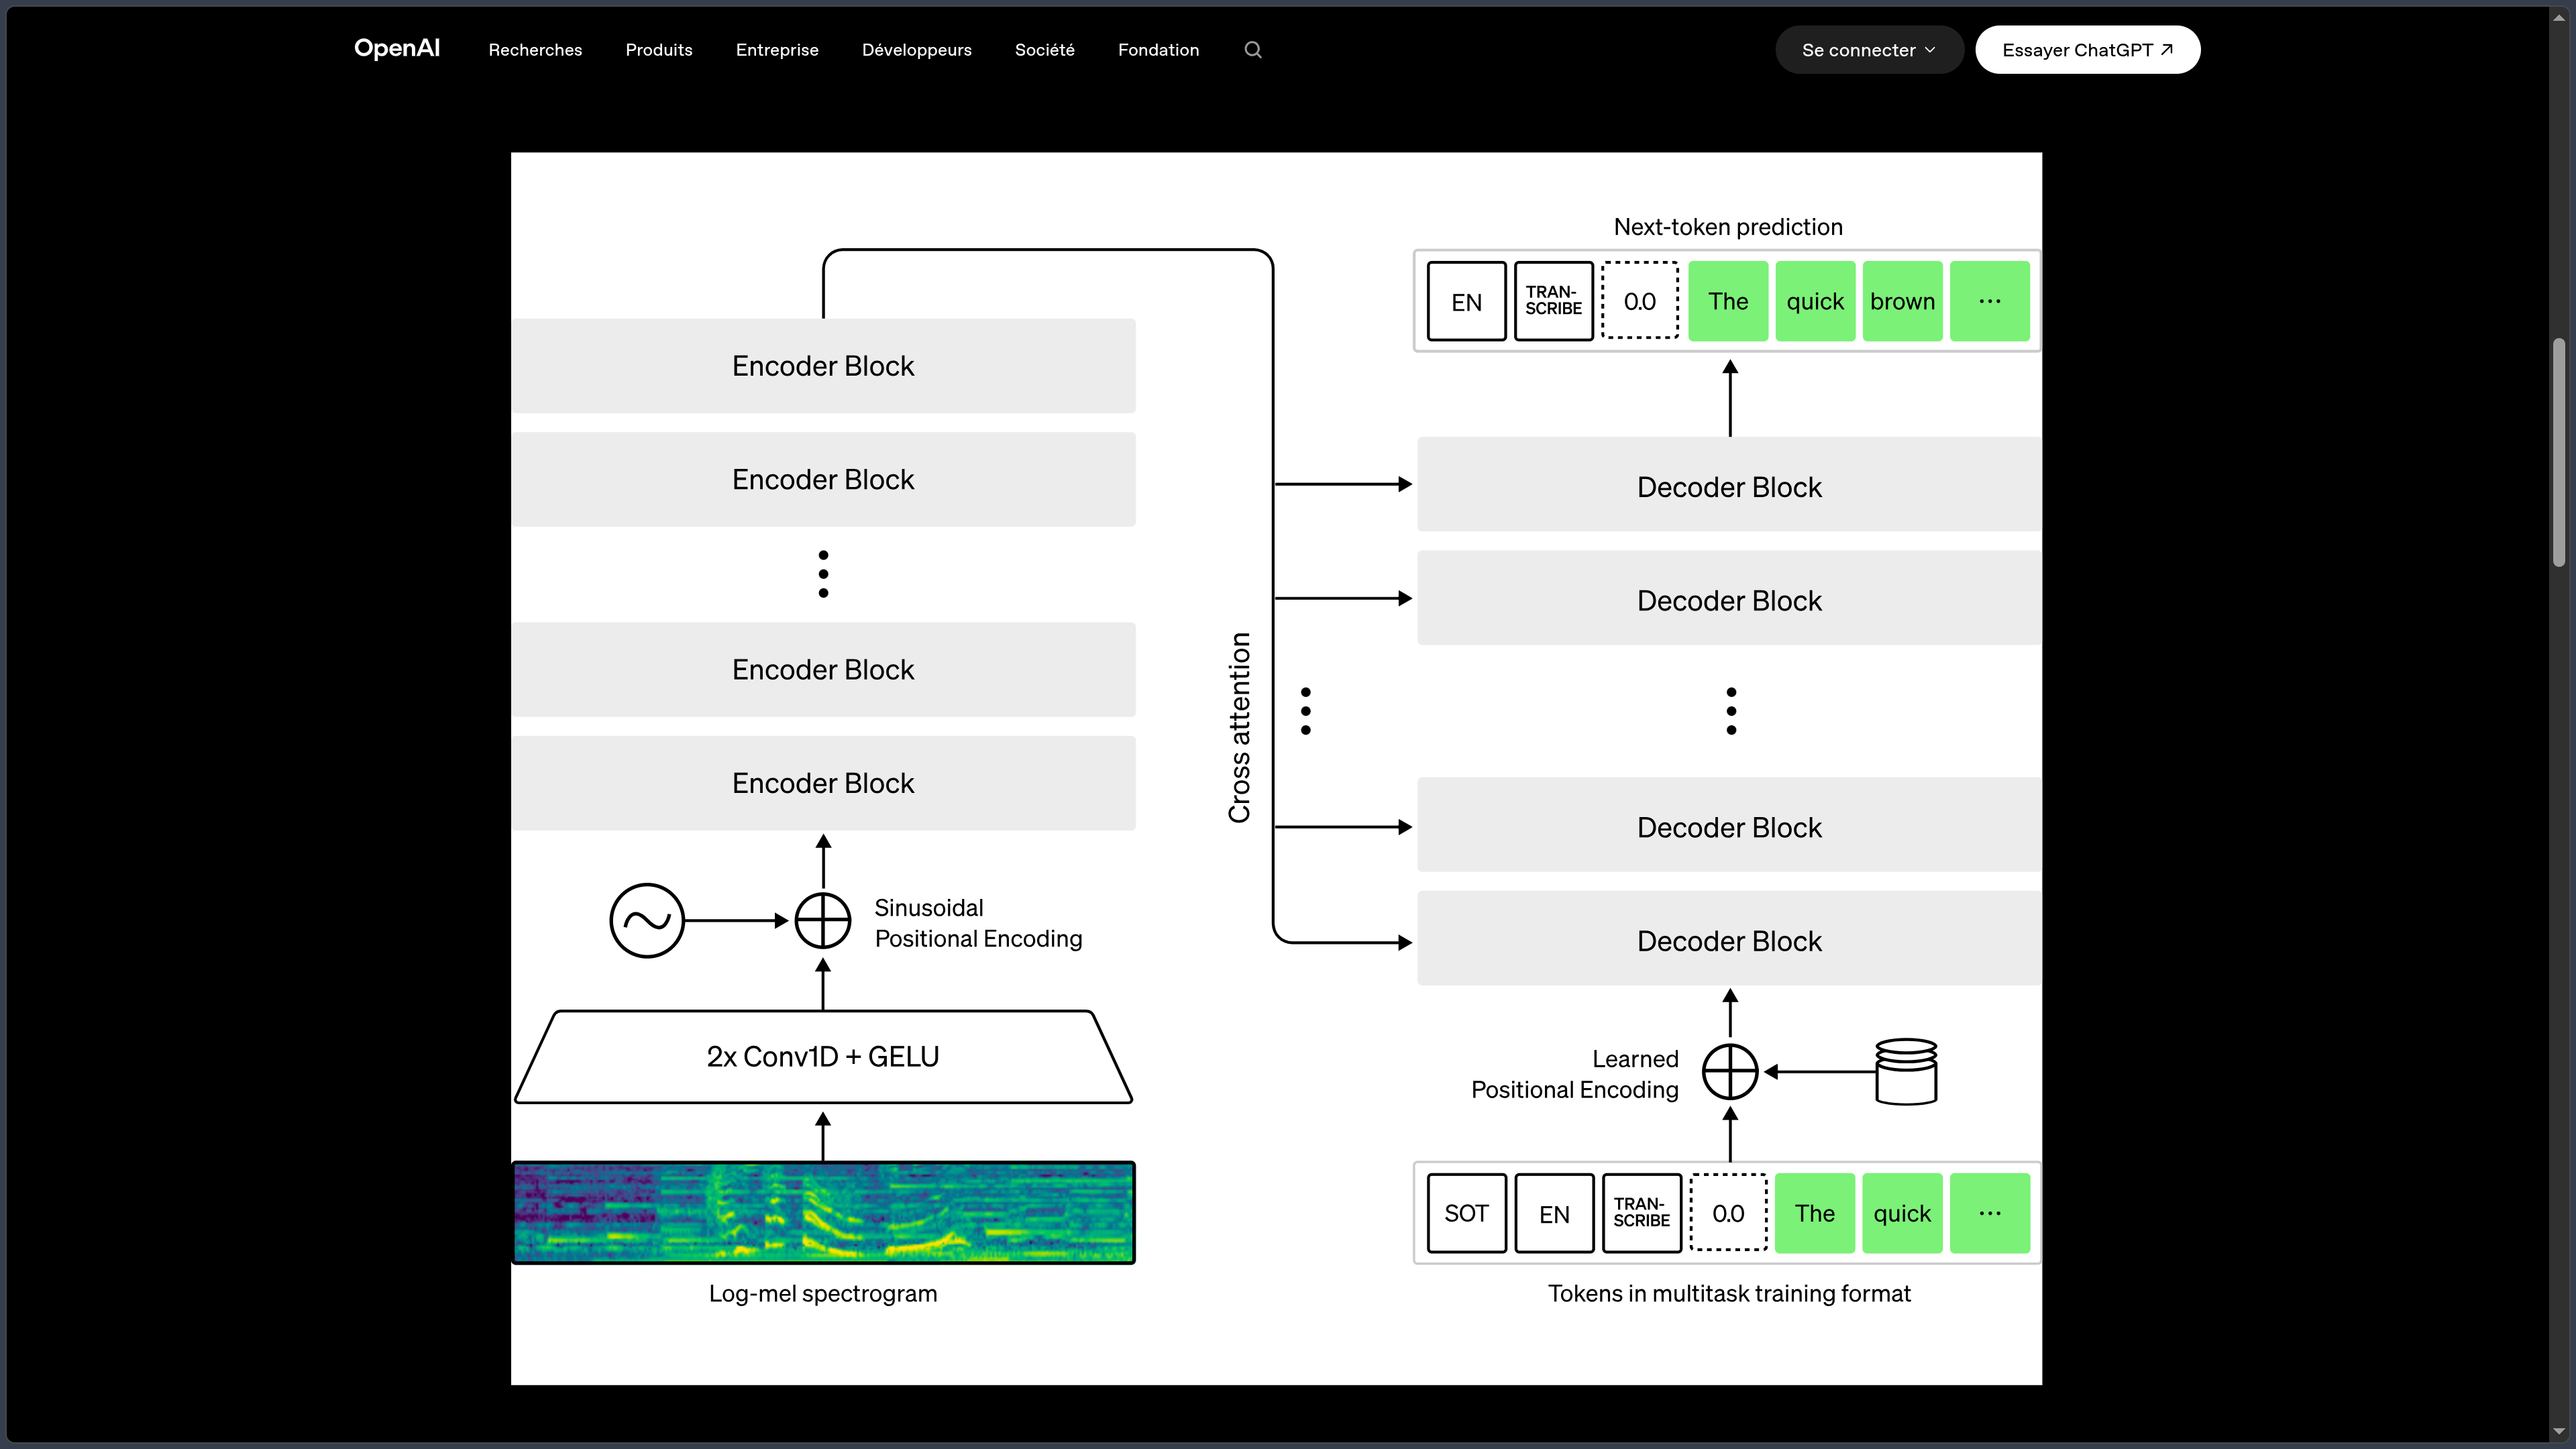
La fonction principale de Whisper consiste à convertir un fichier contenant de la parole en texte.
Le modèle analyse l’audio par fenêtres successives et produit une transcription accompagnée d’informations temporelles.
Il peut être utilisé sur des interviews, podcasts, réunions, conférences, vidéos, mémos vocaux ou autres contenus parlés.
La précision dépend cependant fortement de la qualité du son, de la langue, du modèle choisi et des conditions d’enregistrement.
Reconnaissance multilingue
Whisper a été entraîné sur des données couvrant de nombreuses langues et peut automatiquement identifier la langue utilisée dans un enregistrement.
Les modèles multilingues transcrivent ensuite la parole dans sa langue d’origine.
Les performances ne sont toutefois pas uniformes. Les langues fortement représentées dans les données d’entraînement bénéficient généralement de meilleurs résultats que celles disposant de moins de données.
Whisper peut également rencontrer davantage de difficultés avec certains accents, dialectes ou enregistrements très courts et bruités.
Traduction vers l’anglais
Les modèles multilingues de Whisper peuvent effectuer une traduction directe de la parole vers l’anglais.
Un enregistrement en français, japonais ou dans une autre langue prise en charge peut ainsi produire directement un texte anglais sans passer séparément par un premier transcript puis un système de traduction.
Cette fonction n’est pas un traducteur universel entre toutes les paires de langues : la tâche de traduction native de Whisper cible l’anglais.
Le modèle turbo est par ailleurs optimisé pour la transcription et n’est pas destiné à cette tâche de traduction. OpenAI recommande d’utiliser un modèle multilingue comme medium ou large lorsque la traduction vers l’anglais est nécessaire.
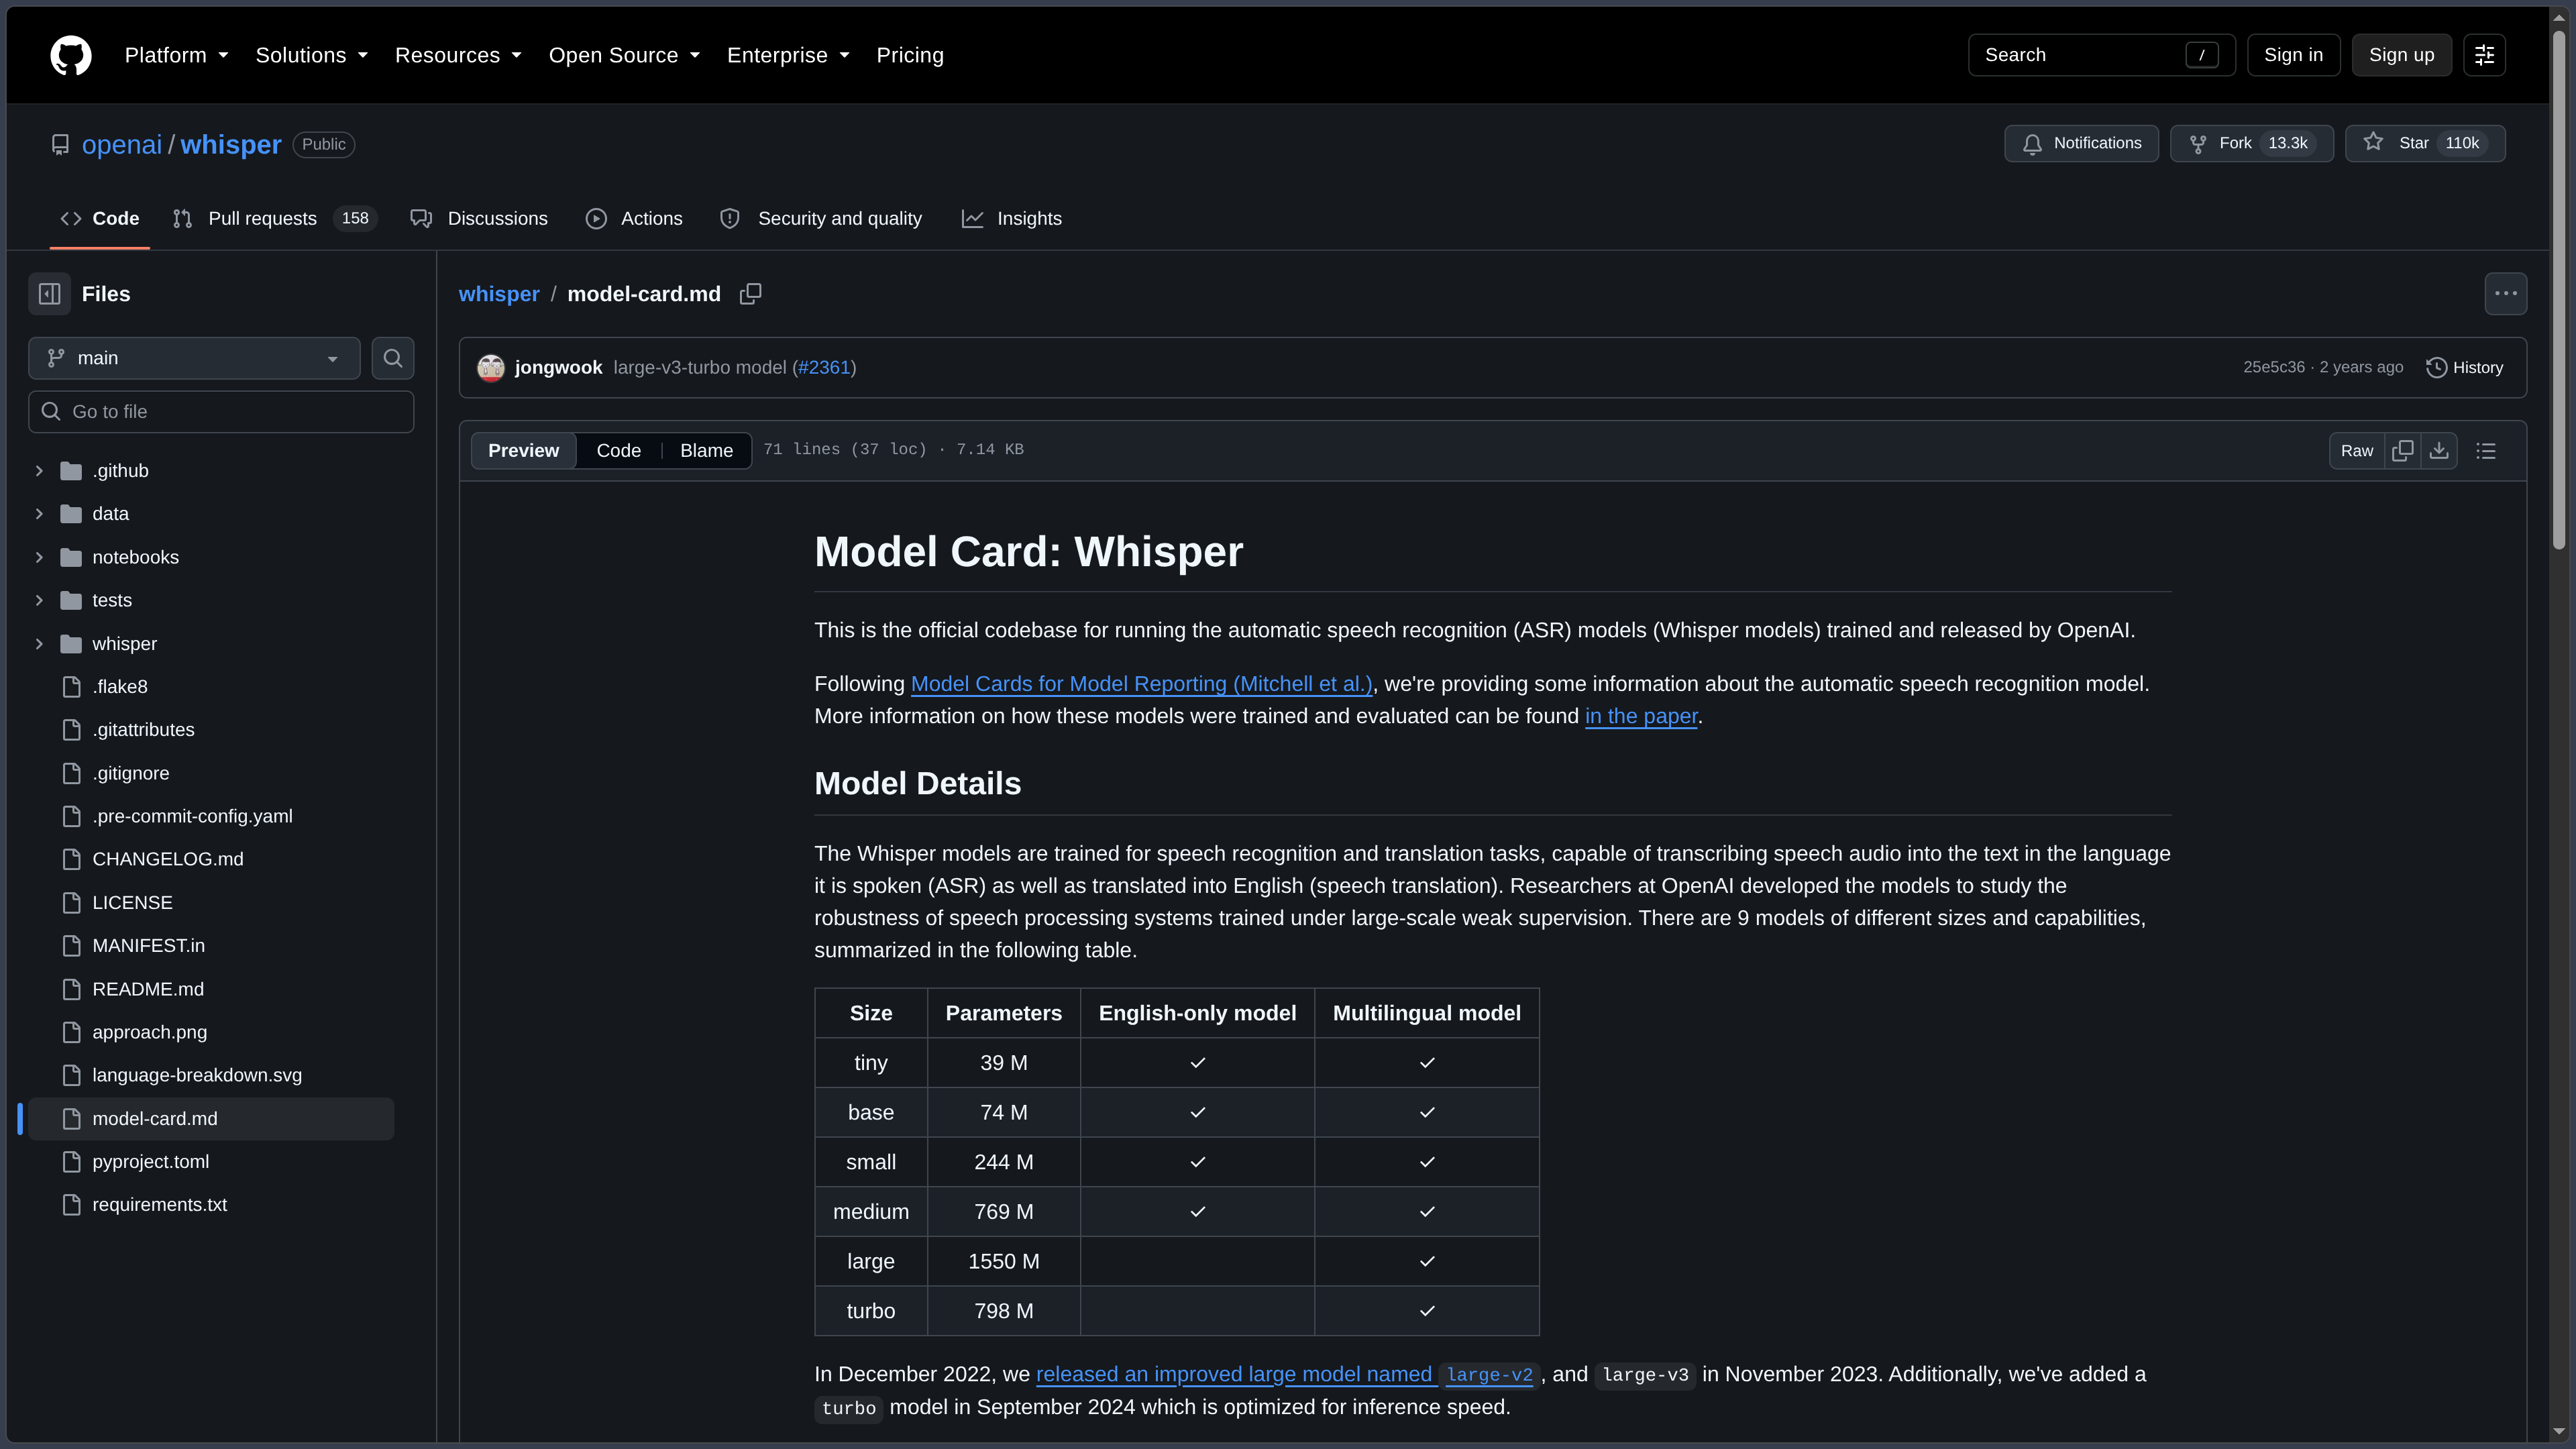
Plusieurs tailles de modèles
Whisper propose plusieurs tailles permettant d’arbitrer entre vitesse, consommation de mémoire et précision.
Les principales variantes sont tiny, base, small, medium, large et turbo. Les quatre premières possèdent également des variantes .en spécialisées dans l’anglais.
Les besoins approximatifs en mémoire GPU vont d’environ 1 Go pour tiny et base à environ 10 Go pour large.
turbo demande environ 6 Go de VRAM et constitue une version optimisée de large-v3, conçue pour accélérer fortement la transcription tout en conservant une précision proche du grand modèle.
Ce choix permet d’adapter Whisper aussi bien à une petite machine qu’à un poste équipé d’un GPU plus puissant.
Exécution locale
Whisper peut fonctionner directement sur un ordinateur sans envoyer l’enregistrement à un service distant.
L’installation officielle repose sur Python, PyTorch et FFmpeg, avec le paquet openai-whisper.
Cette approche locale peut être intéressante pour les données privées, les traitements automatisés ou les projets où le coût de nombreuses heures de transcription doit être maîtrisé.
Les performances dépendent cependant du matériel. Whisper peut fonctionner sur CPU, mais l’utilisation d’un GPU compatible accélère considérablement les modèles les plus lourds.
Windows, macOS et Linux peuvent exécuter Whisper dès lors que l’environnement Python et ses dépendances sont correctement installés.
Ligne de commande
Whisper fournit une interface en ligne de commande permettant de lancer rapidement une transcription sans développer une application complète.
Un ou plusieurs fichiers audio peuvent être envoyés au programme avec le modèle à utiliser, la langue ou la tâche souhaitée.
Cette interface convient aux traitements ponctuels mais aussi aux scripts shell ou aux workflows automatisés qui enchaînent plusieurs fichiers.
Les formats réellement exploitables dépendent notamment de FFmpeg, qui assure le décodage audio en amont du modèle.
Utilisation avec Python
Whisper peut également être intégré directement dans une application Python.
La bibliothèque permet de charger un modèle, transcrire un fichier, détecter une langue et accéder à des fonctions de décodage plus bas niveau.
Cette intégration facilite la création d’outils de transcription, de moteurs de recherche dans des archives audio, de générateurs de sous-titres ou de pipelines de traitement multimédia.
La licence MIT permet également aux développeurs de construire leurs propres interfaces et services autour des modèles.
Horodatages et sous-titrage
Whisper peut produire des informations temporelles associées à la transcription.
Ces données permettent de synchroniser du texte avec un fichier audio ou vidéo et de construire des sous-titres.
La bibliothèque officielle prend notamment en charge des sorties adaptées à différents usages de transcription et peut fournir des horodatages au niveau des mots.
Une vérification humaine reste préférable lorsqu’un sous-titrage doit respecter précisément le rythme, les changements de locuteur ou les règles éditoriales d’une production.
Modèle turbo
Le modèle turbo, également appelé large-v3-turbo, est une version optimisée de large-v3.
Il réduit fortement la partie de décodage afin d’augmenter la vitesse d’inférence avec une perte de précision limitée par rapport au modèle large.
Le dépôt officiel le sélectionne désormais par défaut dans les exemples courants de transcription.
Il constitue ainsi un compromis intéressant pour traiter de grandes quantités d’audio lorsque la vitesse compte autant que la précision.
Pour la traduction de langues étrangères vers l’anglais, il faut cependant privilégier les modèles multilingues classiques plutôt que turbo.
API OpenAI
Whisper peut également être utilisé sans installation locale grâce au modèle whisper-1 disponible via l’API OpenAI.
Cette solution déporte l’exécution sur l’infrastructure d’OpenAI et facture actuellement la transcription 0,006 $US par minute.
Elle peut simplifier l’intégration dans un service Web ou une application lorsque l’utilisateur ne souhaite pas gérer lui-même les modèles et le matériel.
L’API et la version open source doivent toutefois être considérées comme deux modes d’utilisation différents : l’un fonctionne sur une infrastructure distante payante, l’autre sur le matériel contrôlé par l’utilisateur.
Cas d’usage
Transcrire une interview
Un enregistrement d’interview peut être traité par Whisper afin d’obtenir une première version écrite.
Le texte peut ensuite être relu et corrigé avant publication, archivage ou utilisation dans un article.
Générer des sous-titres
Whisper peut transformer la piste audio d’une vidéo en texte horodaté.
Ces informations peuvent servir de base à des sous-titres destinés à une vidéo, une formation ou un contenu publié en ligne.
Indexer des podcasts ou archives audio
Une collection d’émissions, conférences ou enregistrements peut être transcrite automatiquement.
Le texte devient ensuite recherchable, ce qui permet de retrouver plus facilement un sujet, une personne ou un passage précis dans de grandes archives audio.
Transcrire localement des contenus privés
Une organisation ou un utilisateur peut exécuter Whisper directement sur sa propre machine afin que les fichiers audio ne soient pas envoyés à une API distante.
Cette approche nécessite davantage de configuration et de puissance de calcul mais donne davantage de contrôle sur le traitement des données.
Traduire un enregistrement vers l’anglais
Un contenu parlé dans une autre langue peut être transformé directement en texte anglais avec un modèle multilingue compatible.
Cette fonction peut servir à préparer une traduction, analyser un contenu étranger ou créer une première version de sous-titres anglais.
Conclusion
Whisper reste un modèle de reconnaissance vocale open source particulièrement polyvalent pour les développeurs et créateurs qui souhaitent transformer de l’audio en texte.
Son principal intérêt vient de la combinaison entre transcription multilingue, identification de langue, traduction vers l’anglais et possibilité d’exécuter entièrement les modèles sur son propre matériel.
Les différentes tailles permettent d’adapter le compromis entre précision et ressources disponibles, tandis que turbo offre une solution particulièrement rapide pour la transcription.
La disponibilité du code et des poids sous licence MIT a également favorisé de nombreuses interfaces, intégrations et variantes construites autour de Whisper.
Le modèle reste cependant une technologie de reconnaissance automatique et non une transcription infaillible. Les hallucinations, répétitions, erreurs sur les noms propres et écarts de performance entre langues imposent une vérification lorsque le texte doit être fiable.
OpenAI propose aujourd’hui des modèles de transcription plus récents dans son offre API, mais Whisper conserve un intérêt particulier grâce à son exécution locale, son ouverture et son écosystème.
Pour transcrire des fichiers audio ou vidéo, générer des sous-titres, automatiser le traitement de contenus parlés ou intégrer une reconnaissance vocale locale dans une application, Whisper reste une base solide et flexible.
Points d’attention
-
Whisper est open source sous licence MIT. Le code et les poids des modèles peuvent être téléchargés et exécutés localement sans frais d’API.
-
La dernière release officielle du paquet est v20250625 au 3 octobre 2026. Cette version apporte principalement des corrections, des évolutions de compatibilité et des mises à jour techniques.
-
turboest optimisé pour la transcription, pas pour la traduction. Pour traduire une langue étrangère vers l’anglais, OpenAI recommande un modèle multilingue commemediumoularge. -
Whisper peut halluciner du texte. Dans certaines conditions, notamment avec du silence, du bruit ou un signal ambigu, il peut produire des mots qui n’ont pas réellement été prononcés.
-
Les performances diffèrent selon les langues, accents et dialectes. Une bonne précision en anglais ou en français ne garantit pas un résultat équivalent pour toutes les langues.
-
Whisper ne fournit pas nativement un système complet de diarisation des locuteurs. Identifier automatiquement qui parle peut nécessiter des outils complémentaires.
-
Le modèle n’est pas conçu comme un système de transcription temps réel clé en main. Des applications tierces peuvent construire du quasi temps réel autour de Whisper, mais ce comportement ne constitue pas le fonctionnement natif du modèle.
-
Une installation locale demande un environnement technique. Python, PyTorch et FFmpeg font partie des principales dépendances, et un GPU devient utile pour les modèles les plus lourds.
-
Le dépôt actuel déclare Python 3.8 ou supérieur et référence Python jusqu’à 3.13. La compatibilité réelle dépend également des versions de PyTorch, FFmpeg et des autres dépendances installées.
-
Le modèle
largedemande environ 10 Go de VRAM etturboenviron 6 Go selon les estimations officielles. Les petits modèles réduisent fortement les besoins matériels au prix d’une précision généralement inférieure. -
L’API
whisper-1est un service payant distinct de l’exécution locale. Elle coûte actuellement 0,006 $US par minute de transcription et nécessite l’envoi du fichier à l’infrastructure OpenAI. -
La limite de l’API legacy
whisper-1est de 25 Mio par requête. Les fichiers plus volumineux doivent être découpés ou traités selon une stratégie adaptée. -
Une transcription automatique doit être vérifiée pour les usages sensibles ou professionnels. Les erreurs sur des chiffres, noms, termes techniques ou phrases ambiguës peuvent changer le sens du contenu.