Présentation
Tu poses exactement la même question à deux modèles.
Tu lis les réponses, tu choisis celle qui te paraît la plus convaincante, puis seulement après le vote leurs noms apparaissent.
C’est dans cet écart entre réputation et résultat qu’Arena trouve son intérêt.
Lancé en 2023 sous le nom Chatbot Arena, puis devenu LMArena et enfin Arena, le projet repose sur une idée simple : confronter plusieurs systèmes d’intelligence artificielle à la même tâche et observer leurs différences à partir des préférences de vrais utilisateurs.
Le Battle Mode conserve cette logique historique.
Deux modèles anonymes répondent au même prompt ; l’utilisateur vote avant de découvrir leur identité.
Le Side by Side permet au contraire de choisir directement deux références précises.
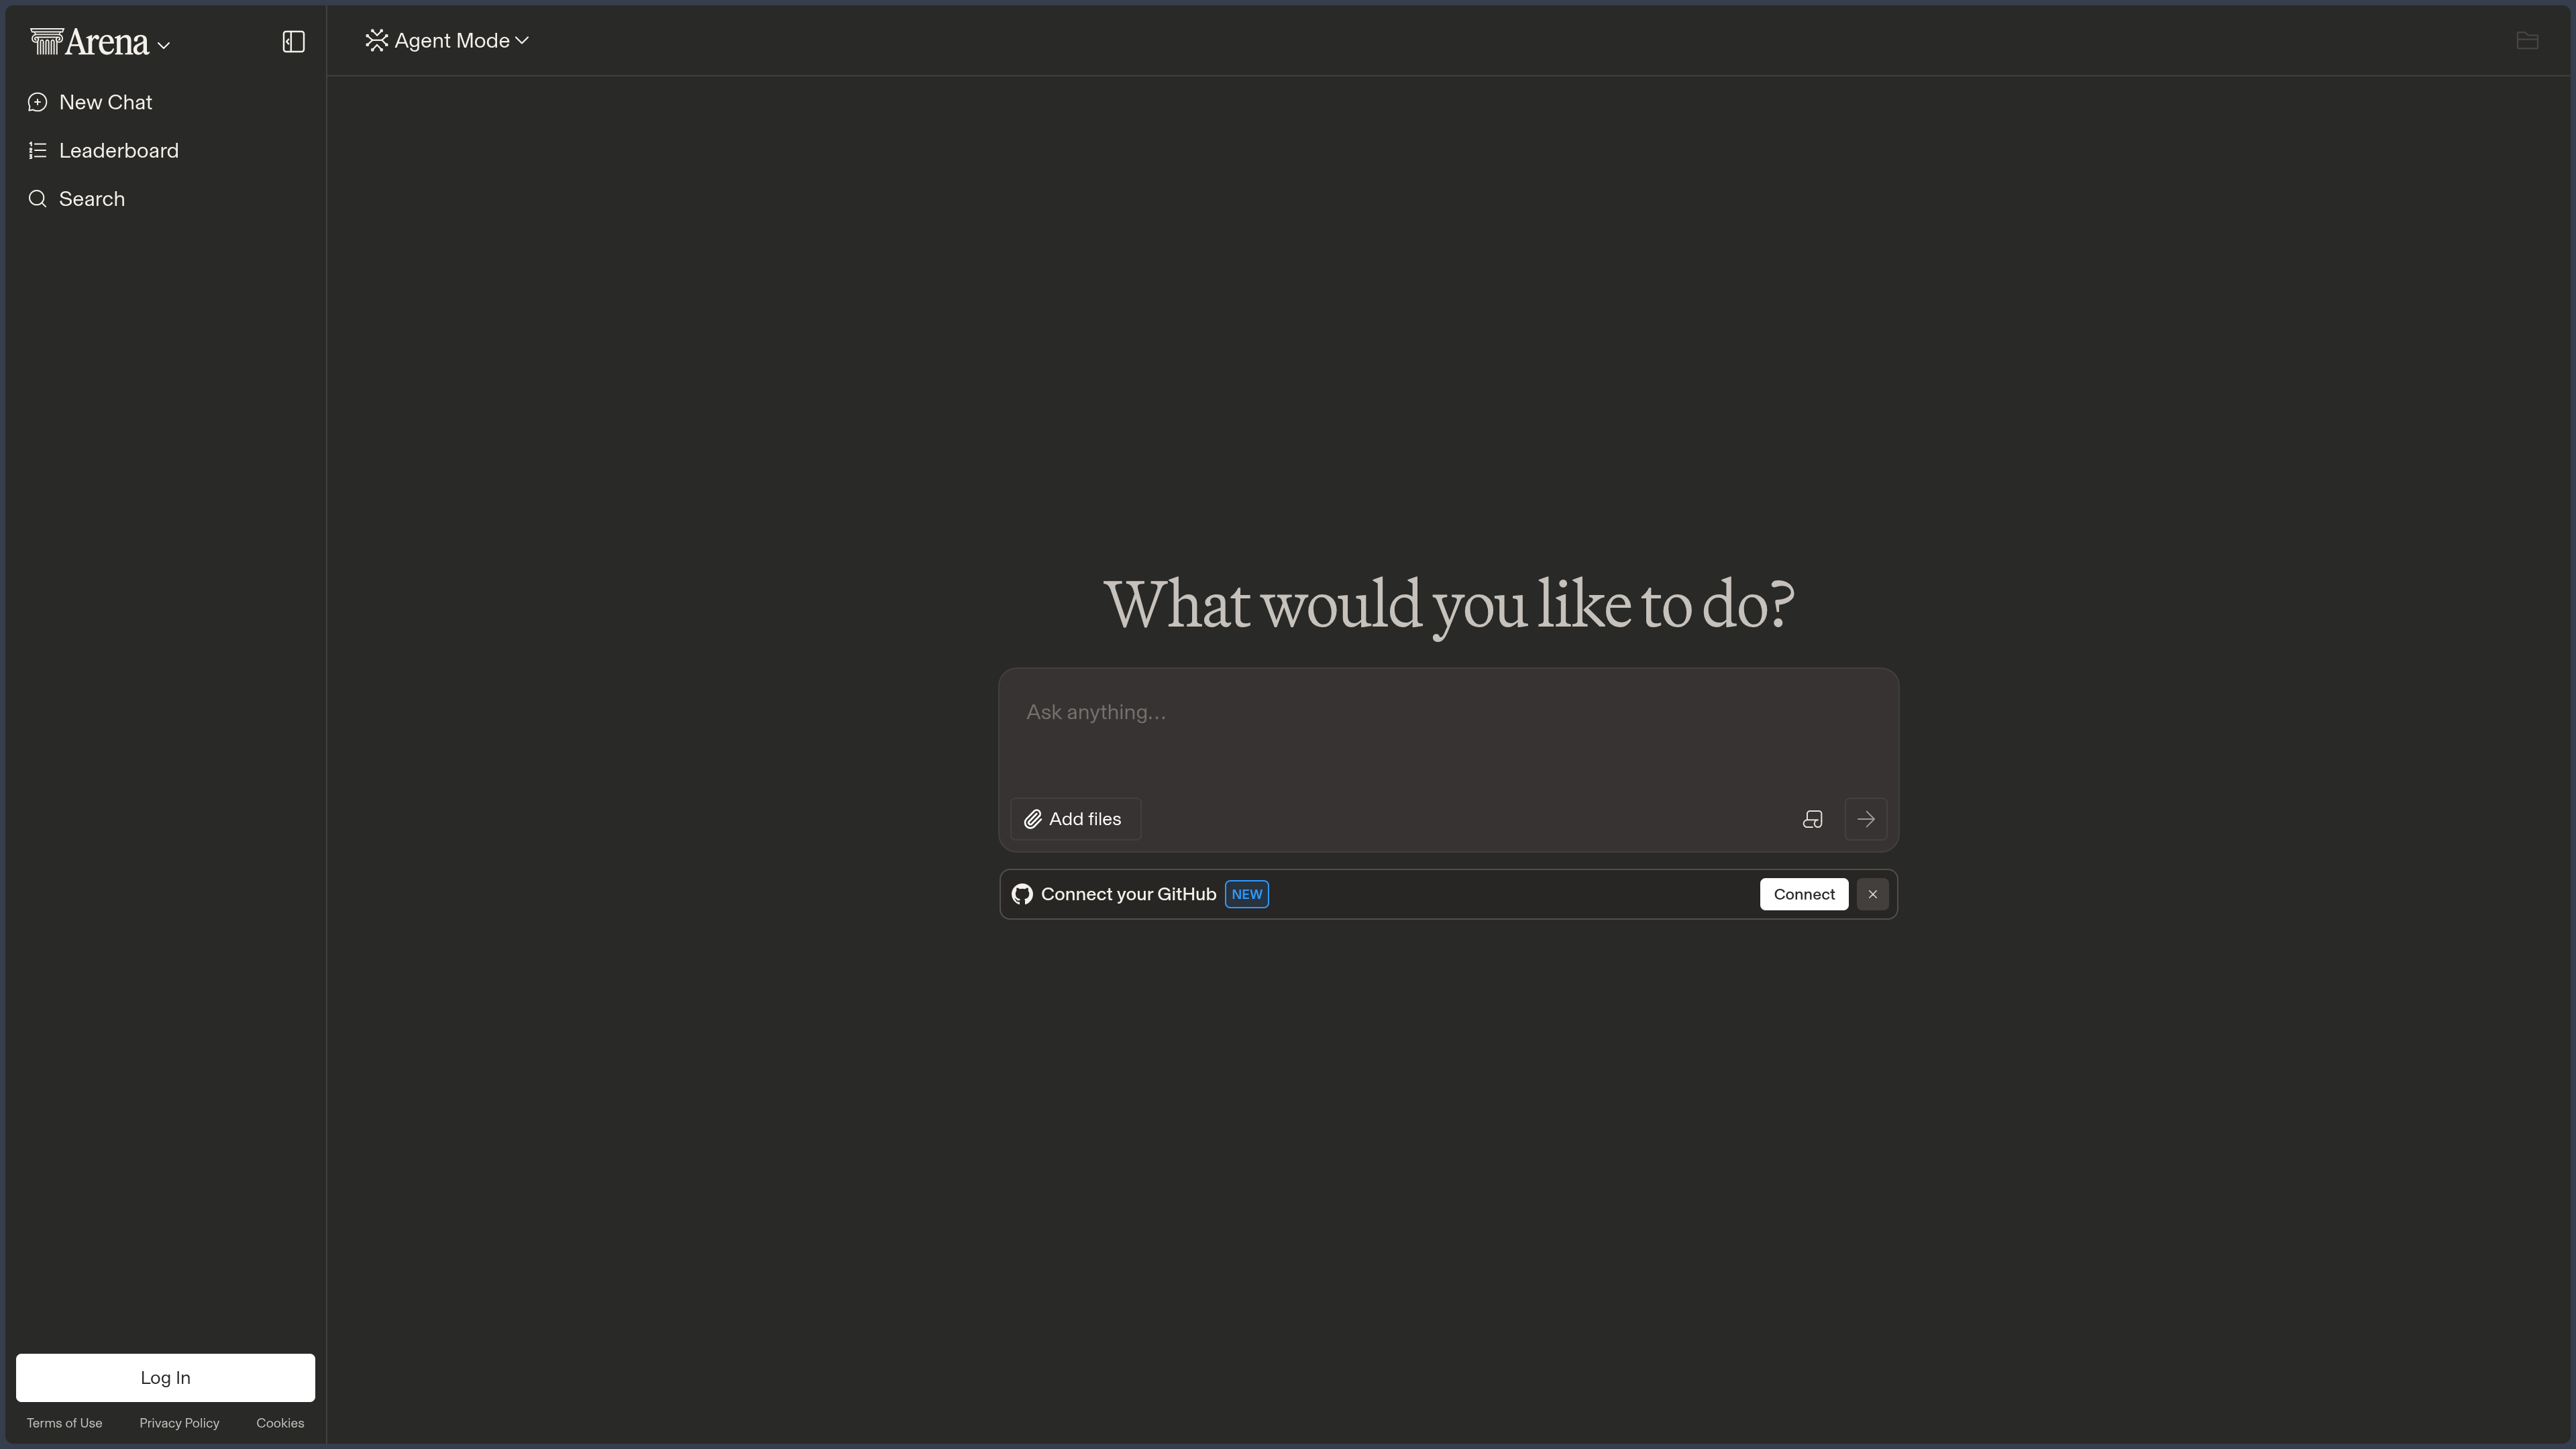
Le mode direct sert à essayer un modèle seul depuis la même plateforme.
Arena s’est progressivement étendu au-delà du texte.
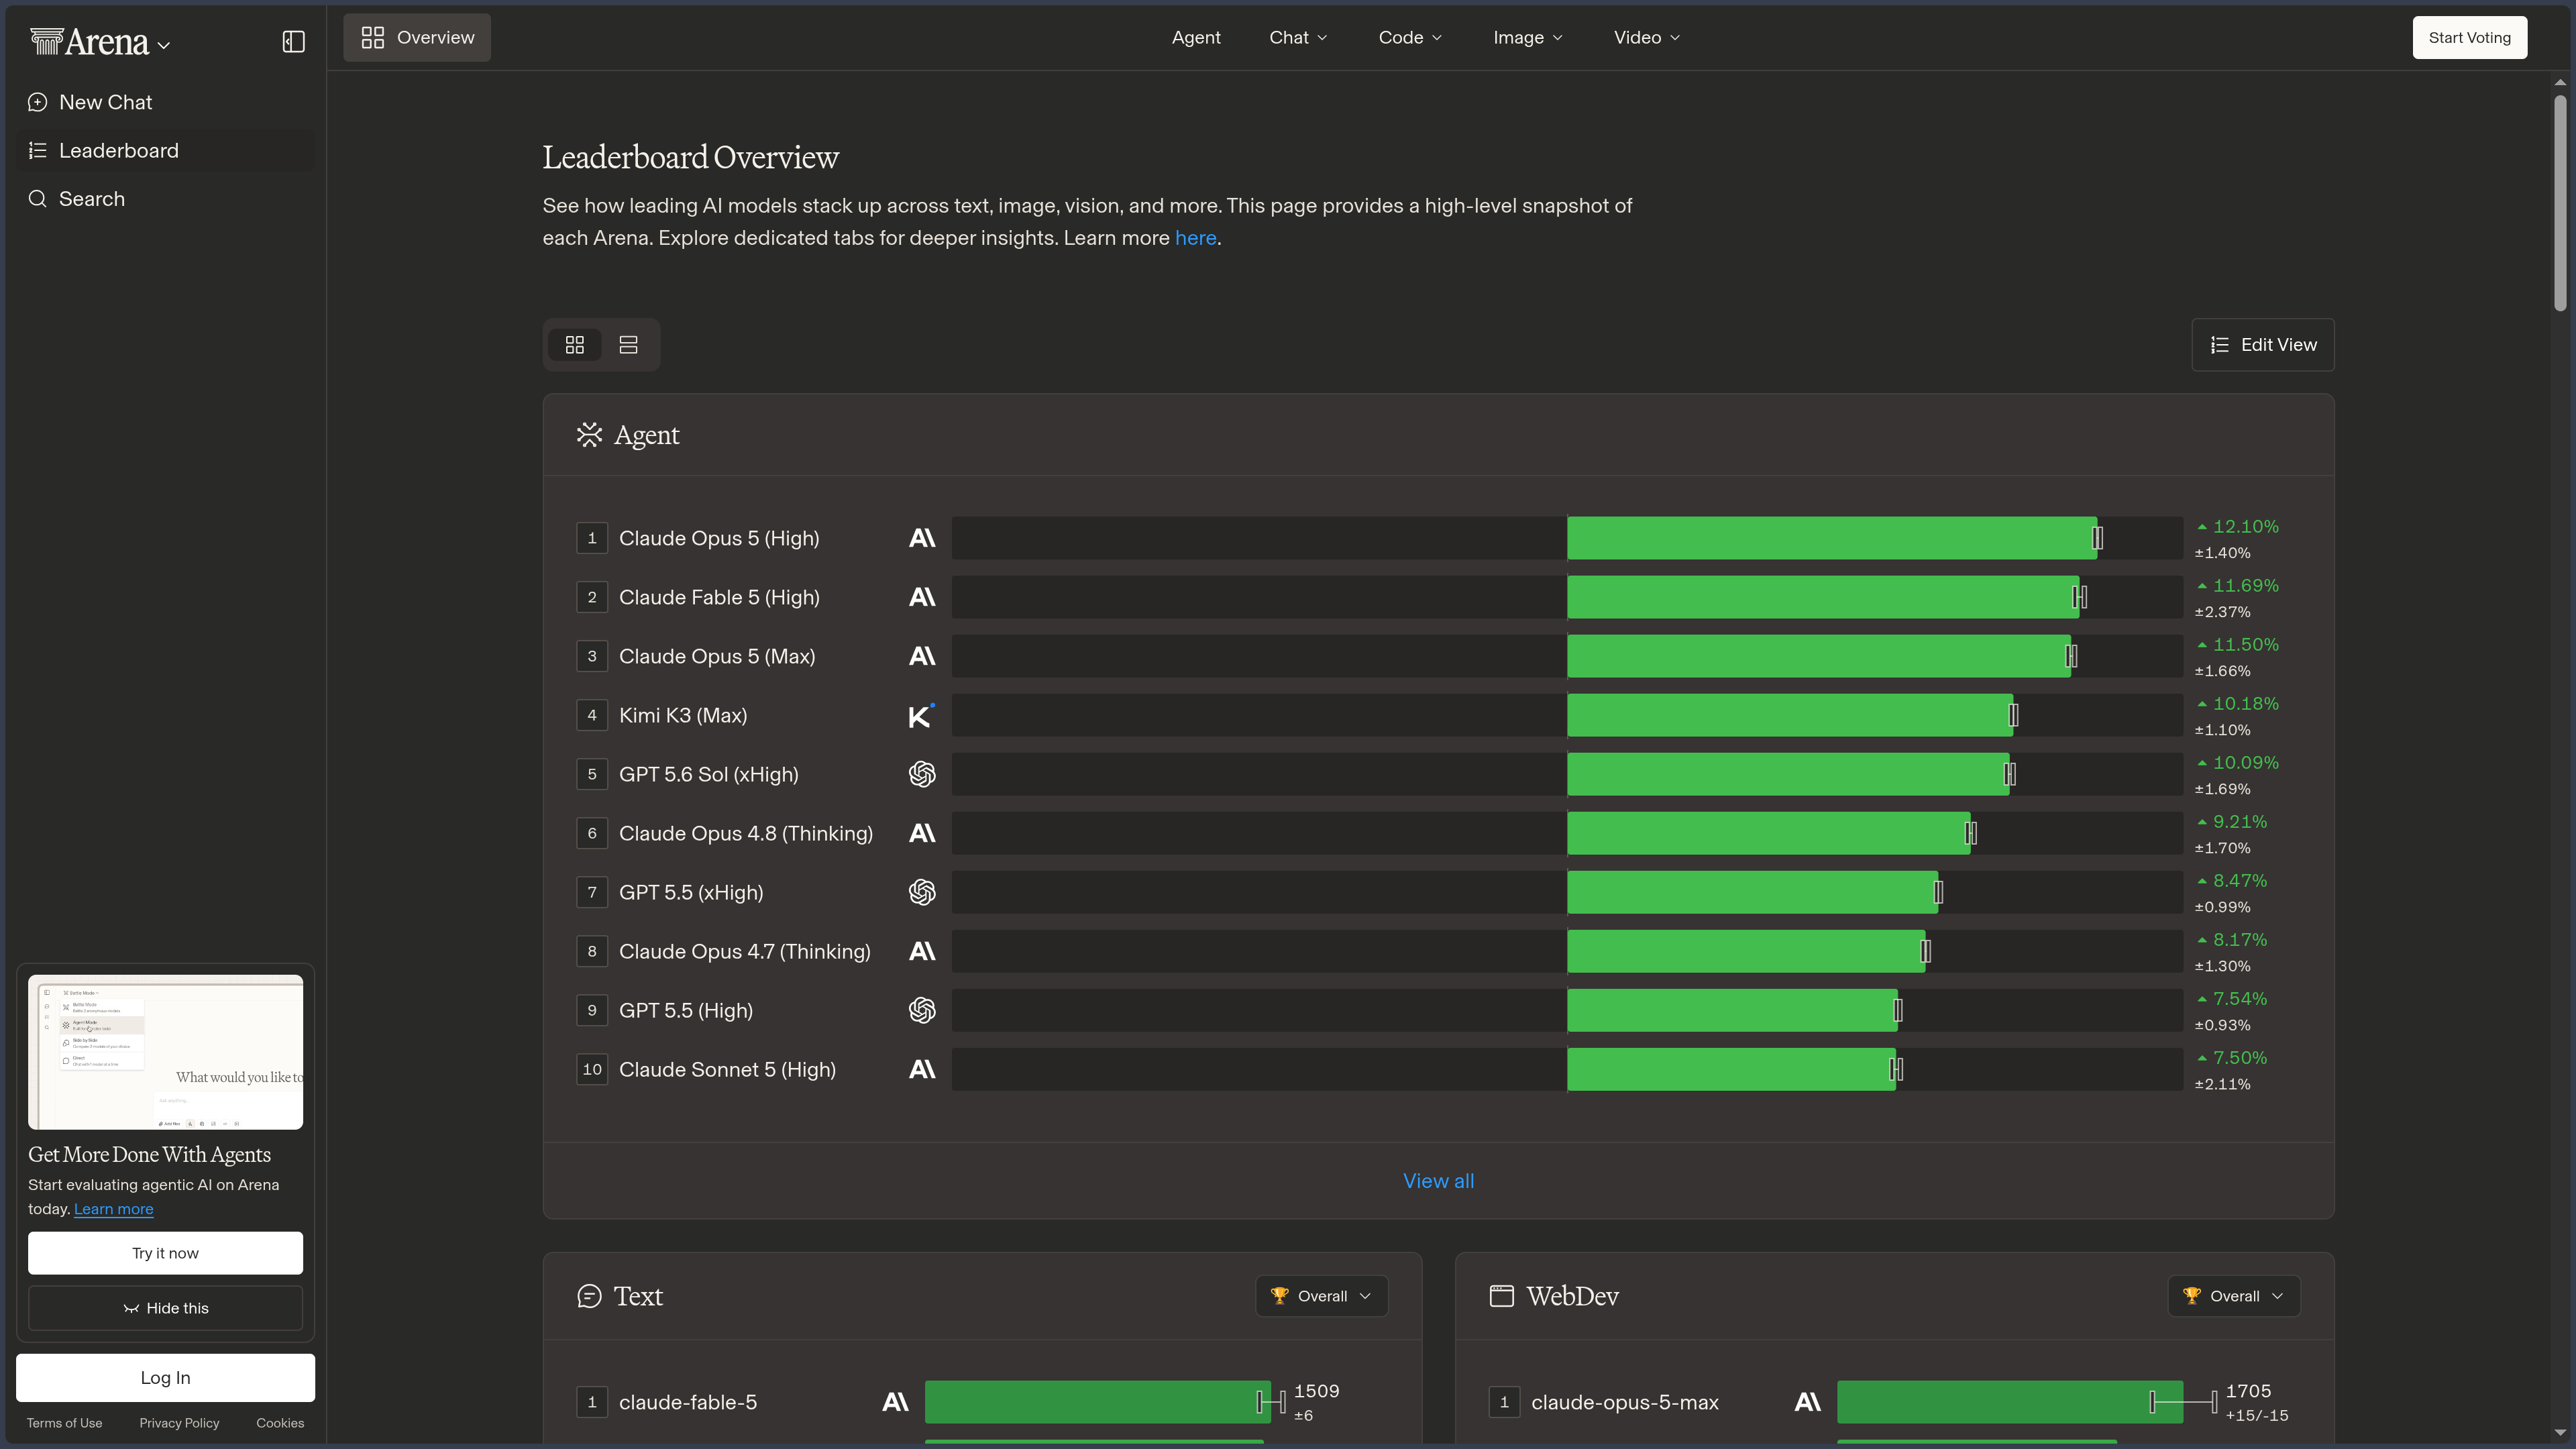
La plateforme compare désormais différentes formes de génération et d’assistance : conversation, code, recherche Web, vision, documents, image, vidéo ou agents.
Cette extension ne change pas son principe fondamental :
mettre plusieurs modèles face au même problème, puis rendre leurs différences visibles.
Arena n’est donc ni un assistant généraliste classique, ni un benchmark académique pur, ni un simple catalogue.
C’est à la fois un laboratoire public de comparaison, une porte d’entrée vers de nombreux modèles et une source de veille sur l’évolution du marché.
Sa valeur vient également de la nature des tâches soumises.
Les benchmarks traditionnels utilisent souvent des jeux de questions conçus à l’avance.
Arena observe des prompts réels envoyés par des utilisateurs réels.
Cette proximité avec les usages donne un signal très intéressant sur la qualité perçue.
Elle introduit aussi davantage de bruit.
Un vote mesure une préférence dans un contexte donné. Il ne transforme pas automatiquement le gagnant en modèle « objectivement meilleur ».
Fonctionnalités
Comparaison anonyme, ciblée et directe
Le cœur d’Arena repose sur trois approches complémentaires :
| Mode | Principe | Intérêt |
|---|---|---|
| Battle | deux modèles anonymes répondent au même prompt | juger avant de connaître la marque |
| Side by Side | deux modèles identifiés sont choisis | comparer précisément deux références |
| Direct | un seul modèle est utilisé | essayer un modèle depuis une interface commune |
Le Battle Mode est le mécanisme le plus caractéristique.
L’anonymisation ne supprime pas tous les biais, mais elle retire au moins l’un des plus évidents : la réputation de la marque.
Une réponse ne reçoit plus automatiquement un avantage simplement parce qu’elle vient d’un modèle connu ou coûteux.
La conversation peut se poursuivre sur plusieurs tours.
Cela permet d’observer non seulement une réponse isolée, mais aussi la conservation du contexte, l’acceptation d’une correction, la capacité à maintenir des contraintes ou la manière dont un modèle réagit lorsqu’on remet sa première réponse en question.
Le Side by Side est plus adapté lorsque l’on hésite déjà entre deux modèles précis.
Le Direct Mode sert davantage à découvrir rapidement une référence sans ouvrir immédiatement un compte chez son fournisseur.
Arena ne reproduit cependant pas toujours l’expérience officielle d’un éditeur.
System prompt, paramètres, mémoire, connecteurs, outils, contexte disponible ou filtres peuvent différer.
Une comparaison dans Arena doit donc être considérée comme un test du modèle dans les conditions d’Arena, pas comme une reproduction parfaite de son produit officiel.
Arènes spécialisées
Un classement général devient vite trompeur lorsqu’on oublie que les modèles ne brillent pas tous sur les mêmes tâches.
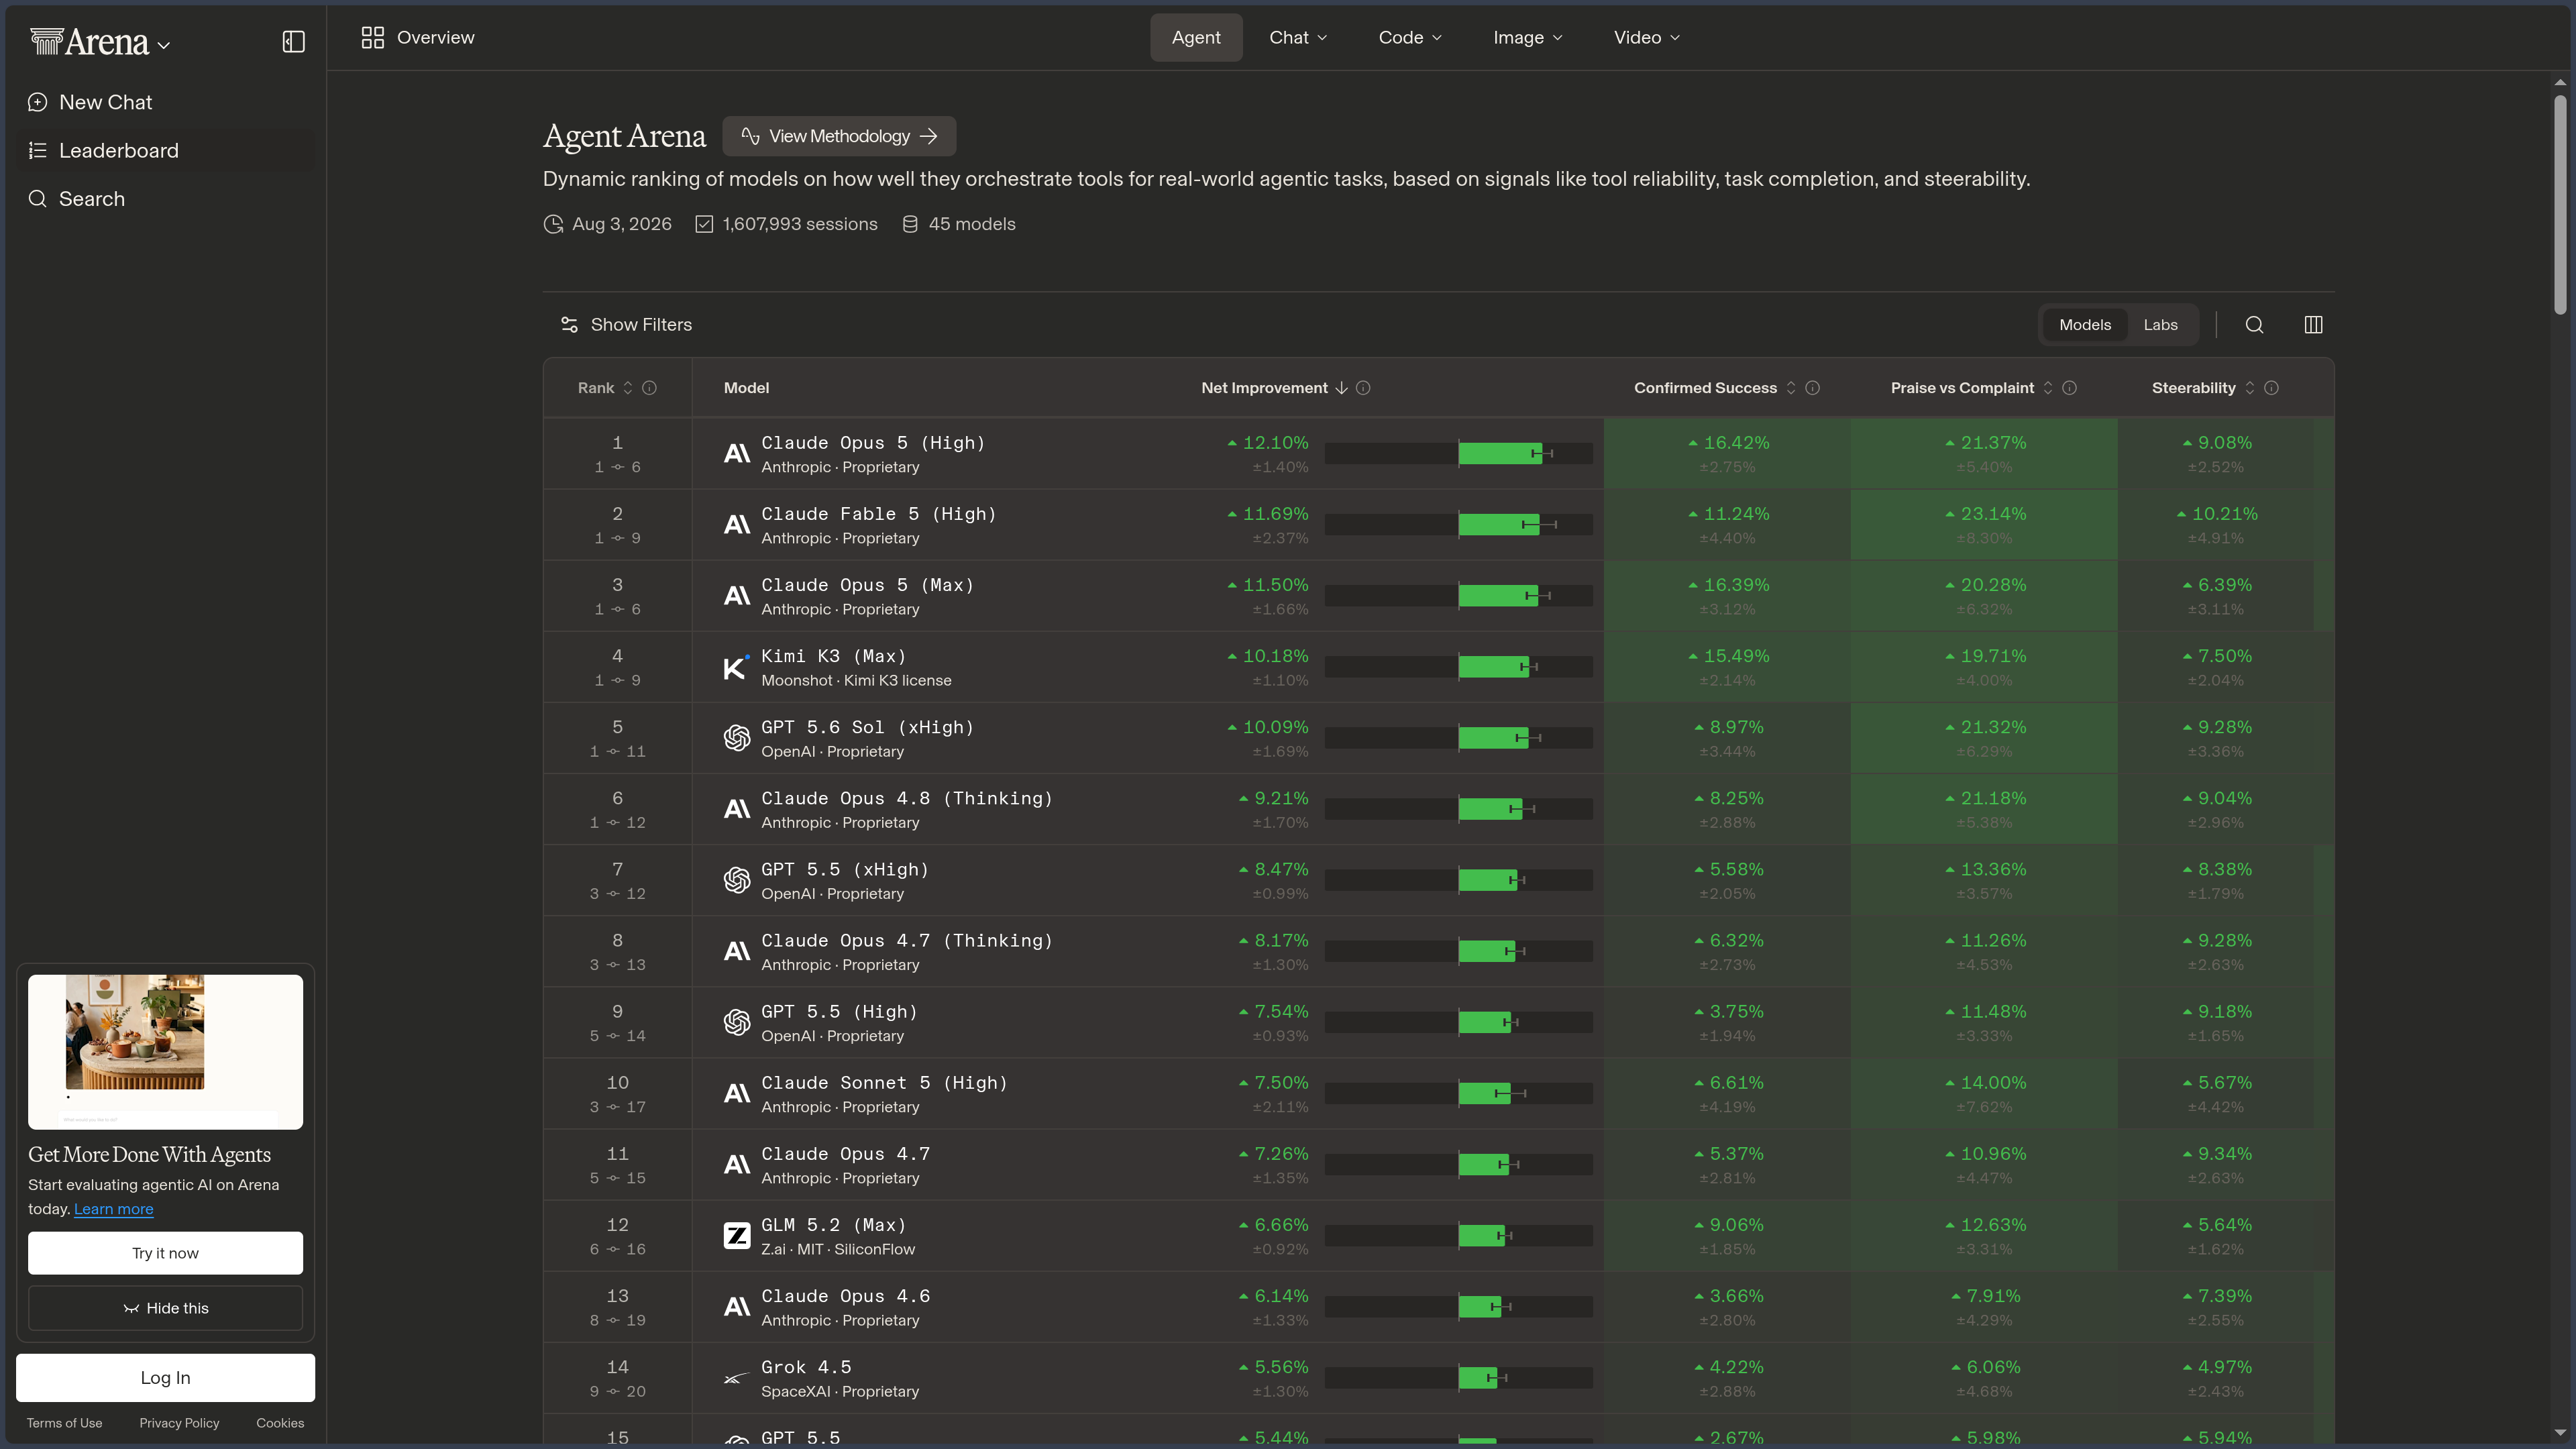
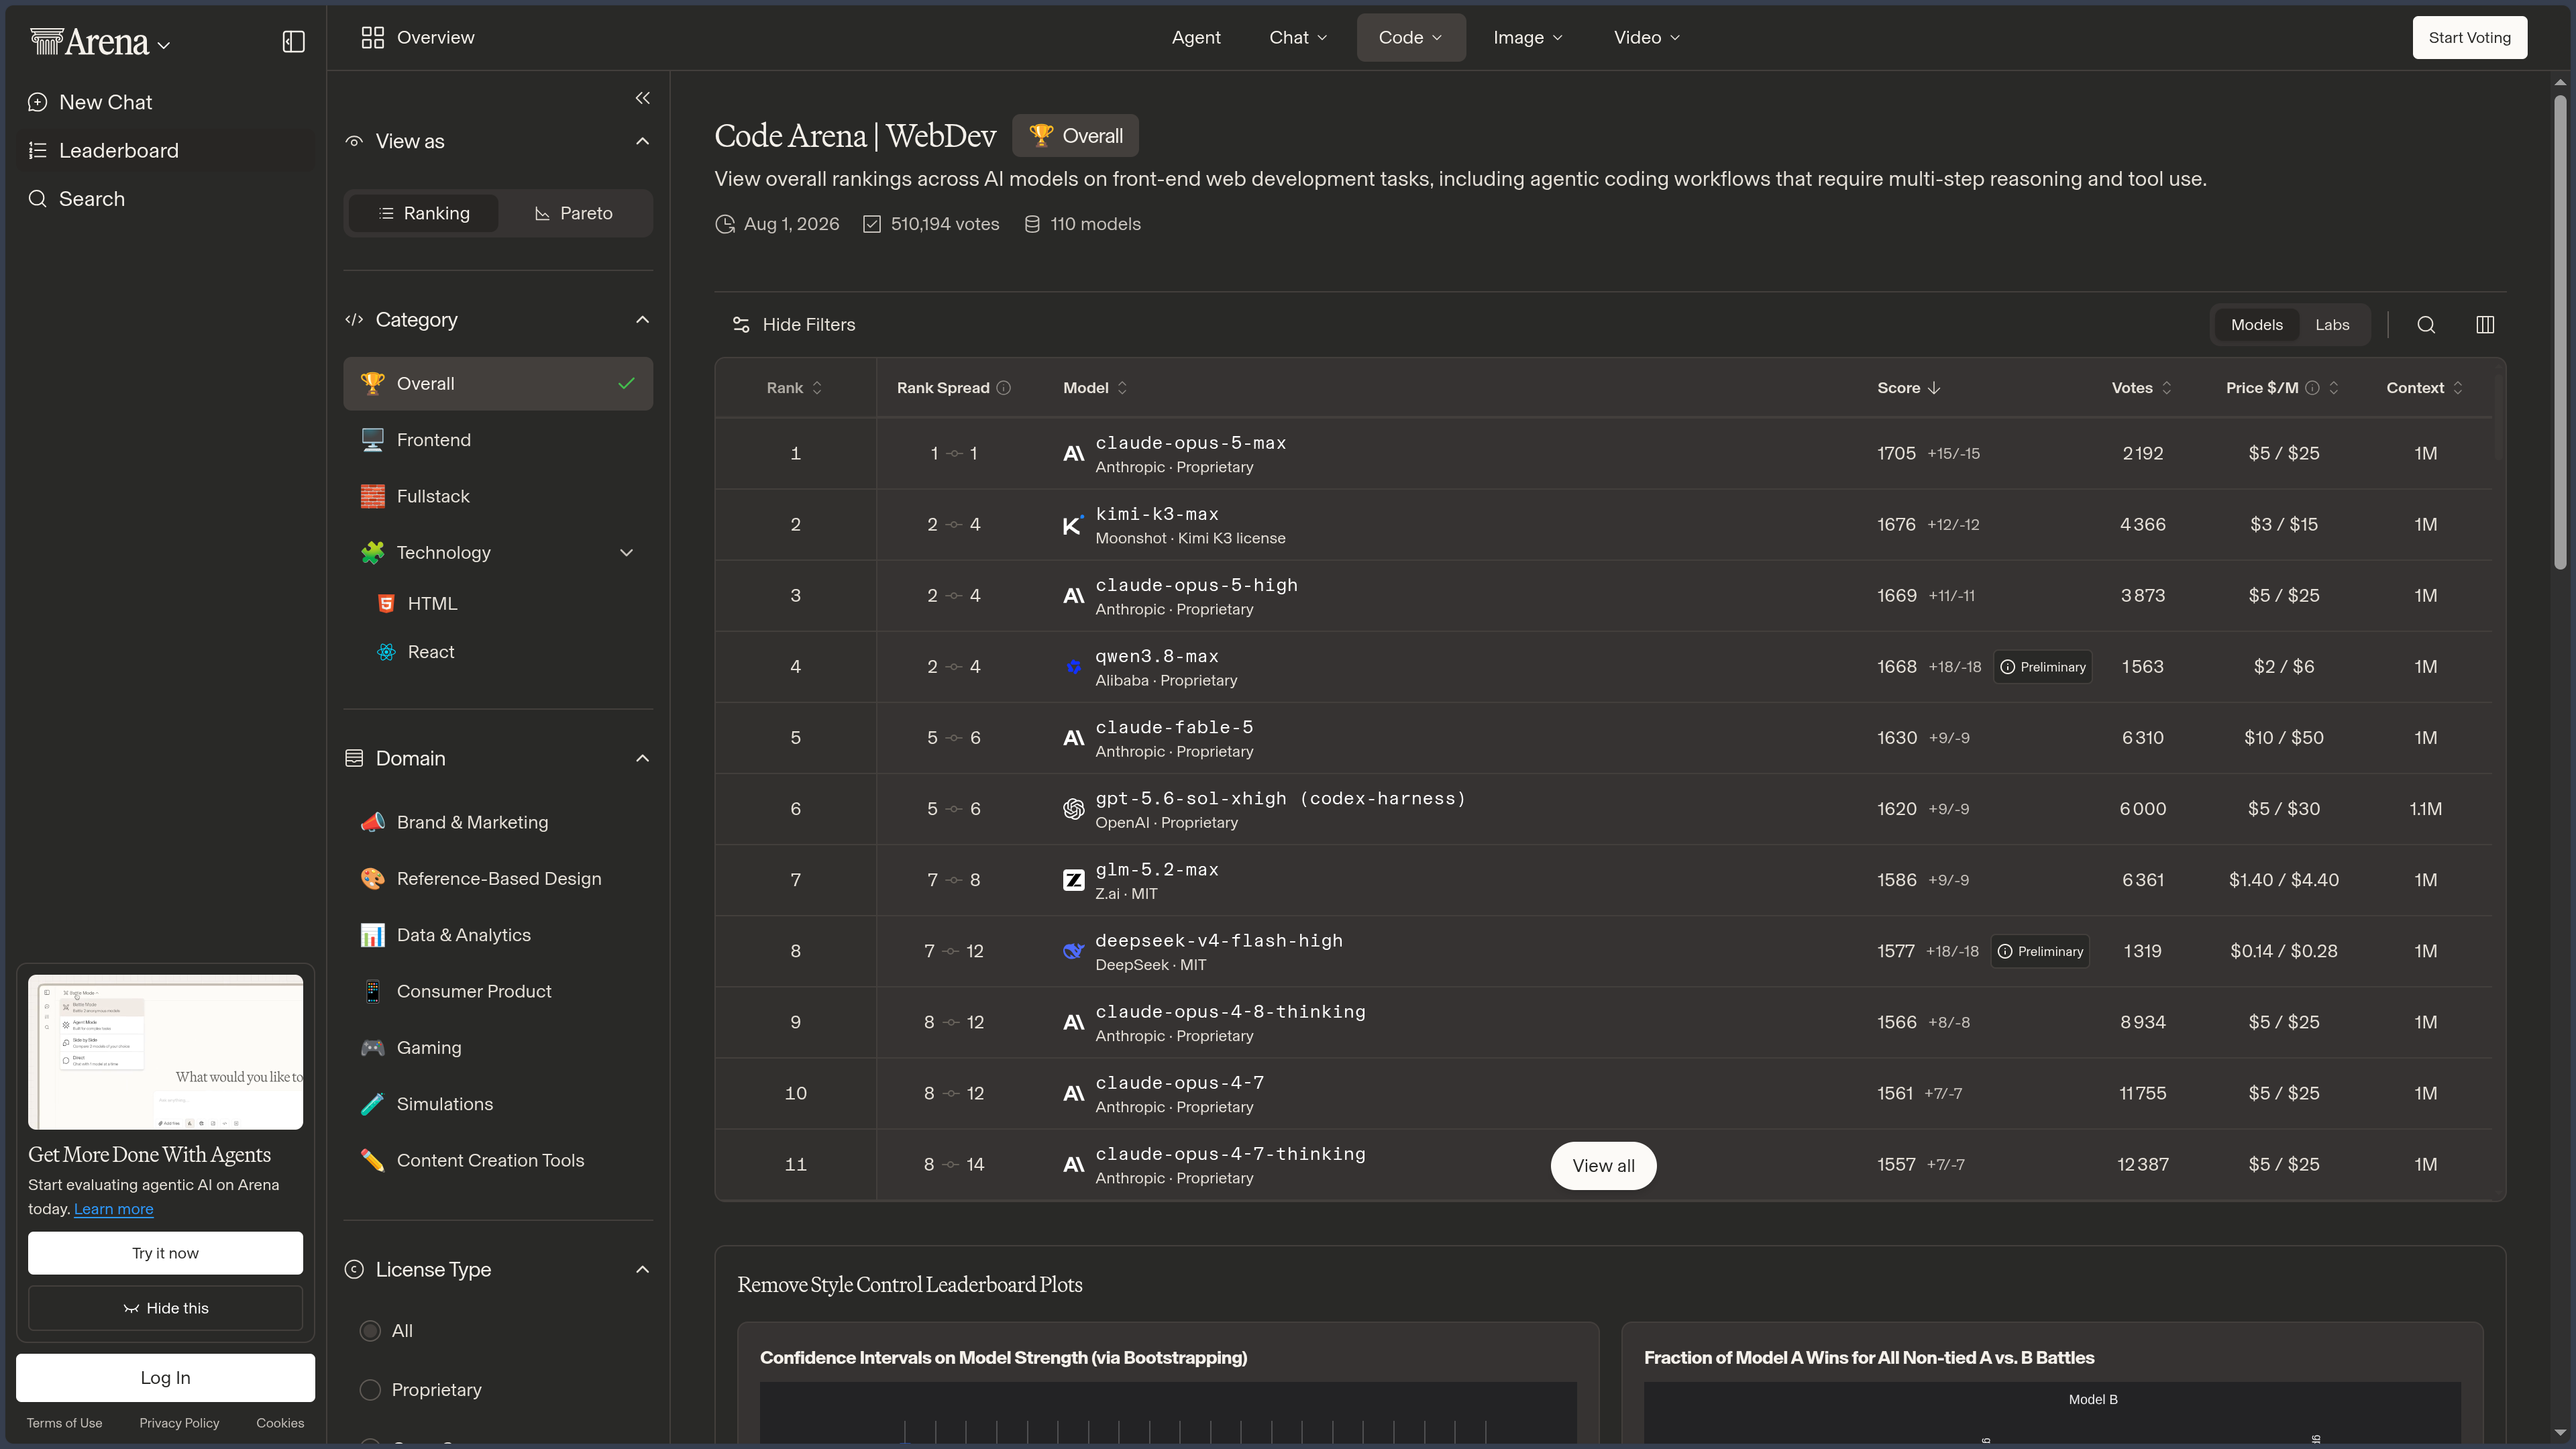
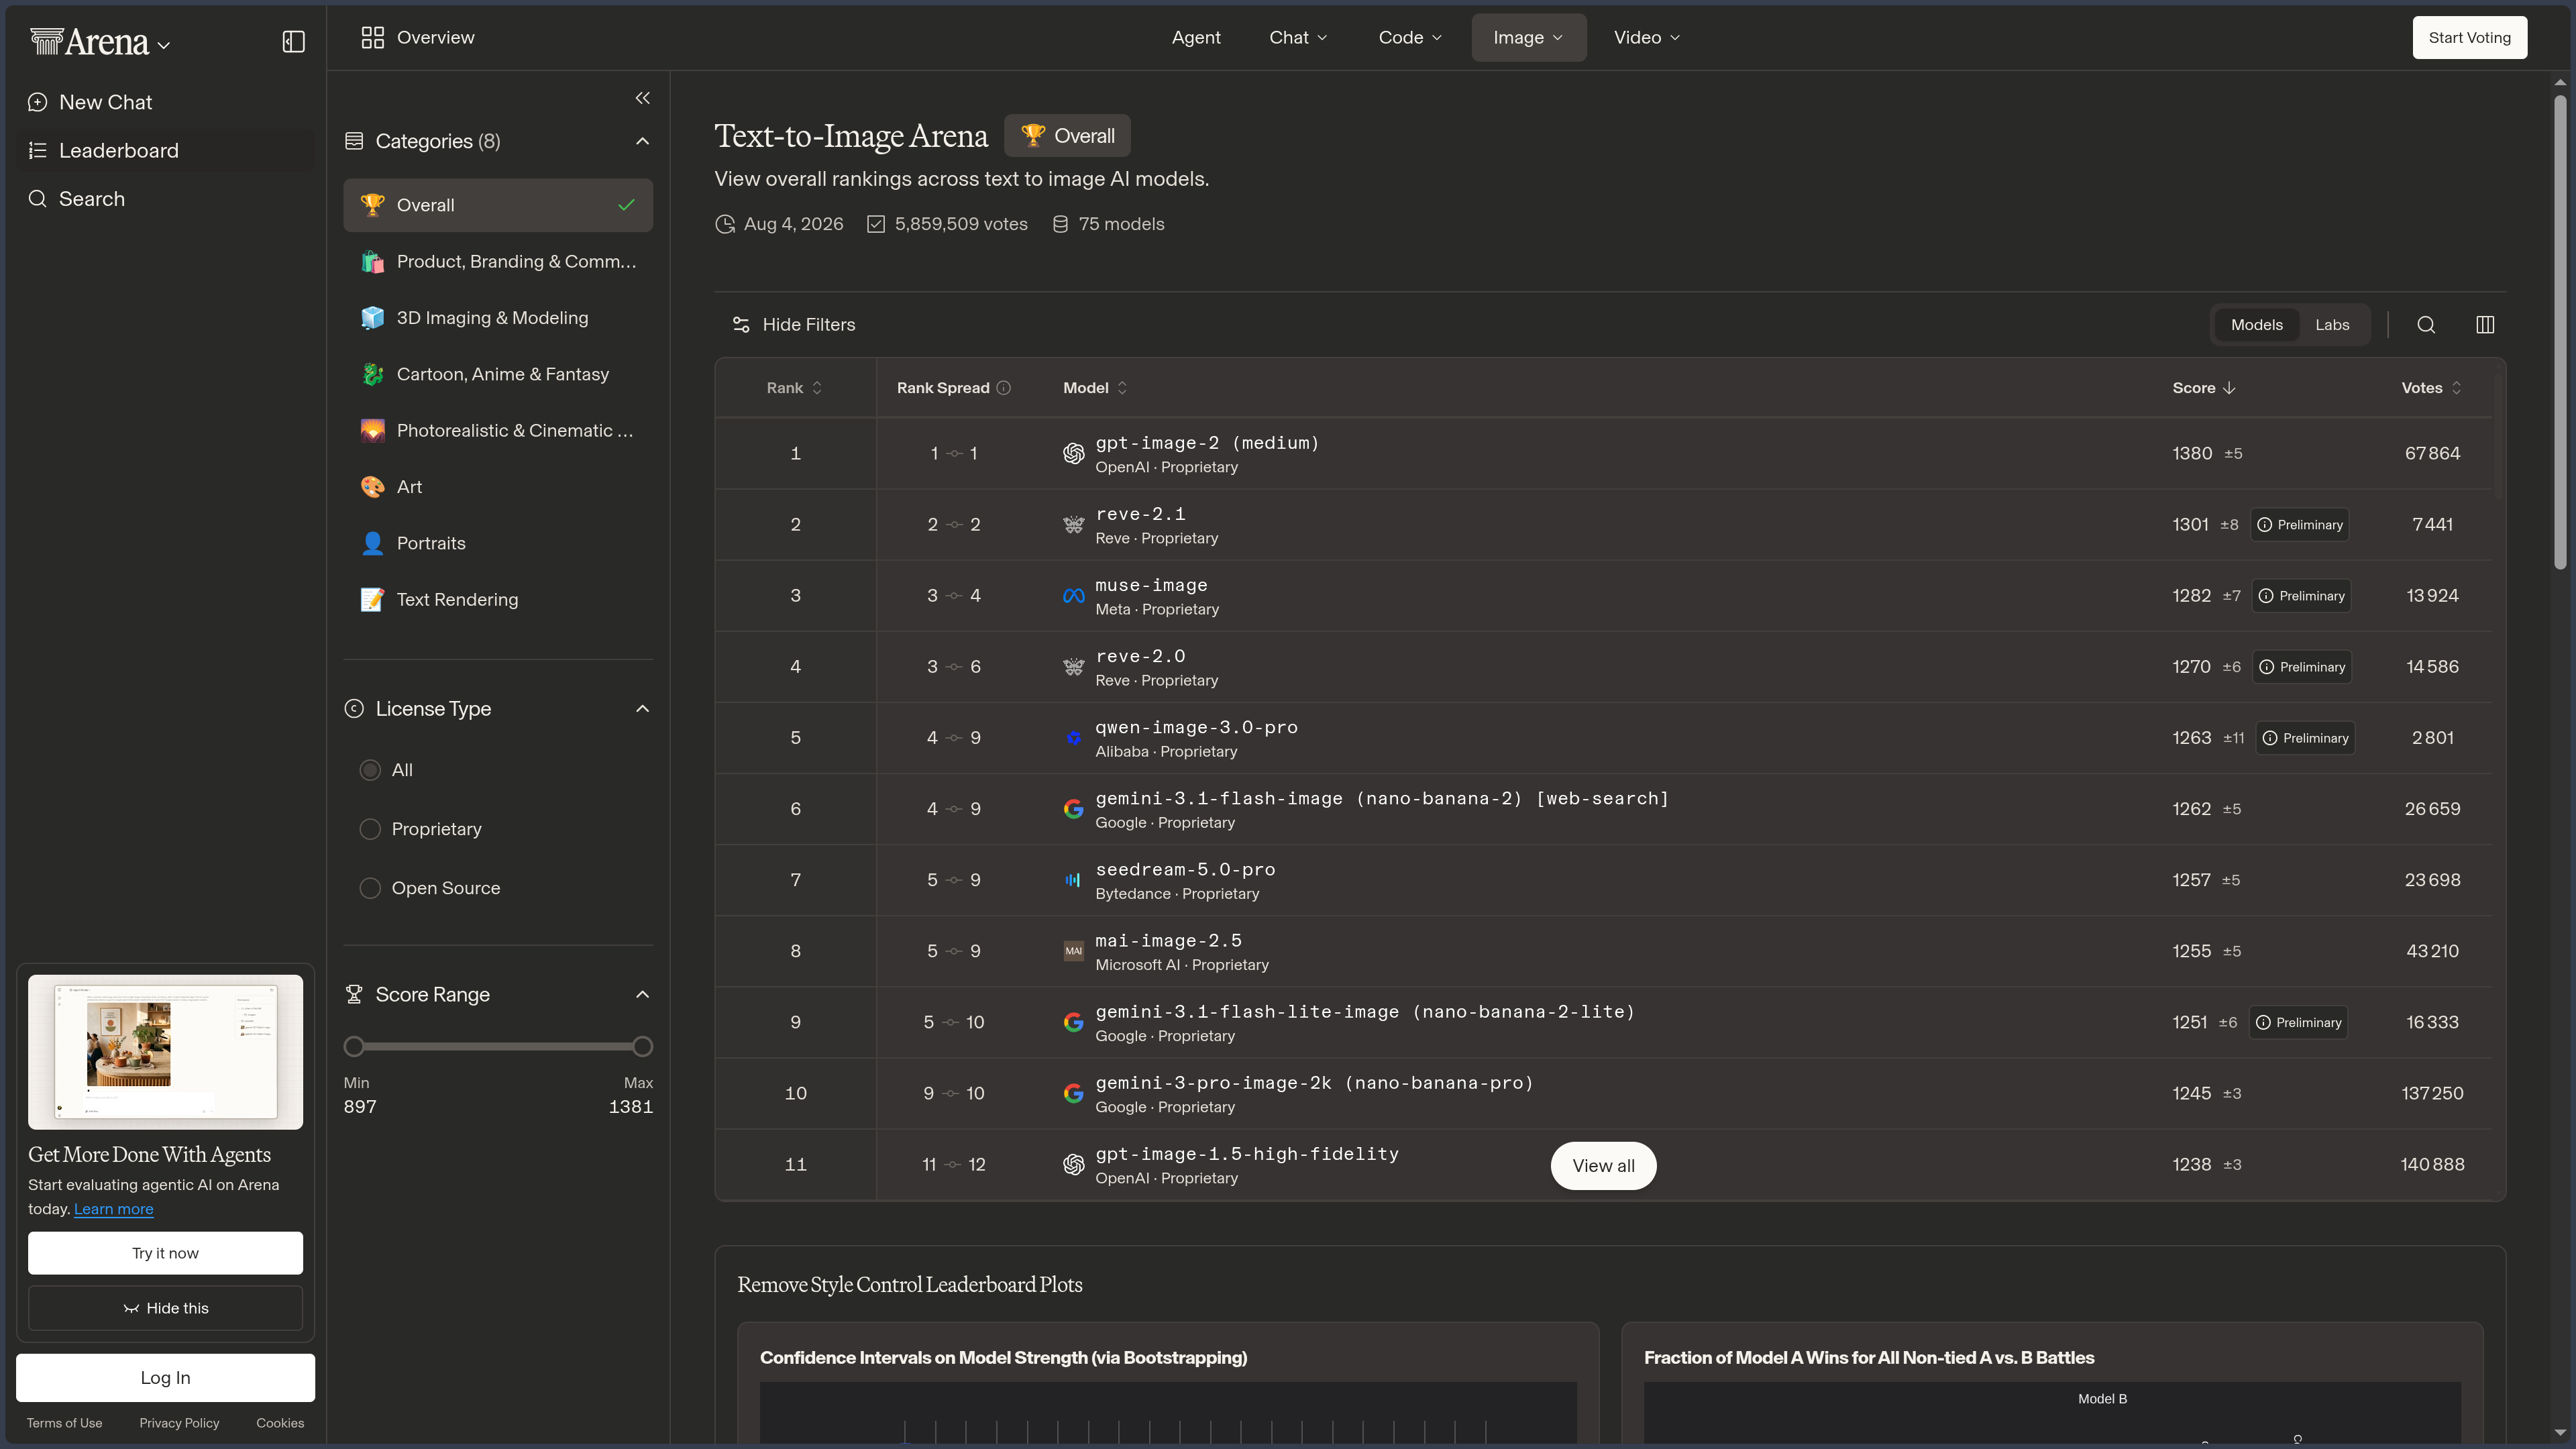
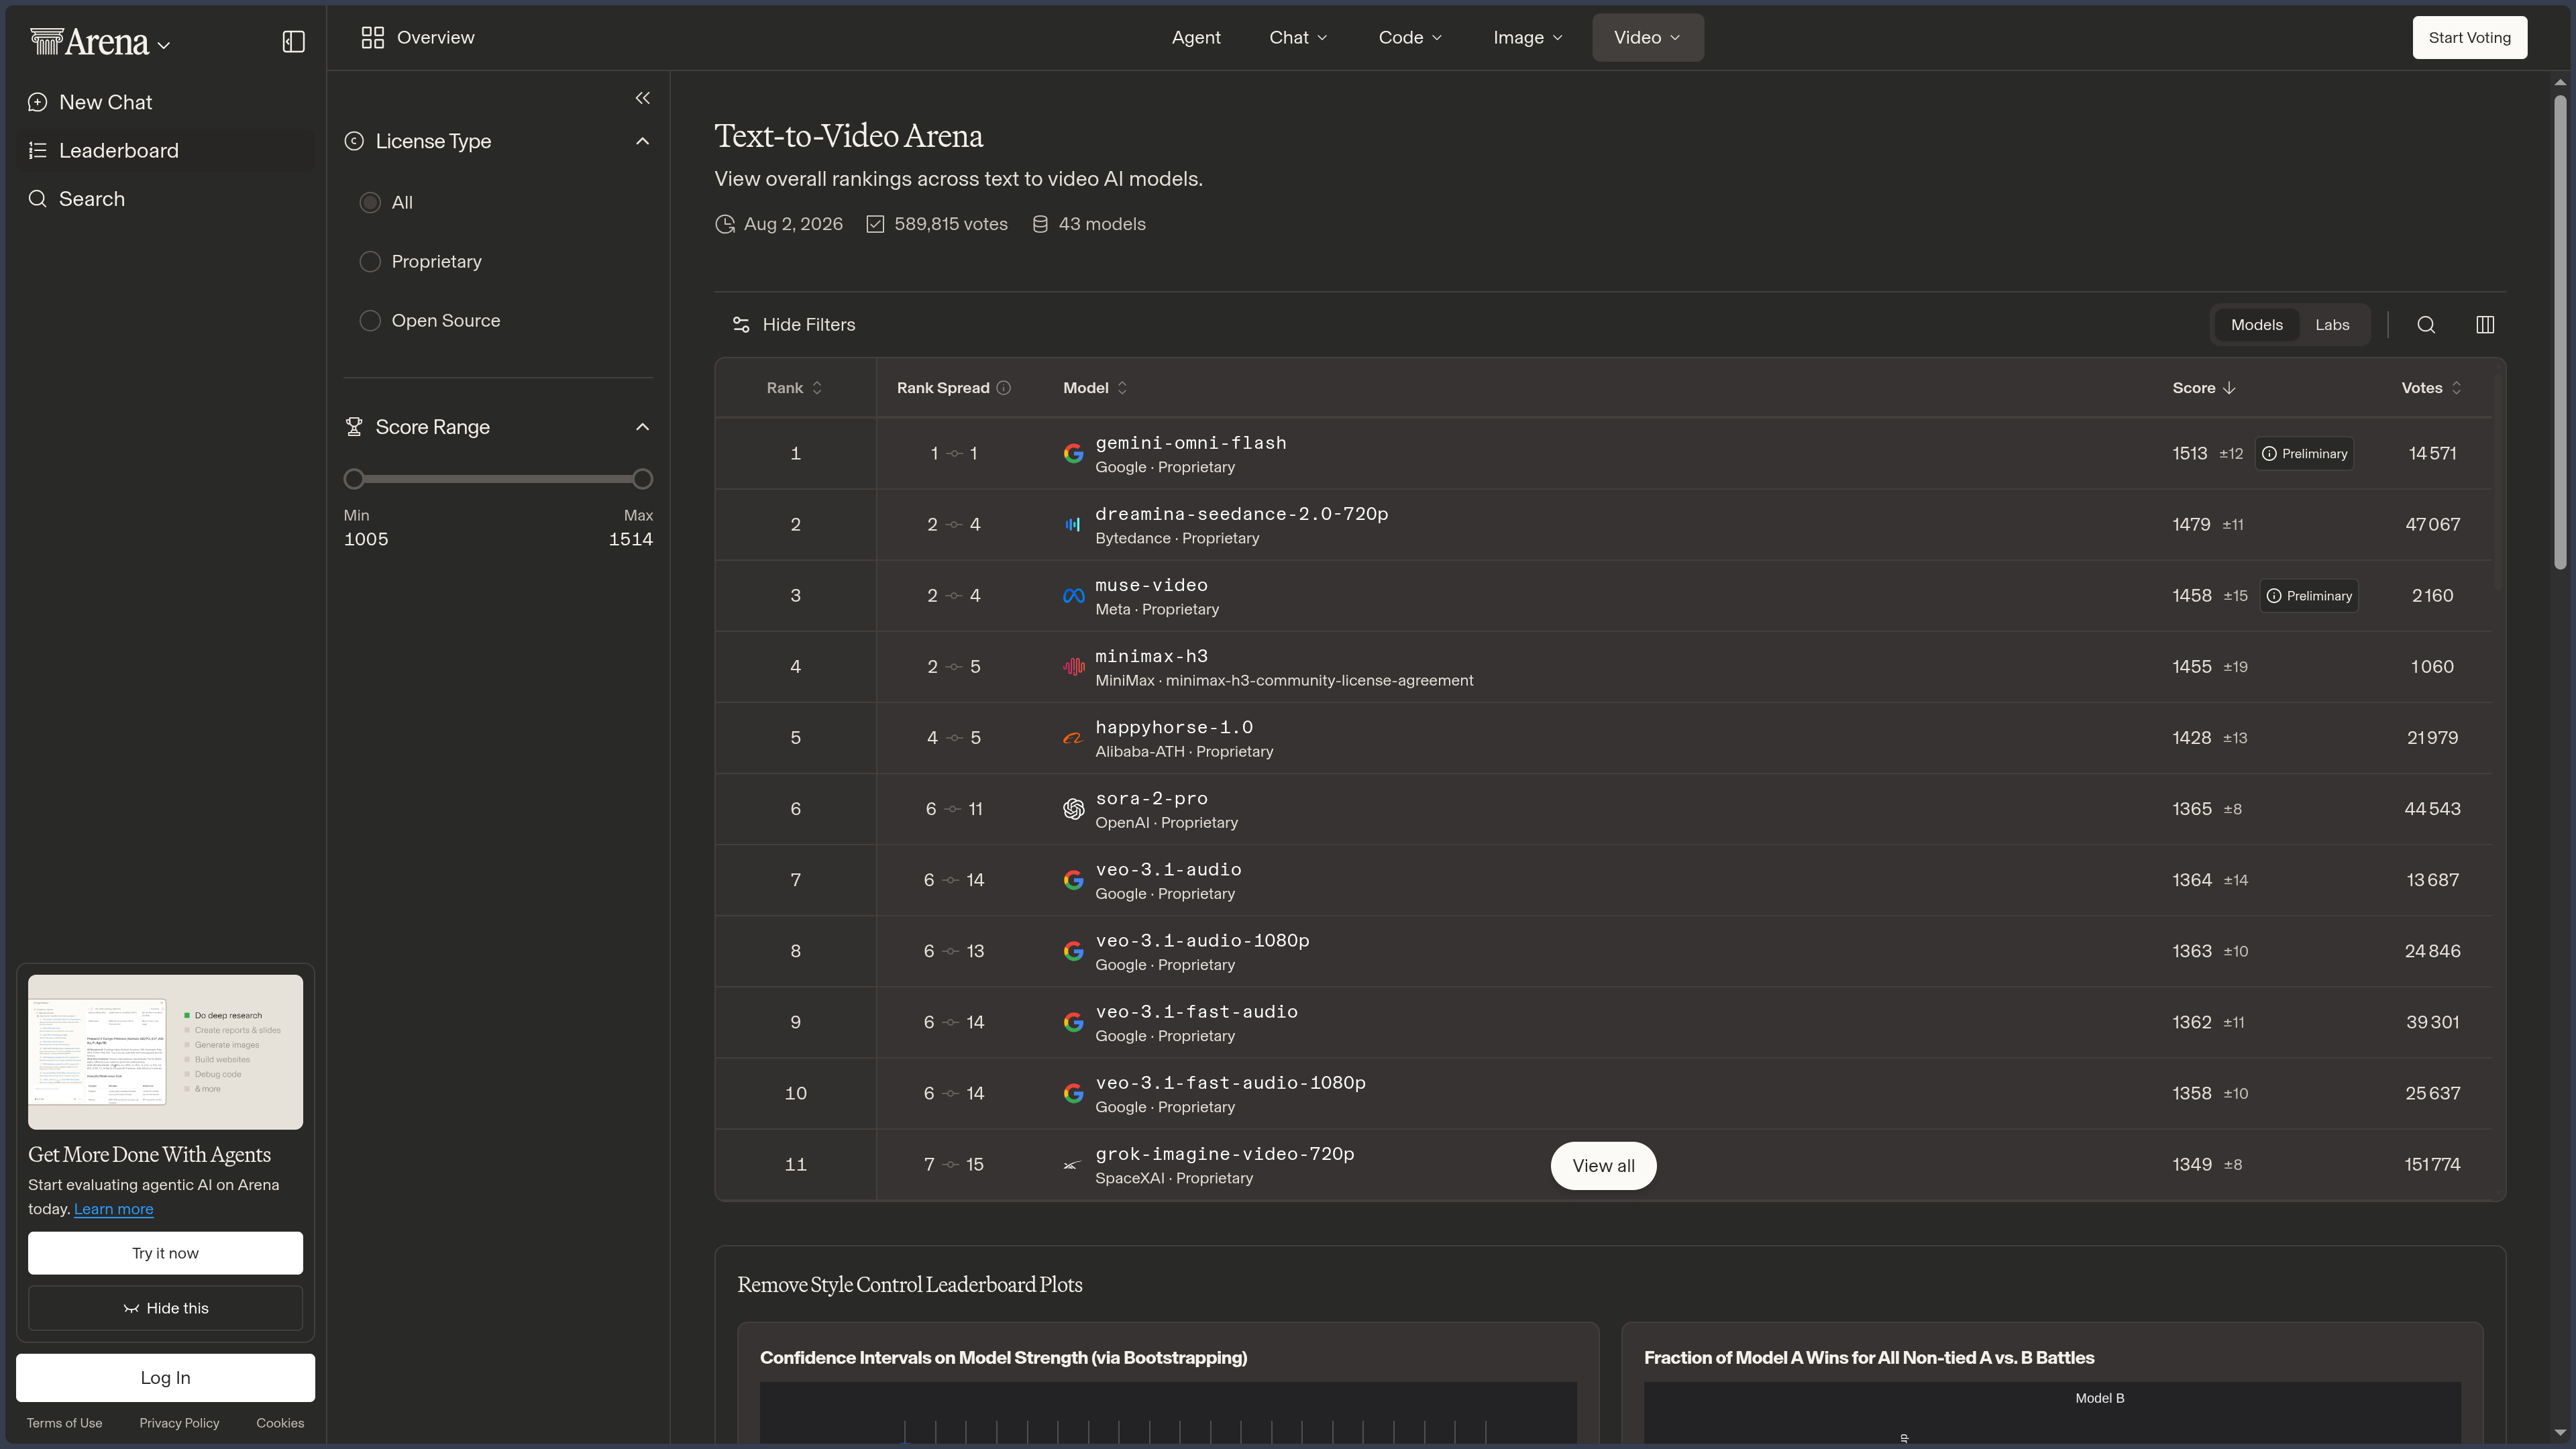
Arena sépare donc plusieurs modalités : texte, code, recherche, vision, documents, génération d’images, vidéo ou agents.
Cette organisation permet de poser une meilleure question que :
« Quel est le meilleur modèle ? »
La vraie question devient :
« Quel modèle est le plus convaincant pour cette tâche précise ? »
Cette nuance est particulièrement importante pour les modèles créatifs.
Deux générateurs d’images peuvent être excellents sur des critères complètement différents : respect du prompt, composition, texte dans l’image, cohérence d’un personnage ou style.
Même chose pour la vidéo, le code ou la recherche Web.
Un classement spécialisé aide donc à éviter l’idée d’un modèle universellement supérieur.
Classements, votes et incertitude
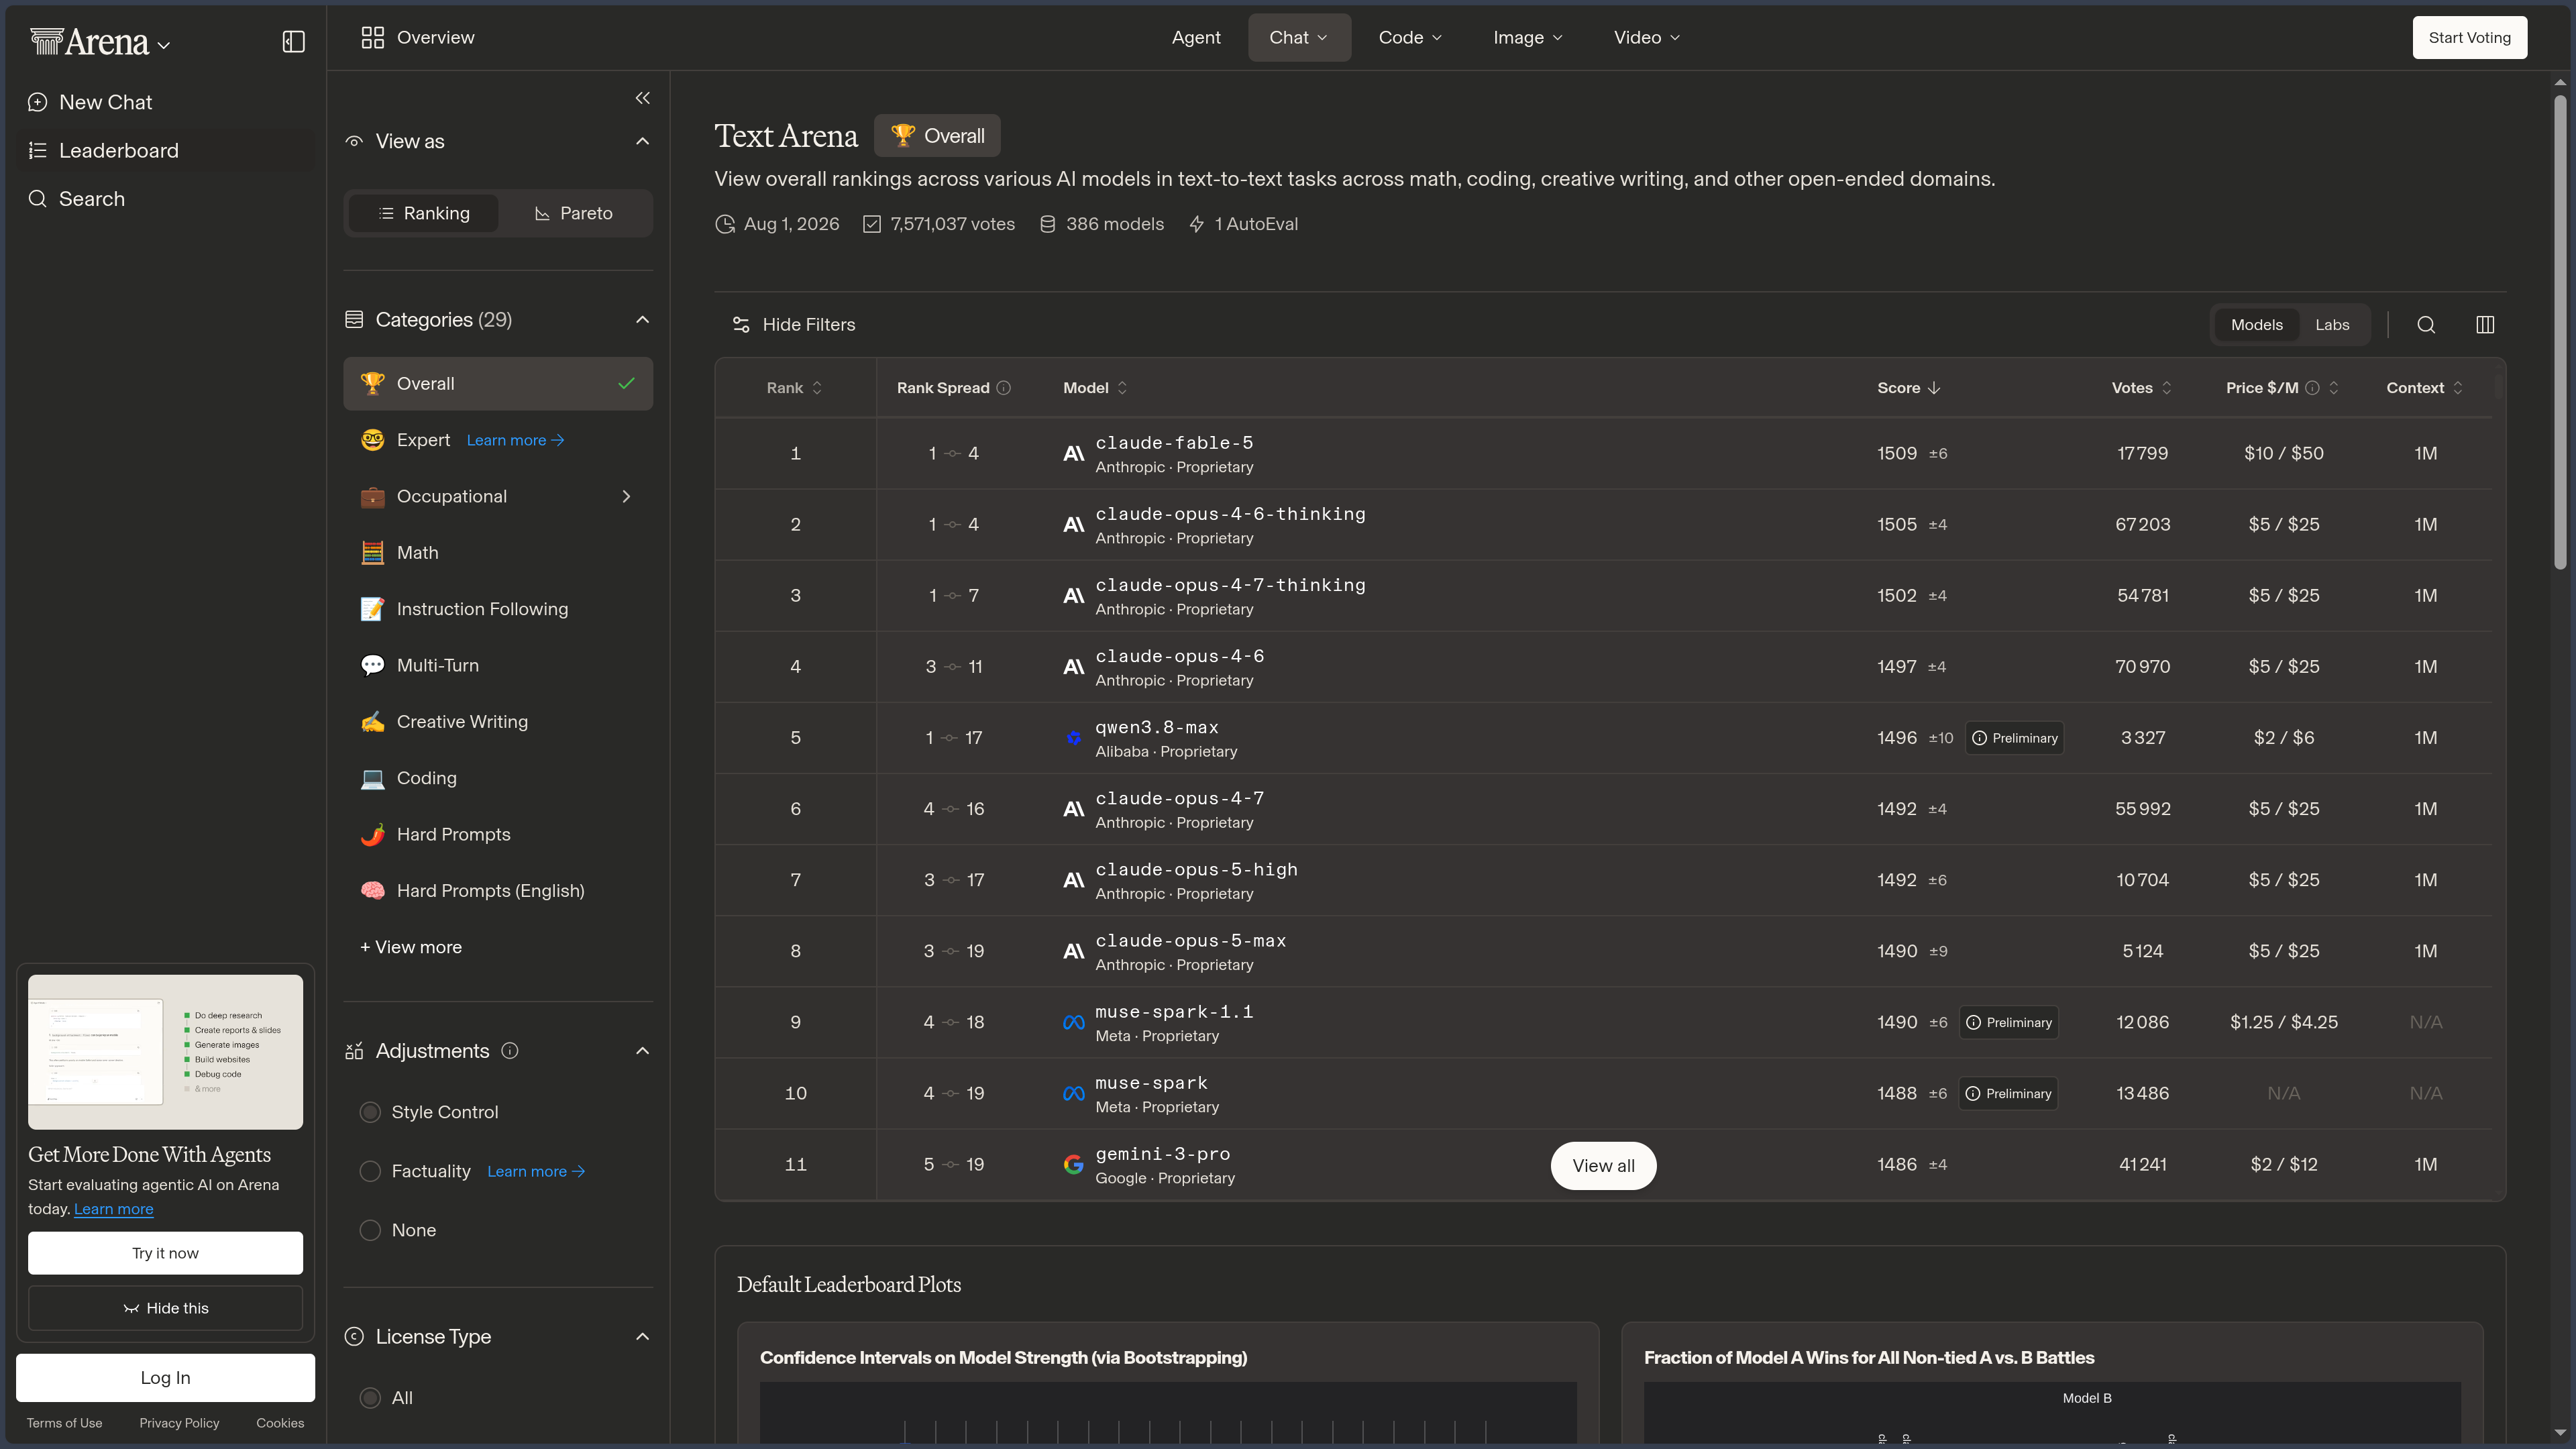
Les votes alimentent des classements relatifs.
Arena fournit plusieurs indicateurs destinés à éviter une lecture trop simpliste du rang : volume de votes, plages probables de position, intervalles de confiance ou classements spécialisés.
Ces informations sont essentielles.
Deux modèles séparés de plusieurs places peuvent parfois être statistiquement très proches.
À l’inverse, un classement obtenu sur peu de votes doit être considéré avec davantage de prudence.
Les résultats peuvent également évoluer lorsque :
- un modèle change ;
- de nouvelles versions apparaissent ;
- les usages des utilisateurs évoluent ;
- une arène reçoit davantage de votes ;
- certaines catégories deviennent plus populaires.
Le classement est donc une photographie mouvante, pas une certification permanente.
Routage et accès aux modèles
Arena propose également des mécanismes capables de choisir automatiquement un modèle en fonction de la tâche.
Cette logique de routage est intéressante parce qu’elle renverse le problème.
L’utilisateur n’a plus nécessairement besoin de connaître les forces de dizaines de modèles.
Le système peut tenter de choisir une référence adaptée.
La contrepartie est une couche d’opacité supplémentaire : le modèle choisi peut varier selon performances observées, disponibilité ou latence.
L’autre intérêt pratique d’Arena est l’accès à de nombreux modèles depuis une interface commune.
Pour découvrir une nouvelle référence, cela évite d’ouvrir immédiatement un compte ou un abonnement chez chaque fournisseur.
Recherche, méthodologie et ouverture partielle
Arena ne se contente pas d’afficher des résultats.
Une partie de sa méthodologie, de ses travaux de recherche et de ses données est publiée.
Des composants liés au calcul des classements sont également accessibles sous licence ouverte.
Cette transparence permet aux chercheurs et développeurs de comprendre davantage la logique d’agrégation des votes et les limites de l’évaluation.
Elle ne signifie pas que l’ensemble du service Web, des données, des modèles ou de l’infrastructure est open source.
L’ouverture est donc méthodologique et partielle, pas totale.
Cas d’usage
Tester un modèle avant de l’adopter
Arena permet de soumettre à un nouveau modèle des demandes proches de son propre travail, puis de comparer ses réponses à celles de références déjà connues.
C’est souvent plus instructif qu’une démonstration officielle soigneusement sélectionnée.
Comparer des modèles pour l’écriture ou la recherche
Une même consigne éditoriale peut révéler des différences de ton, de précision, de respect des contraintes ou de créativité.
Pour une recherche Web, la comparaison peut porter sur la qualité des sources, la couverture du sujet ou la prudence de la synthèse.
Explorer les modèles créatifs
Image Arena, Video Arena et les espaces consacrés au code permettent d’observer directement plusieurs résultats produits à partir du même brief.
Cette confrontation est utile pour évaluer une direction artistique ou un prototype sans dépendre des galeries promotionnelles des éditeurs.
Tester la tenue sur plusieurs tours
Une comparaison peut se poursuivre pour vérifier si un modèle conserve des contraintes, accepte une correction ou reste cohérent après plusieurs échanges.
Construire une veille sur l’IA
Les classements spécialisés donnent une photographie mouvante du paysage des modèles.
Ils permettent d’identifier les systèmes qui progressent, ceux qui méritent un test plus approfondi et les domaines où les écarts restent faibles.
Étudier les préférences humaines
Arena intéresse aussi les chercheurs et les équipes qui travaillent sur l’évaluation.
Les votes montrent comment de vrais utilisateurs réagissent à de vraies réponses, avec tous les biais, ambiguïtés et préférences que cela implique.
Conclusion
La meilleure idée reste l’anonymisation
Une marque, un prix ou une réputation influencent déjà notre lecture avant même que nous ayons examiné le résultat.
Masquer le nom des modèles ne supprime pas tous les biais, mais force au moins à regarder la réponse avant le logo.
C’est une discipline simple et très saine.
Arena mesure une préférence, pas une vérité
Une réponse plus longue, plus assurée ou plus élégante peut battre une réponse plus sobre mais plus exacte.
Les prompts communautaires peuvent également être vagues, subjectifs ou dominés par certains usages.
Le rang devient donc beaucoup plus intéressant lorsqu’il est accompagné de son contexte : tâche évaluée, nombre de votes, incertitude et date.
Les arènes spécialisées sont plus utiles qu’un classement universel
Le paysage de l’IA est devenu trop multimodal pour être résumé par une seule colonne.
Le meilleur modèle de code n’est pas nécessairement le meilleur générateur d’images.
Le meilleur assistant documentaire n’est pas forcément le plus agréable pour écrire.
Arena devient réellement intéressant lorsqu’il encourage cette lecture par tâche.
Un excellent filtre avant un test sérieux
Arena répond très bien à la question :
« Ce modèle mérite-t-il que je l’essaie ? »
Il répond beaucoup moins bien à :
« Peut-il remplacer mon workflow actuel ? »
La seconde question exige de tester l’application officielle, les intégrations, le prix, les limites, la confidentialité et les performances avec ses propres données.
Un laboratoire public
La logique communautaire implique une vraie prudence sur les données envoyées.
Arena est adapté aux prompts de test, aux comparaisons publiques et à l’exploration.
Il l’est beaucoup moins pour un contrat confidentiel, du code propriétaire, une œuvre non publiée ou des données personnelles.
Points d’attention
- Les classements mesurent des préférences relatives : ils ne résument ni la vérité, ni la sécurité, ni le coût.
- Le contexte du classement compte : arène, date, volume de votes et incertitude doivent être considérés.
- Tester avec ses propres demandes reste essentiel : un bon score moyen ne garantit pas l’adéquation à une langue ou un workflow précis.
- Arena ne reproduit pas toujours l’application officielle : paramètres, mémoire, outils et intégrations peuvent différer.
- Les classements spécialisés sont généralement plus utiles qu’un rang global pour choisir un modèle.
- La popularité d’un style de réponse peut influencer les votes sans garantir une meilleure exactitude.
- Les modèles peuvent devenir temporairement indisponibles ou être soumis à des quotas.
- Les données peuvent transiter par plusieurs acteurs : éviter les informations confidentielles ou sensibles.
- La méthodologie est partiellement ouverte, pas l’ensemble du service.
- Arena n’est pas une API de production : une intégration durable doit utiliser les interfaces prévues par les fournisseurs.