Presentación
Planteas exactamente la misma pregunta a dos modelos.
Lees las respuestas, eliges la que te parece más convincente, y solo después de la votación aparecen sus nombres.
Es en esa distancia entre reputación y resultado donde Arena encuentra su interés.
Lanzado en 2023 bajo el nombre Chatbot Arena, luego convertido en LMArena y finalmente Arena, el proyecto se basa en una idea sencilla: enfrentar varios sistemas de inteligencia artificial a la misma tarea y observar sus diferencias a partir de las preferencias de usuarios reales.
El Battle Mode conserva esta lógica histórica.
Dos modelos anónimos responden al mismo prompt; el usuario vota antes de descubrir su identidad.
El Side by Side permite, por el contrario, elegir directamente dos referencias concretas.
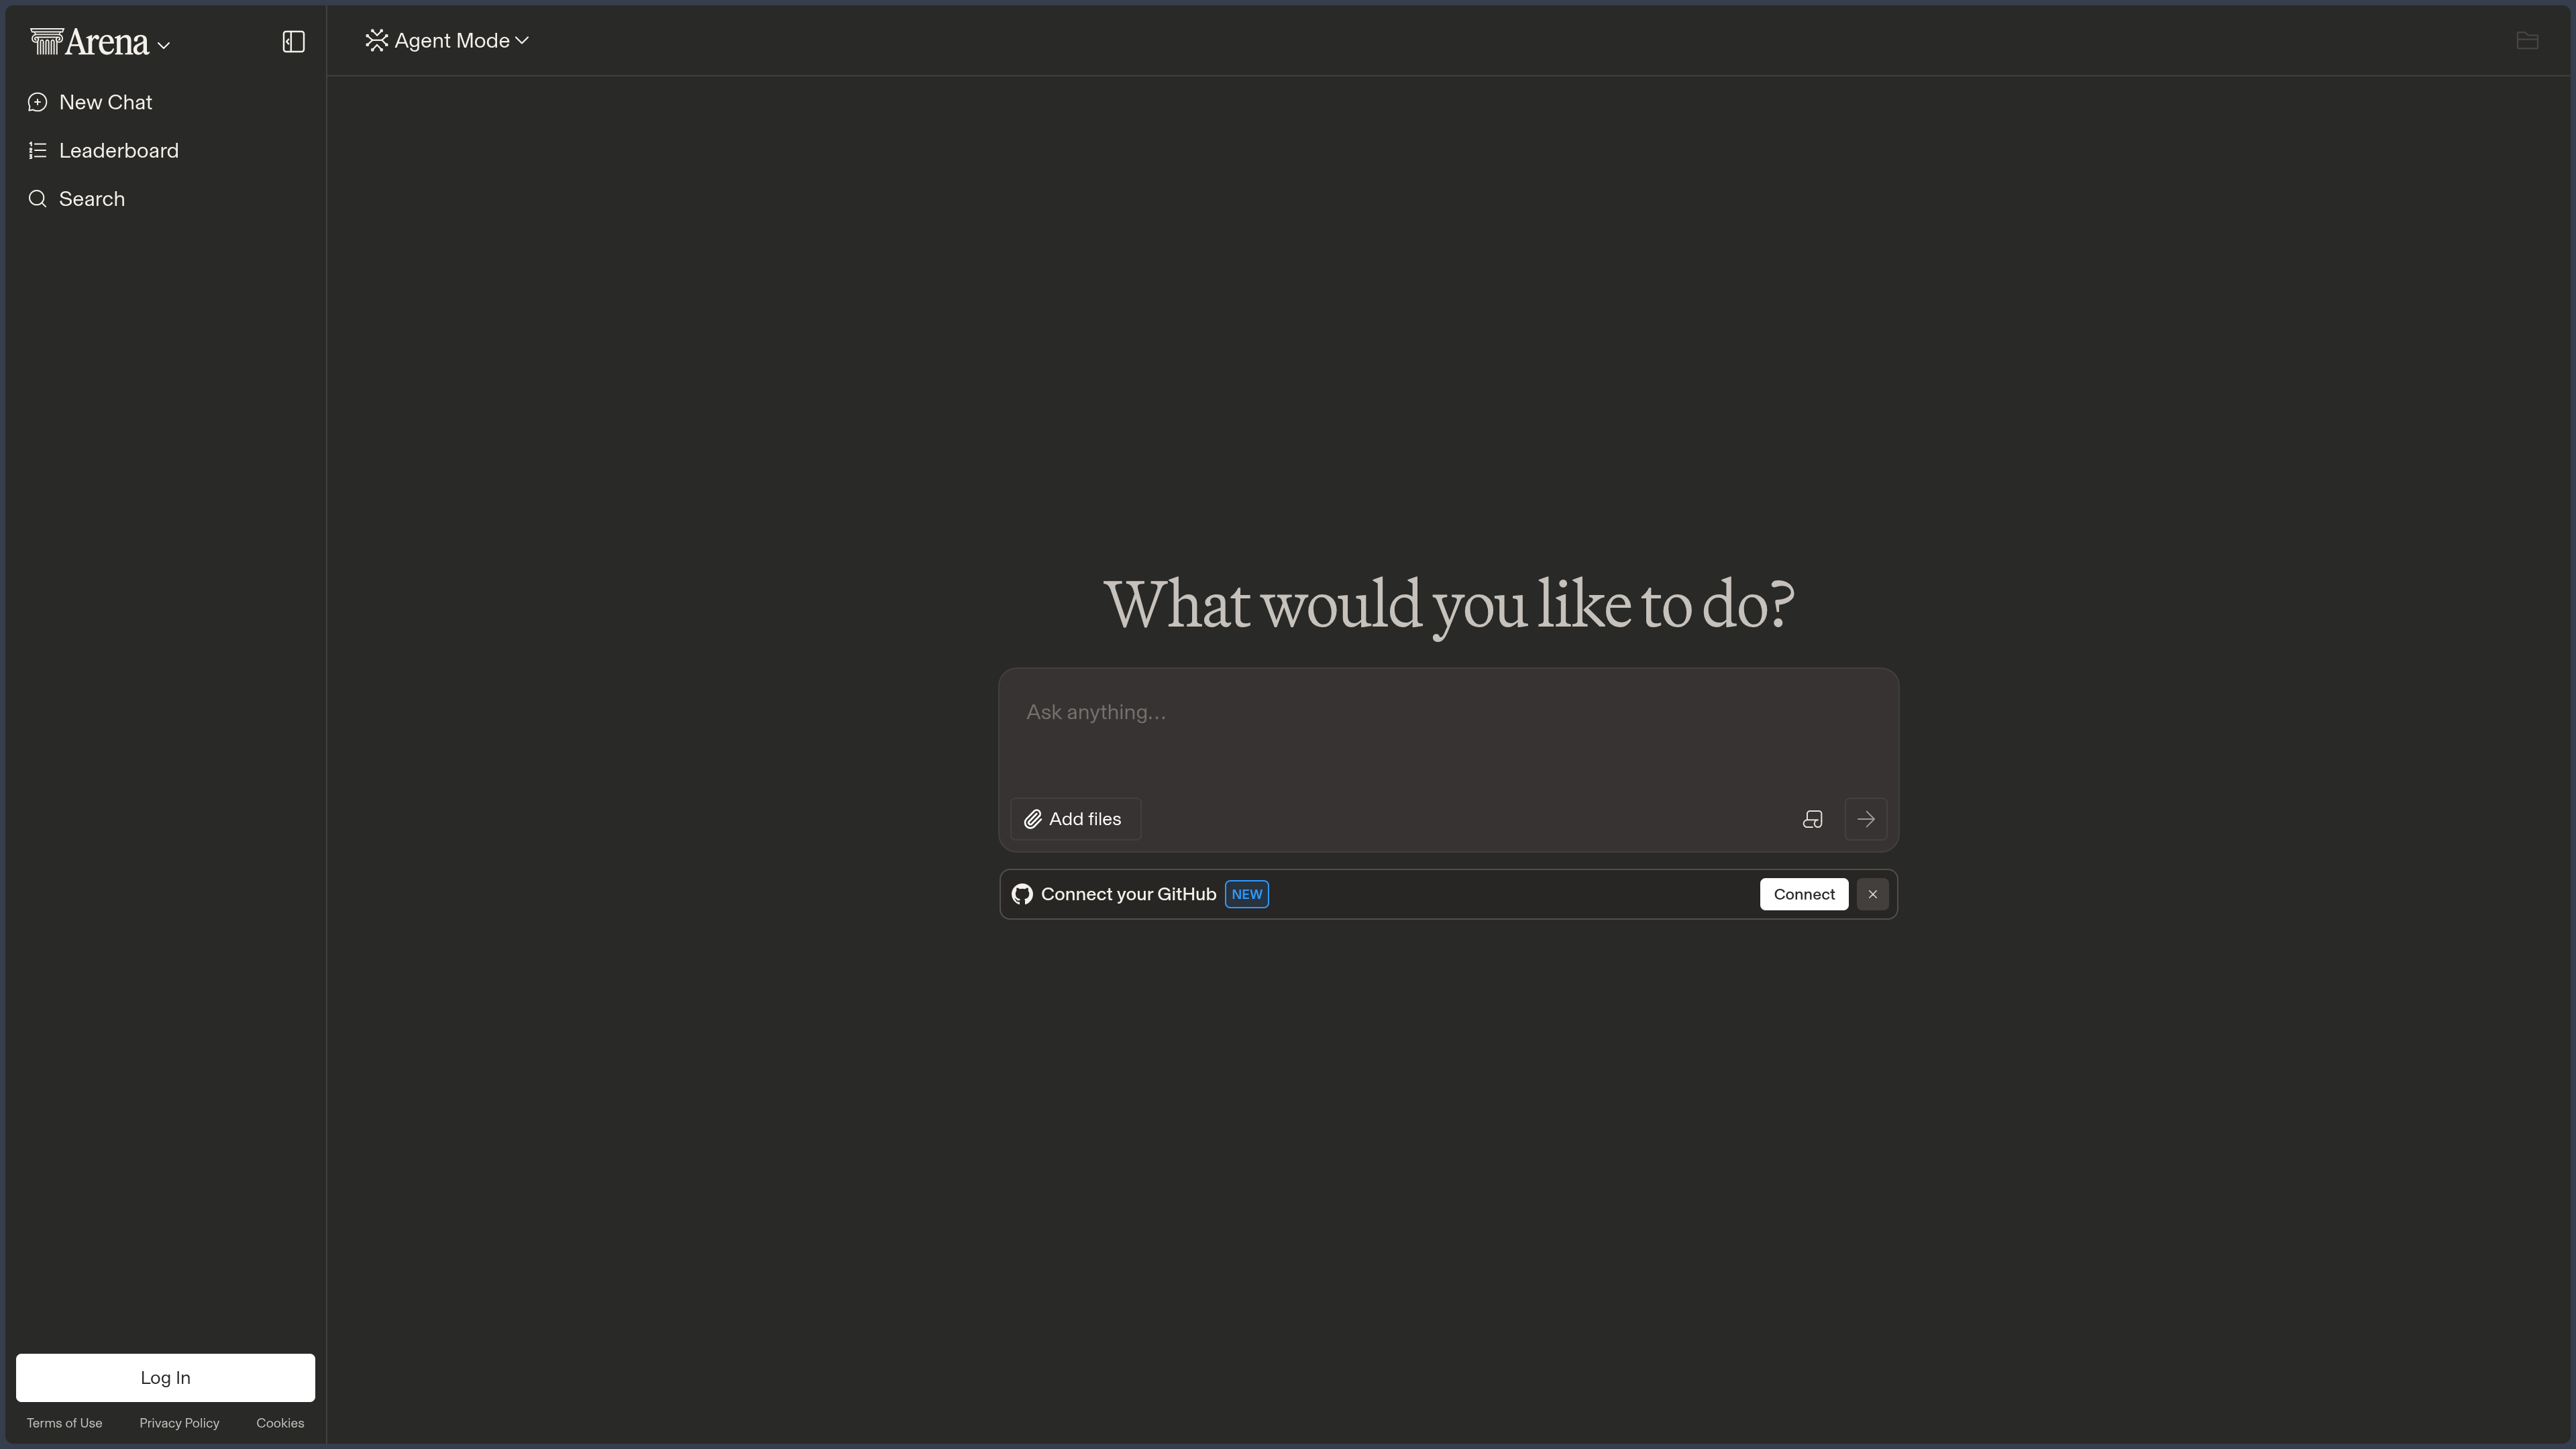
El modo directo sirve para probar un modelo por sí solo desde la misma plataforma.
Arena se ha ido extendiendo progresivamente más allá del texto.
La plataforma compara actualmente distintas formas de generación y asistencia: conversación, código, búsqueda web, visión, documentos, imagen, vídeo o agentes.
Esta extensión no cambia su principio fundamental:
poner varios modelos frente al mismo problema y luego hacer visibles sus diferencias.
Arena no es, por tanto, ni un asistente generalista clásico, ni un benchmark académico puro, ni un simple catálogo.
Es a la vez un laboratorio público de comparación, una puerta de entrada hacia numerosos modelos y una fuente de vigilancia sobre la evolución del mercado.
Su valor proviene también de la naturaleza de las tareas enviadas.
Los benchmarks tradicionales utilizan a menudo juegos de preguntas concebidos de antemano.
Arena observa prompts reales enviados por usuarios reales.
Esta cercanía con los usos ofrece una señal muy interesante sobre la calidad percibida.
También introduce más ruido.
Un voto mide una preferencia en un contexto dado. No convierte automáticamente al ganador en un modelo "objetivamente mejor".
Funcionalidades
Comparación anónima, dirigida y directa
El núcleo de Arena se apoya en tres enfoques complementarios:
| Modo | Principio | Interés |
|---|---|---|
| Battle | dos modelos anónimos responden al mismo prompt | juzgar antes de conocer la marca |
| Side by Side | se eligen dos modelos identificados | comparar con precisión dos referencias |
| Direct | se utiliza un único modelo | probar un modelo desde una interfaz común |
El Battle Mode es el mecanismo más característico.
El anonimato no elimina todos los sesgos, pero retira al menos uno de los más evidentes: la reputación de la marca.
Una respuesta ya no recibe automáticamente una ventaja simplemente porque proviene de un modelo conocido o caro.
La conversación puede prolongarse durante varios turnos.
Esto permite observar no solo una respuesta aislada, sino también la conservación del contexto, la aceptación de una corrección, la capacidad de mantener restricciones o el modo en que un modelo reacciona cuando se pone en tela de juicio su primera respuesta.
El Side by Side resulta más adecuado cuando ya se duda entre dos modelos concretos.
El Direct Mode sirve más bien para descubrir rápidamente una referencia sin abrir inmediatamente una cuenta con su proveedor.
Sin embargo, Arena no siempre reproduce la experiencia oficial de un editor.
El system prompt, los parámetros, la memoria, los conectores, las herramientas, el contexto disponible o los filtros pueden diferir.
Una comparación en Arena debe considerarse, por tanto, como una prueba del modelo en las condiciones de Arena, no como una reproducción perfecta de su producto oficial.
Arenas especializadas
Una clasificación general se vuelve rápidamente engañosa cuando se olvida que los modelos no brillan en las mismas tareas.
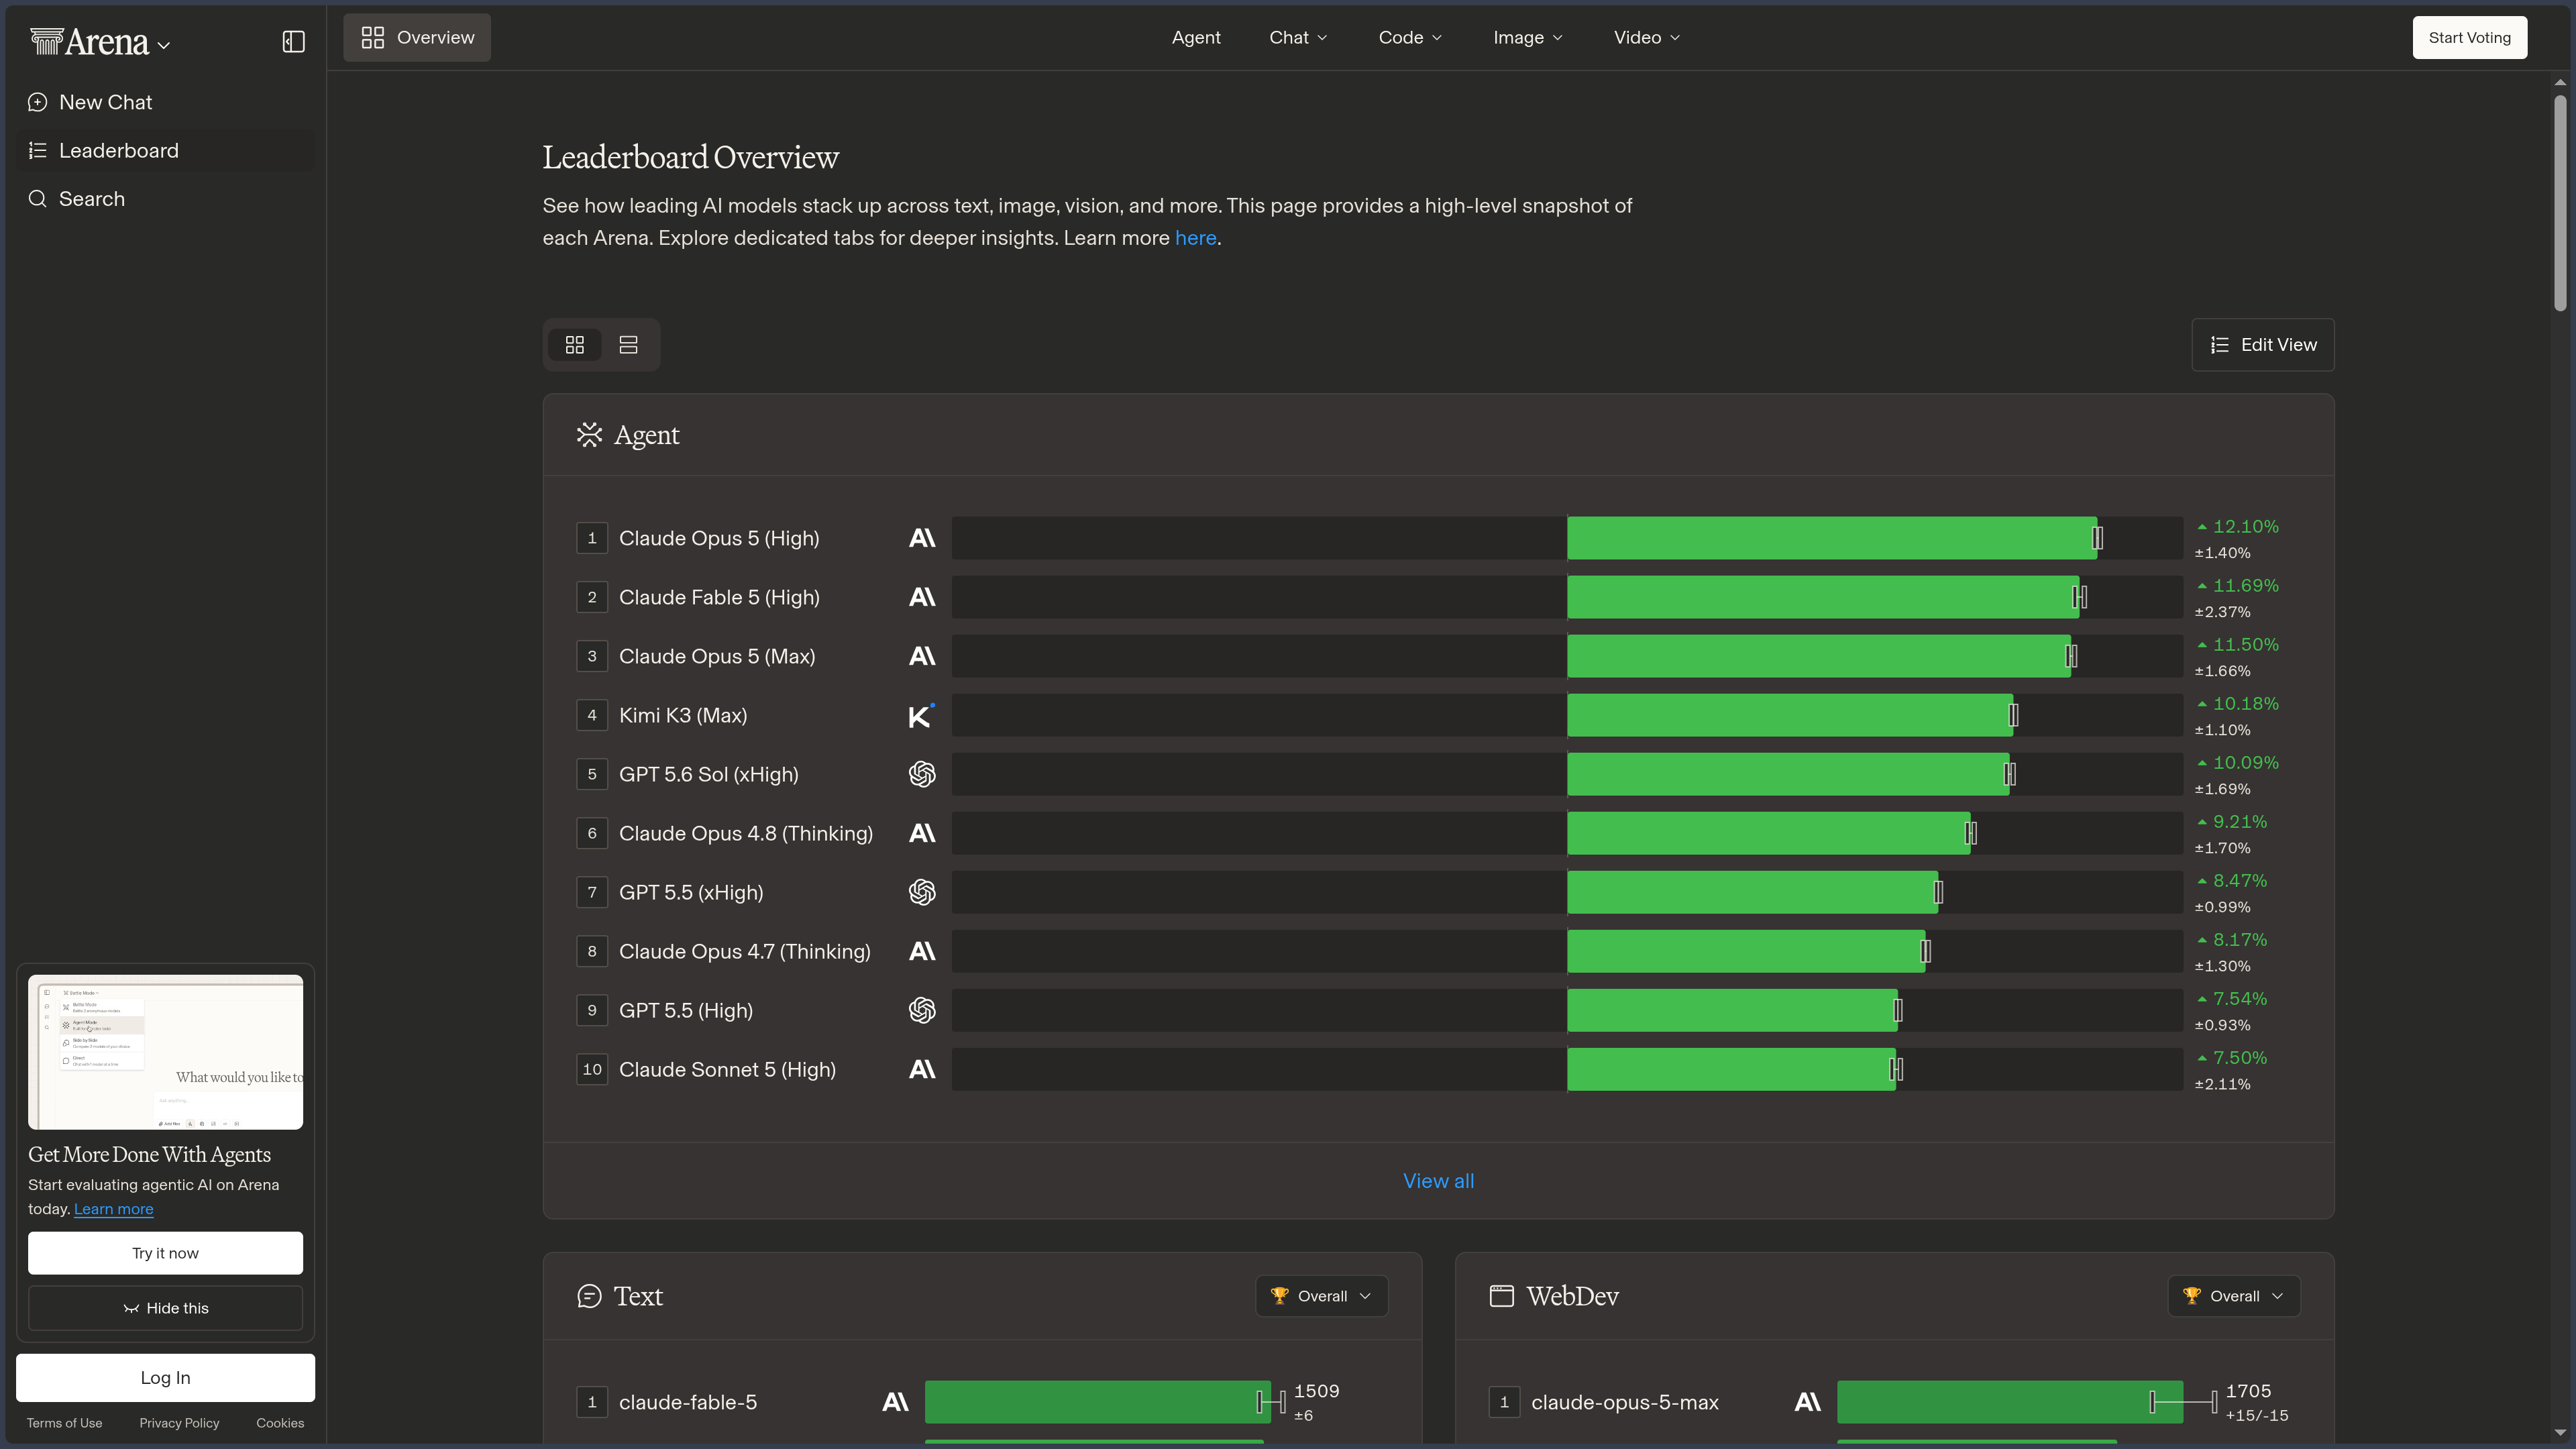
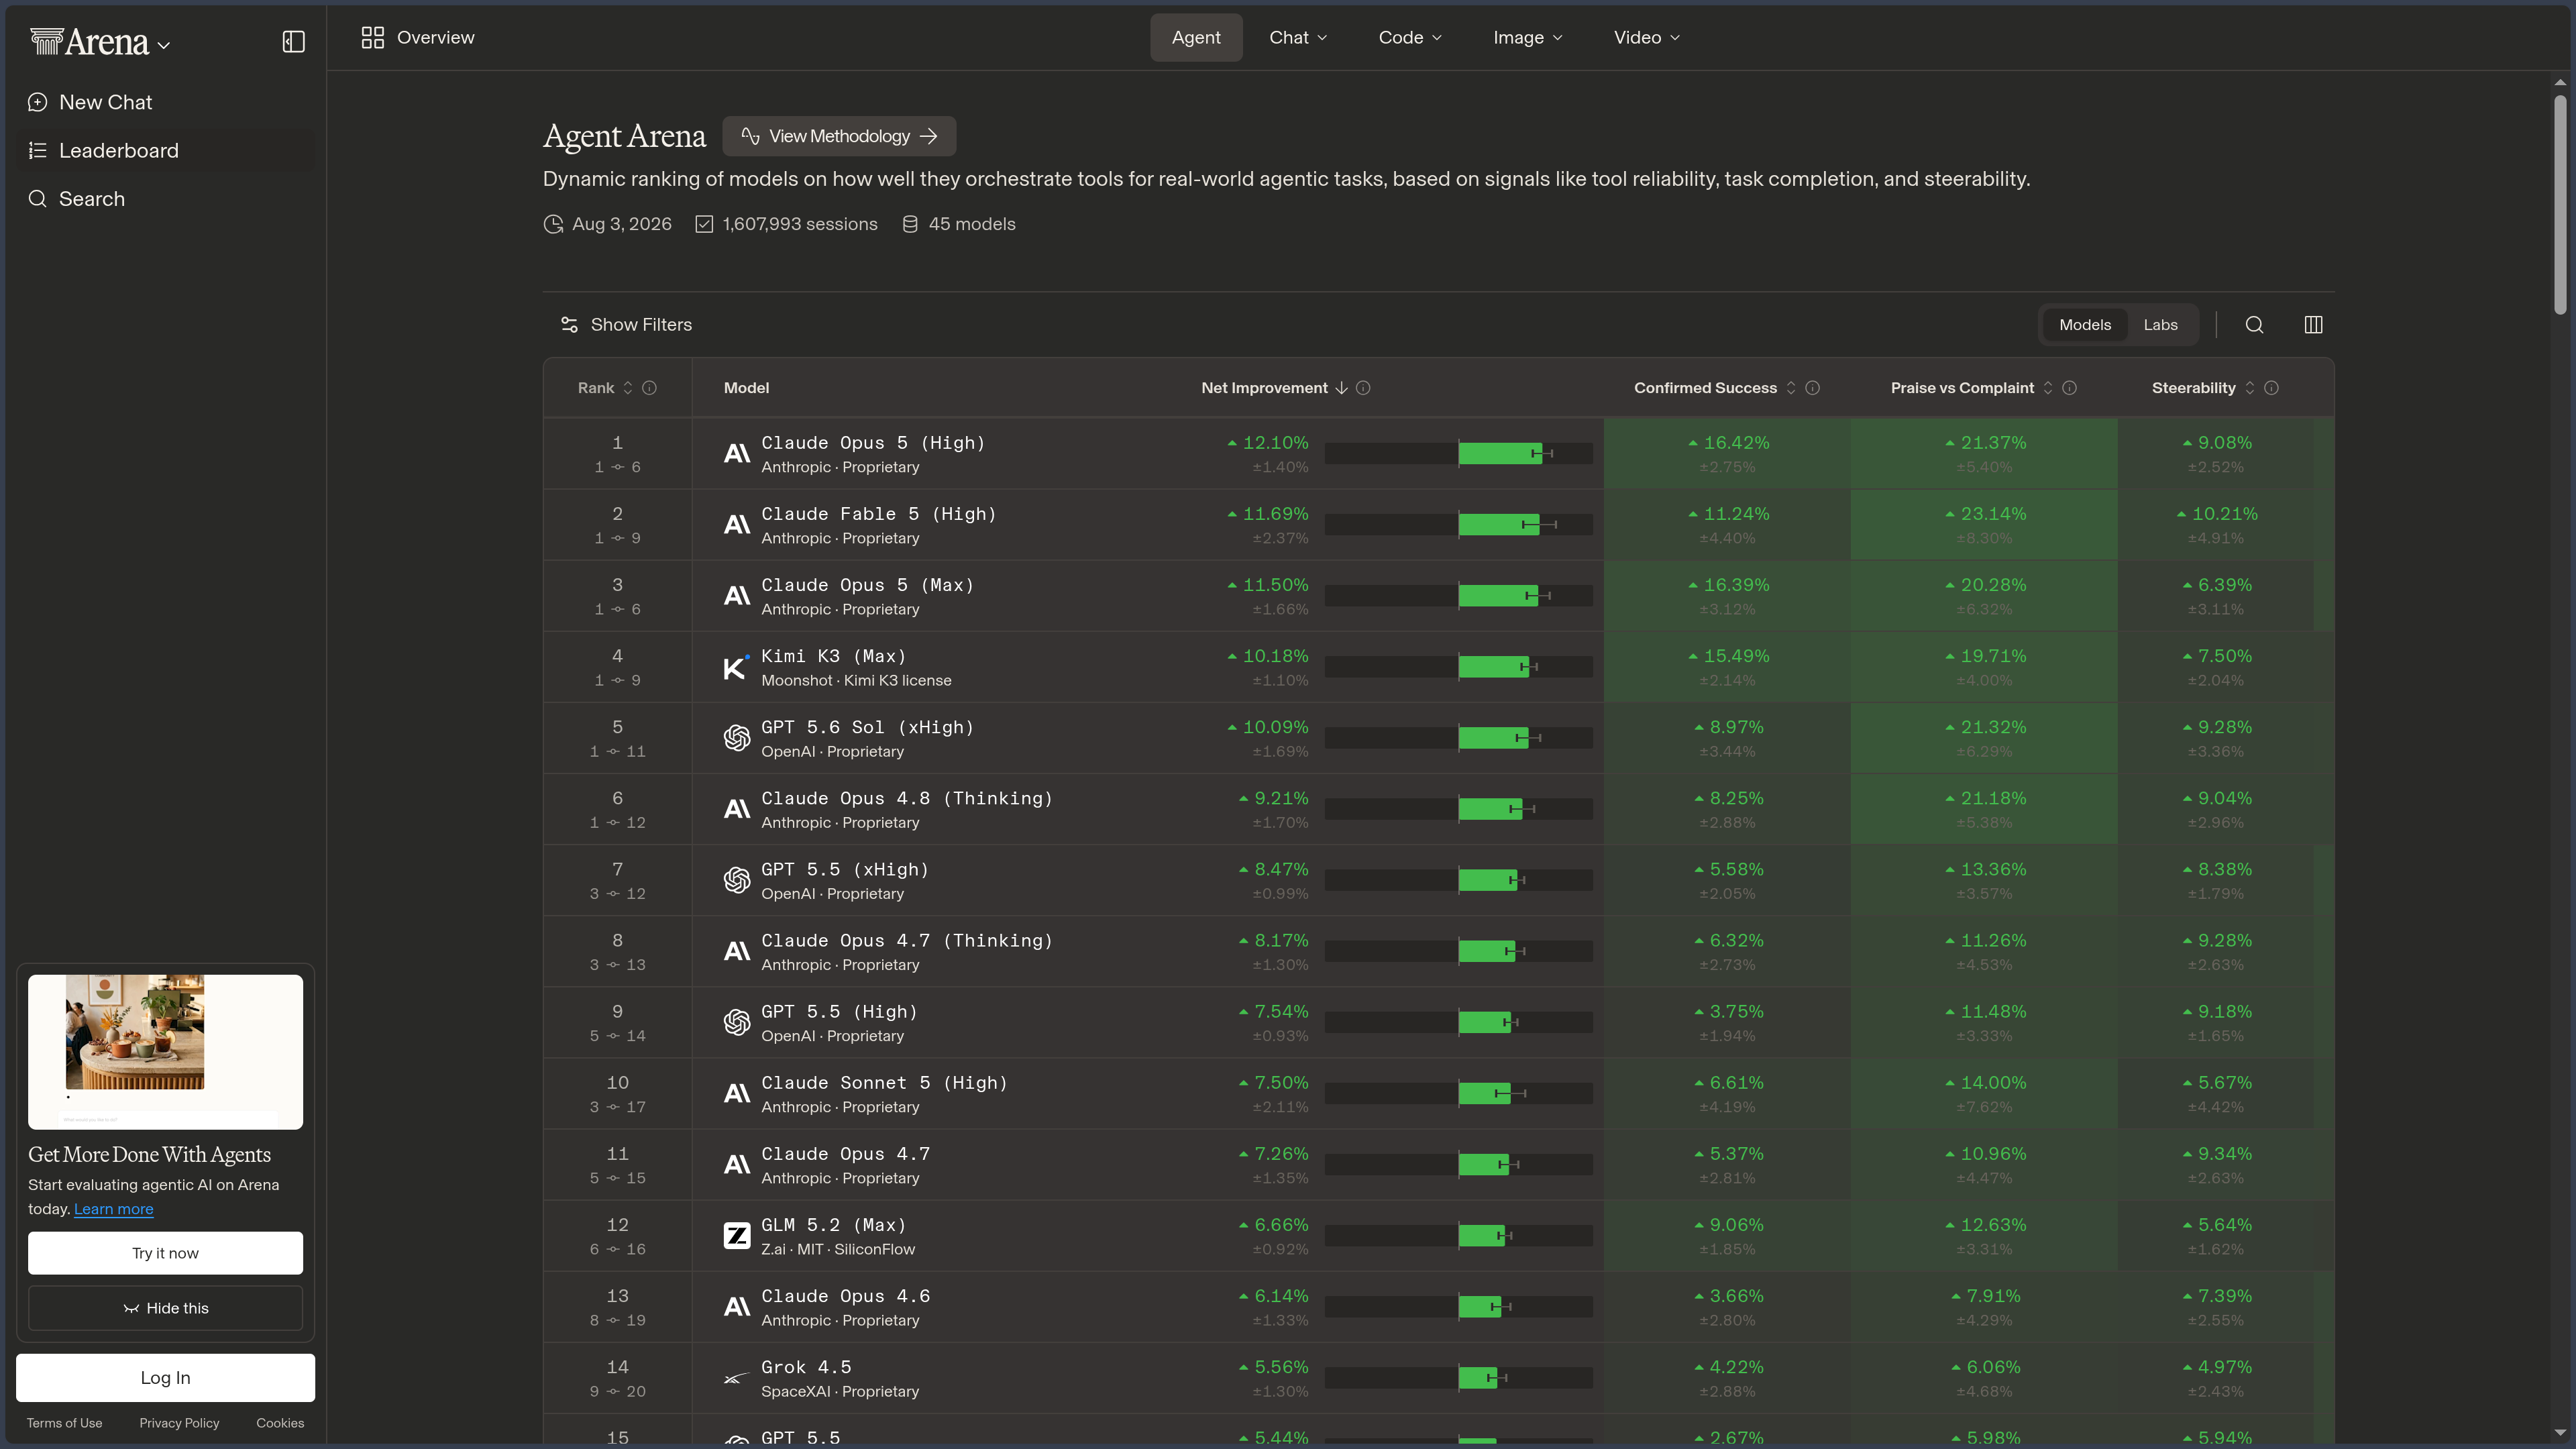
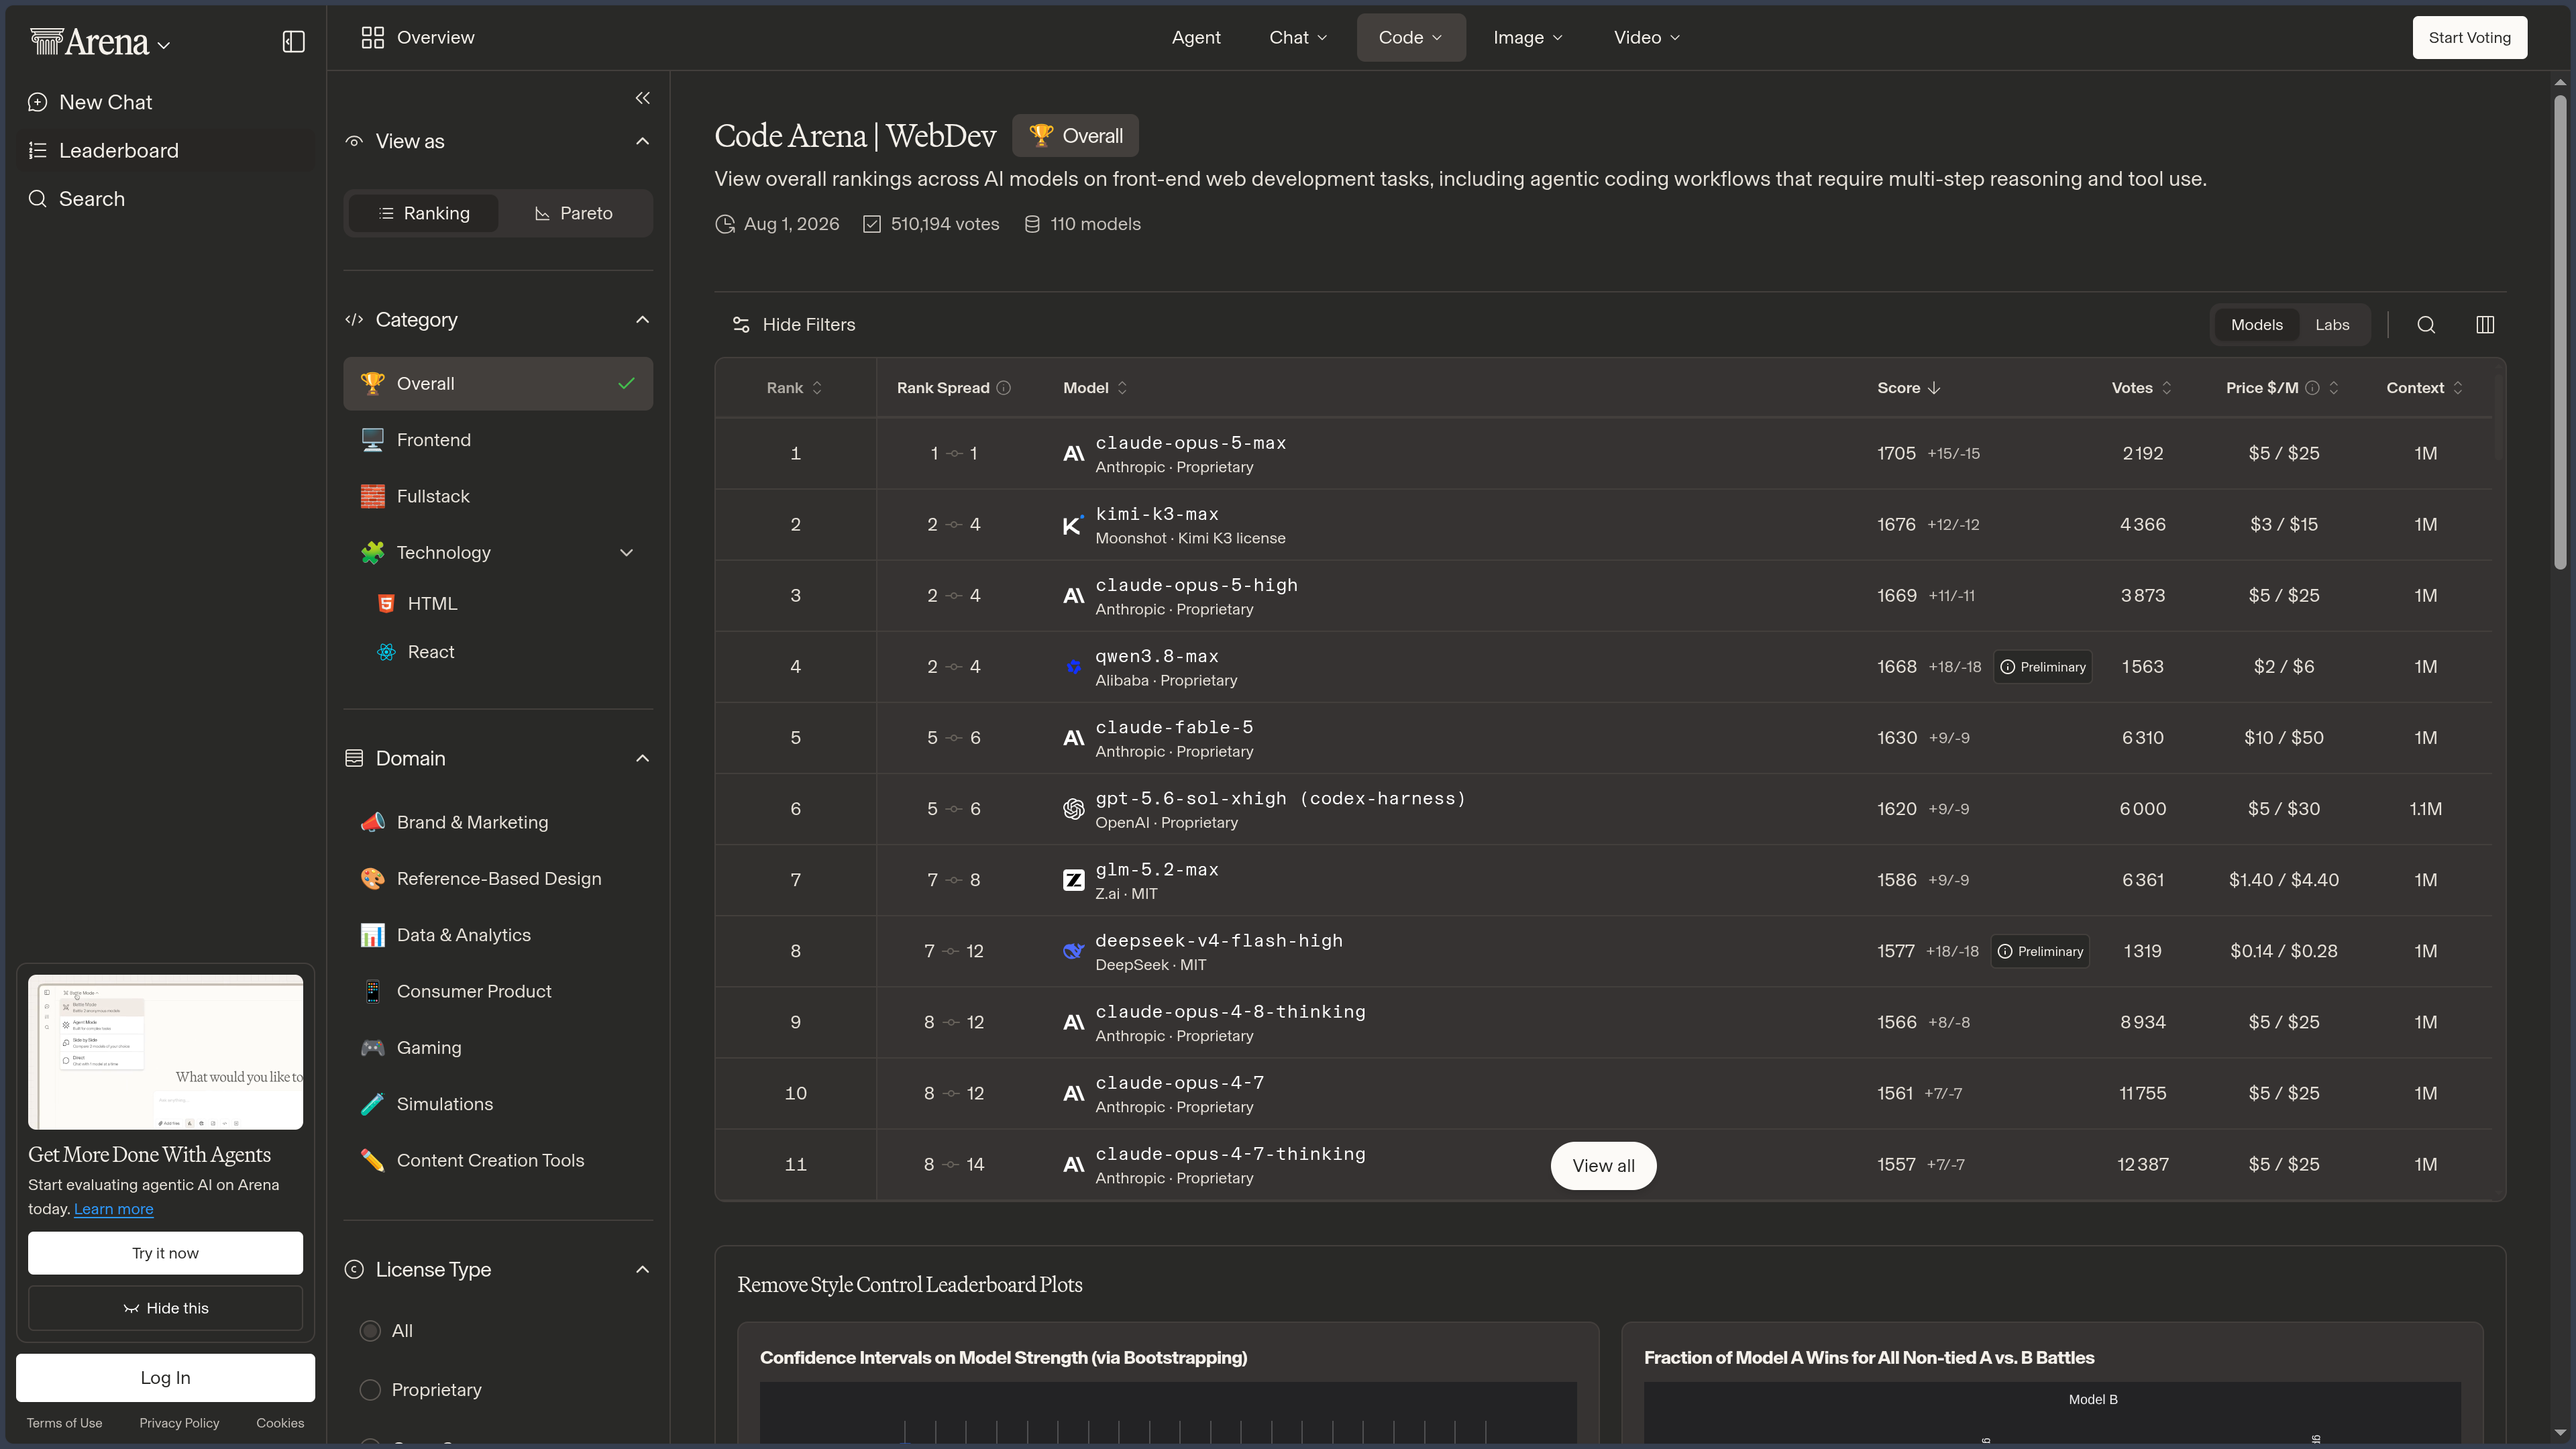
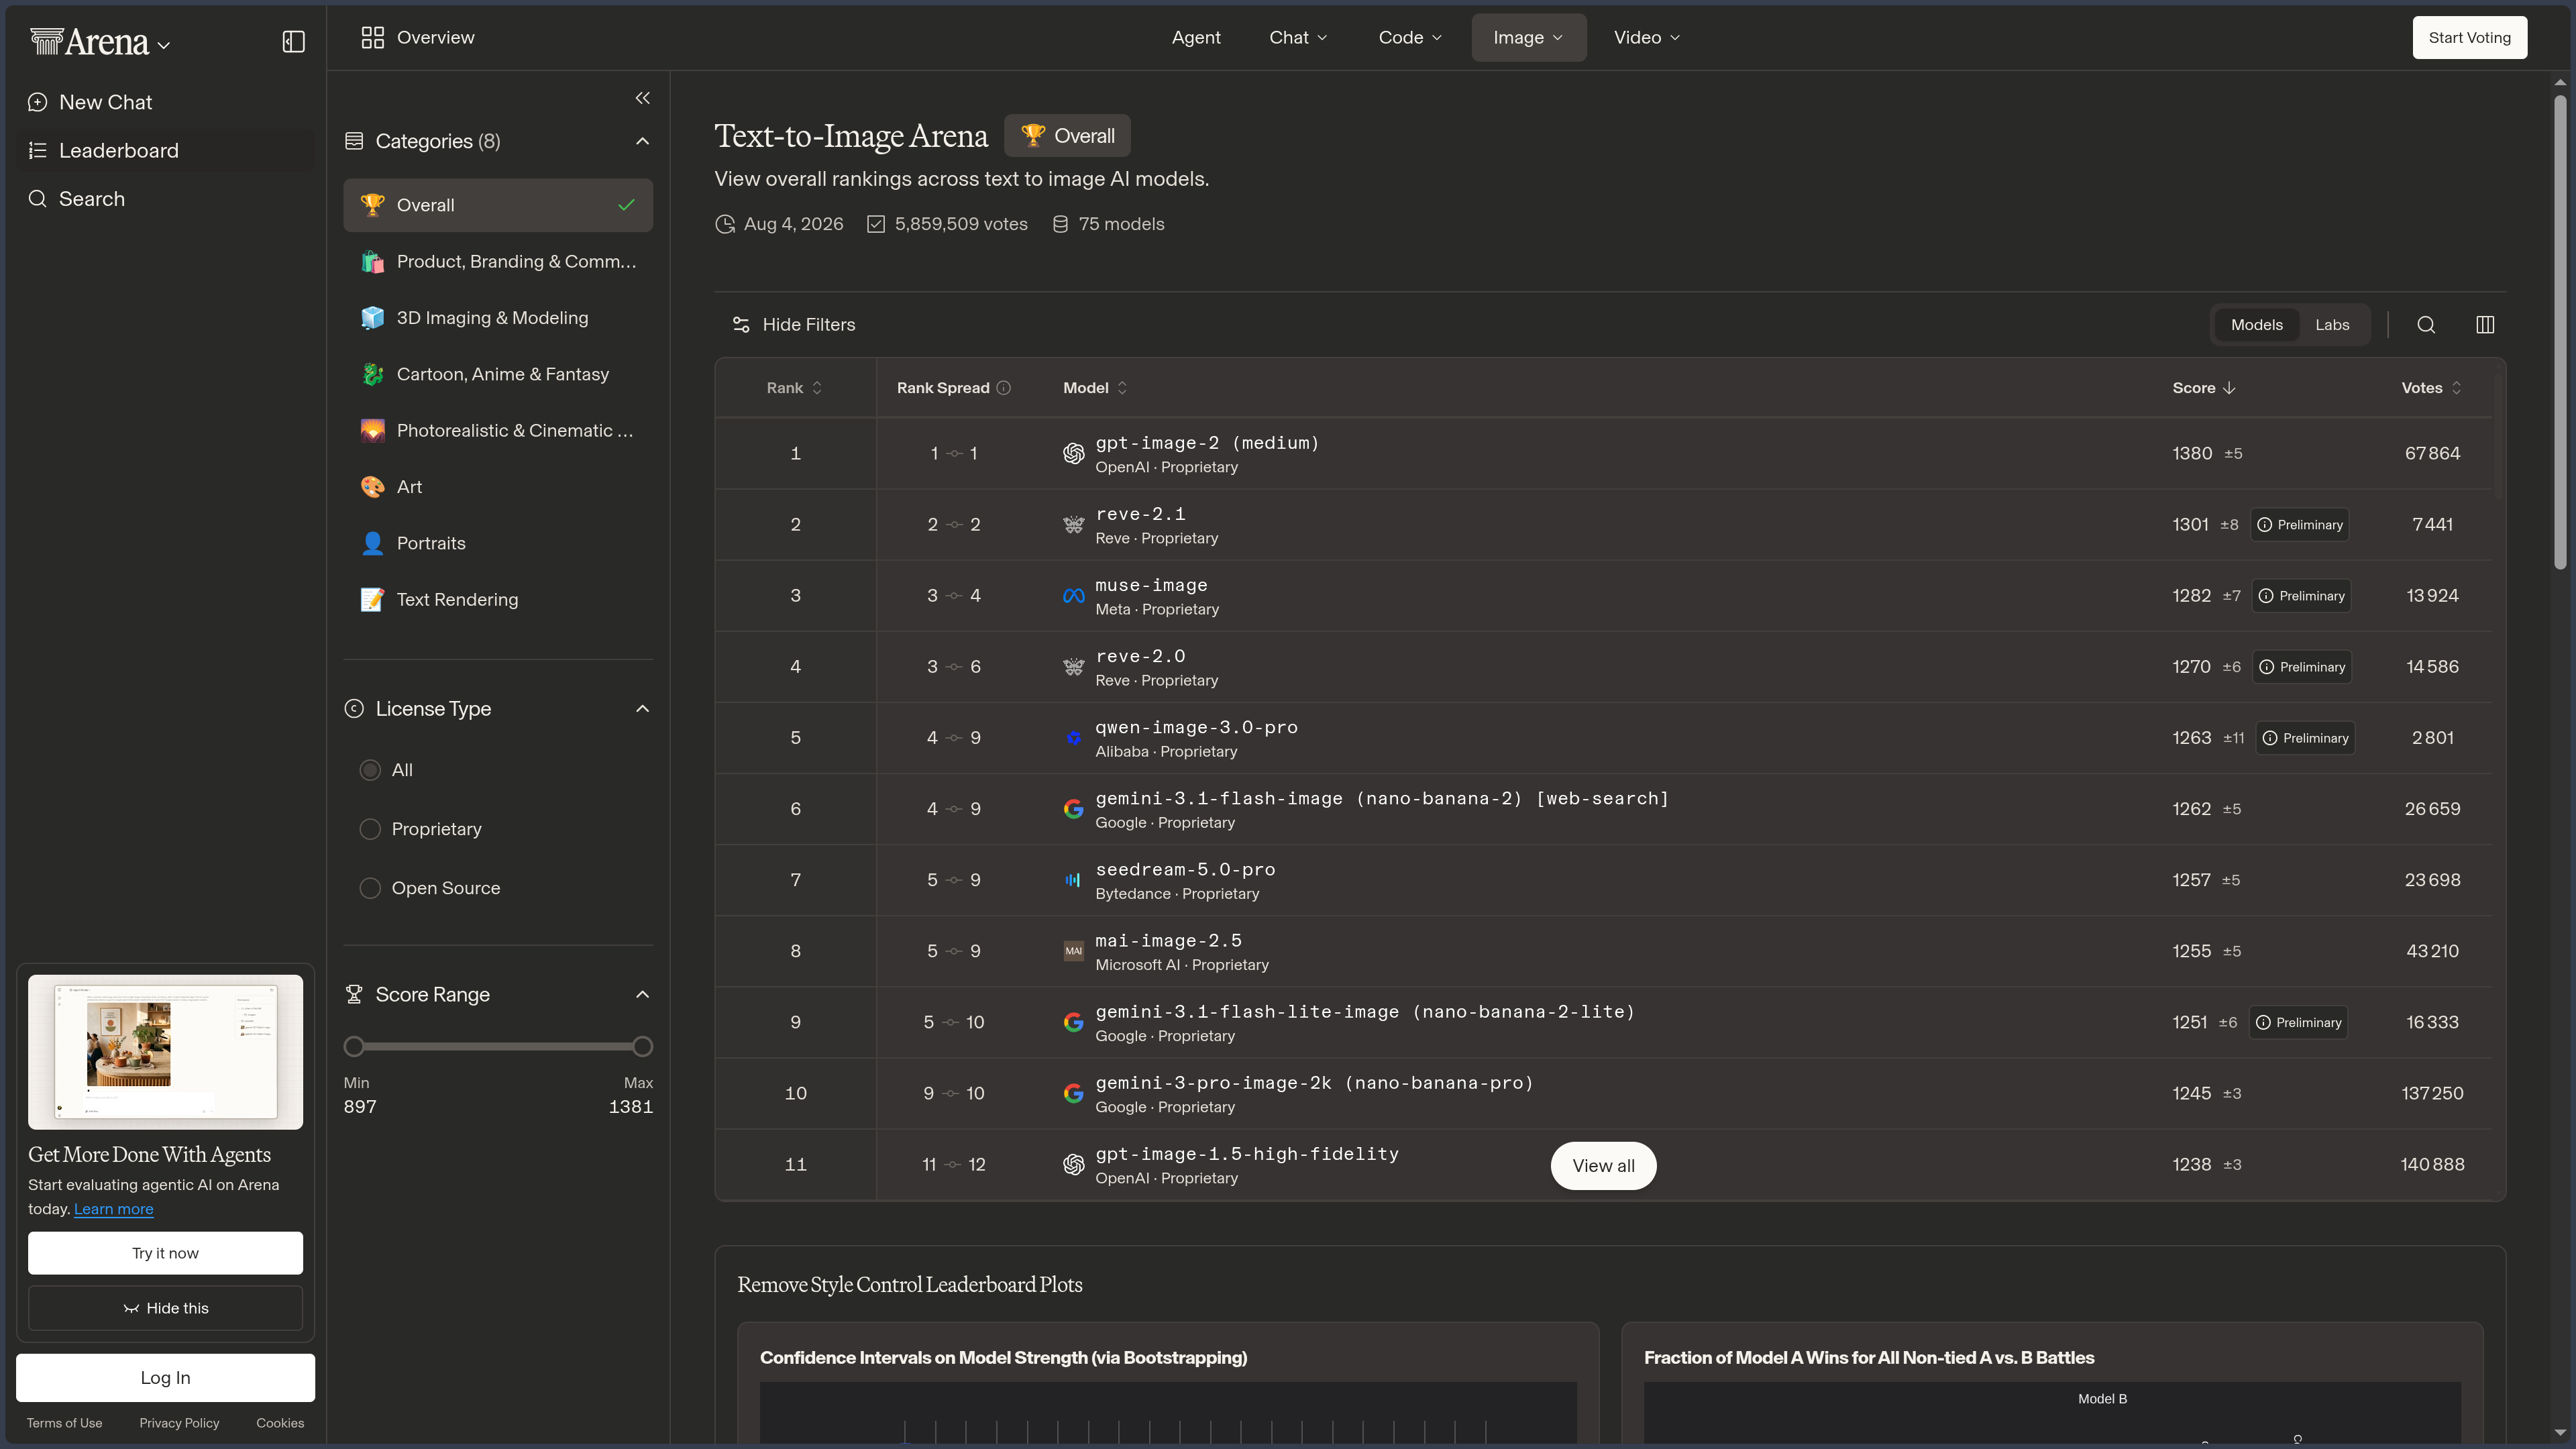
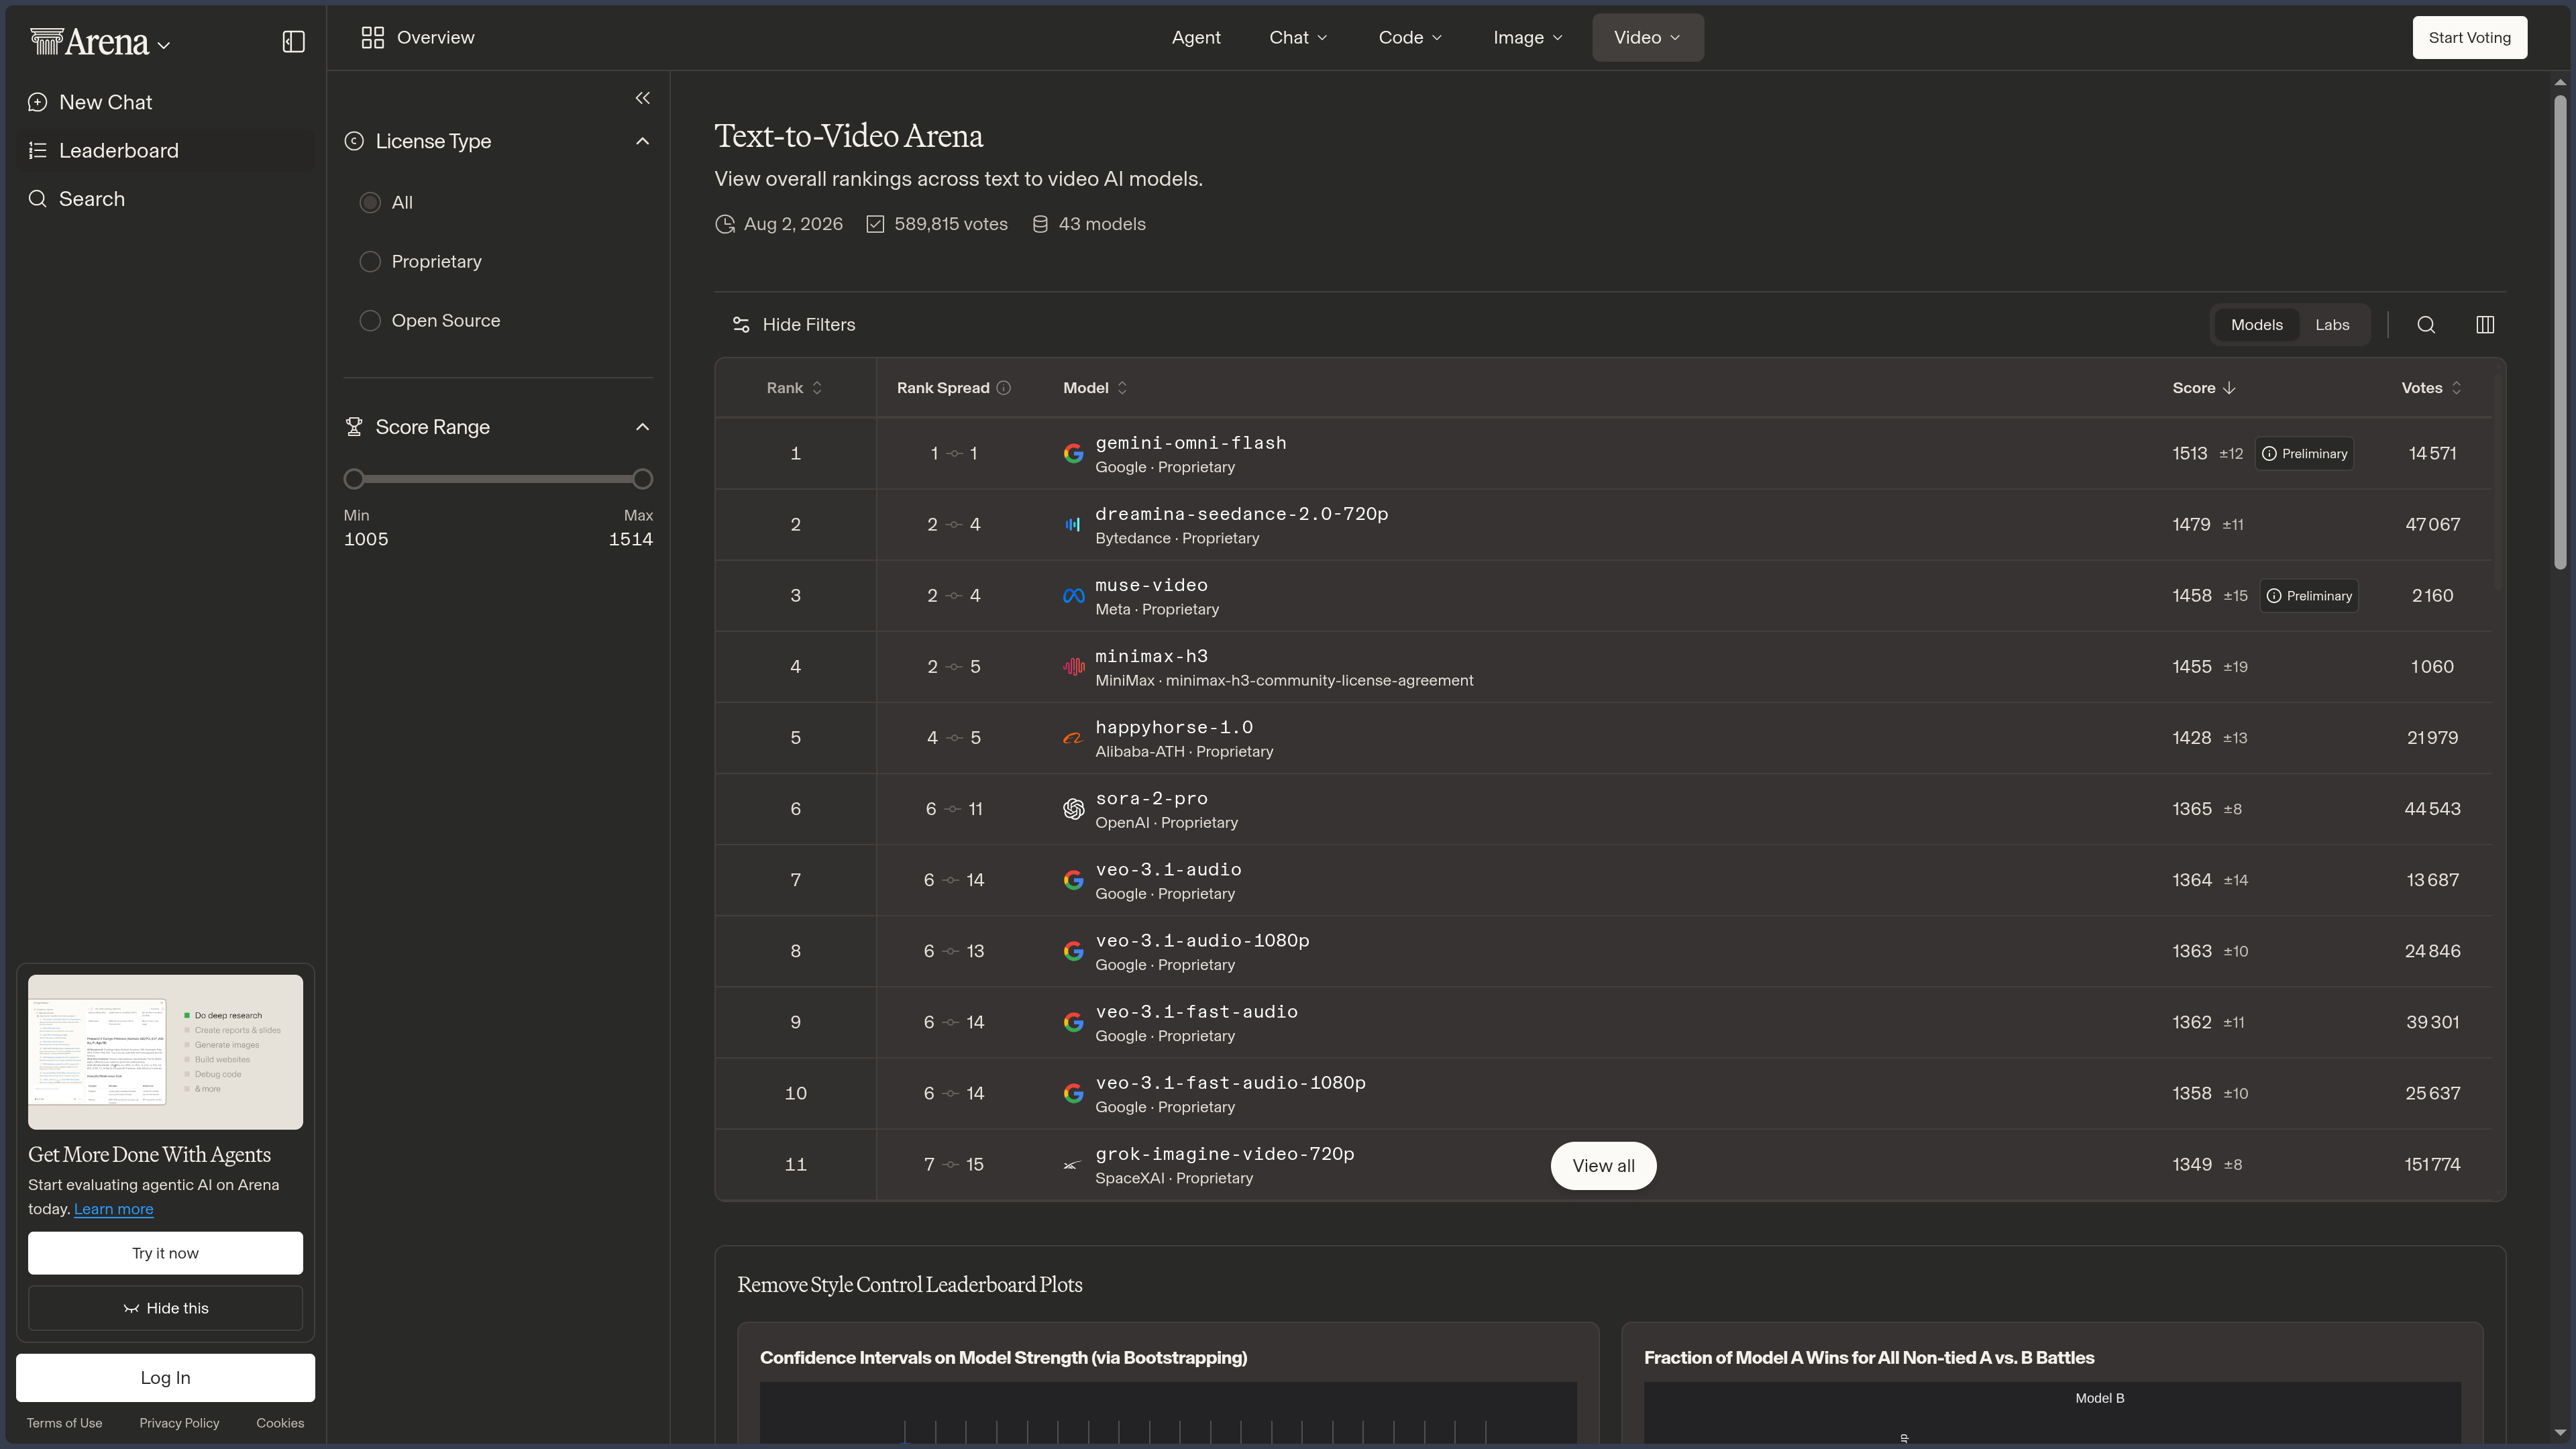
Arena separa, por tanto, varias modalidades: texto, código, búsqueda, visión, documentos, generación de imágenes, vídeo o agentes.
Esta organización permite plantear una mejor pregunta que:
"¿Cuál es el mejor modelo?"
La verdadera pregunta se convierte en:
"¿Qué modelo resulta más convincente para esta tarea concreta?"
Este matiz es especialmente importante para los modelos creativos.
Dos generadores de imágenes pueden ser excelentes en criterios completamente diferentes: respeto al prompt, composición, texto en la imagen, coherencia de un personaje o estilo.
Lo mismo ocurre con el vídeo, el código o la búsqueda web.
Una clasificación especializada ayuda, por tanto, a evitar la idea de un modelo universalmente superior.
Clasificaciones, votos e incertidumbre
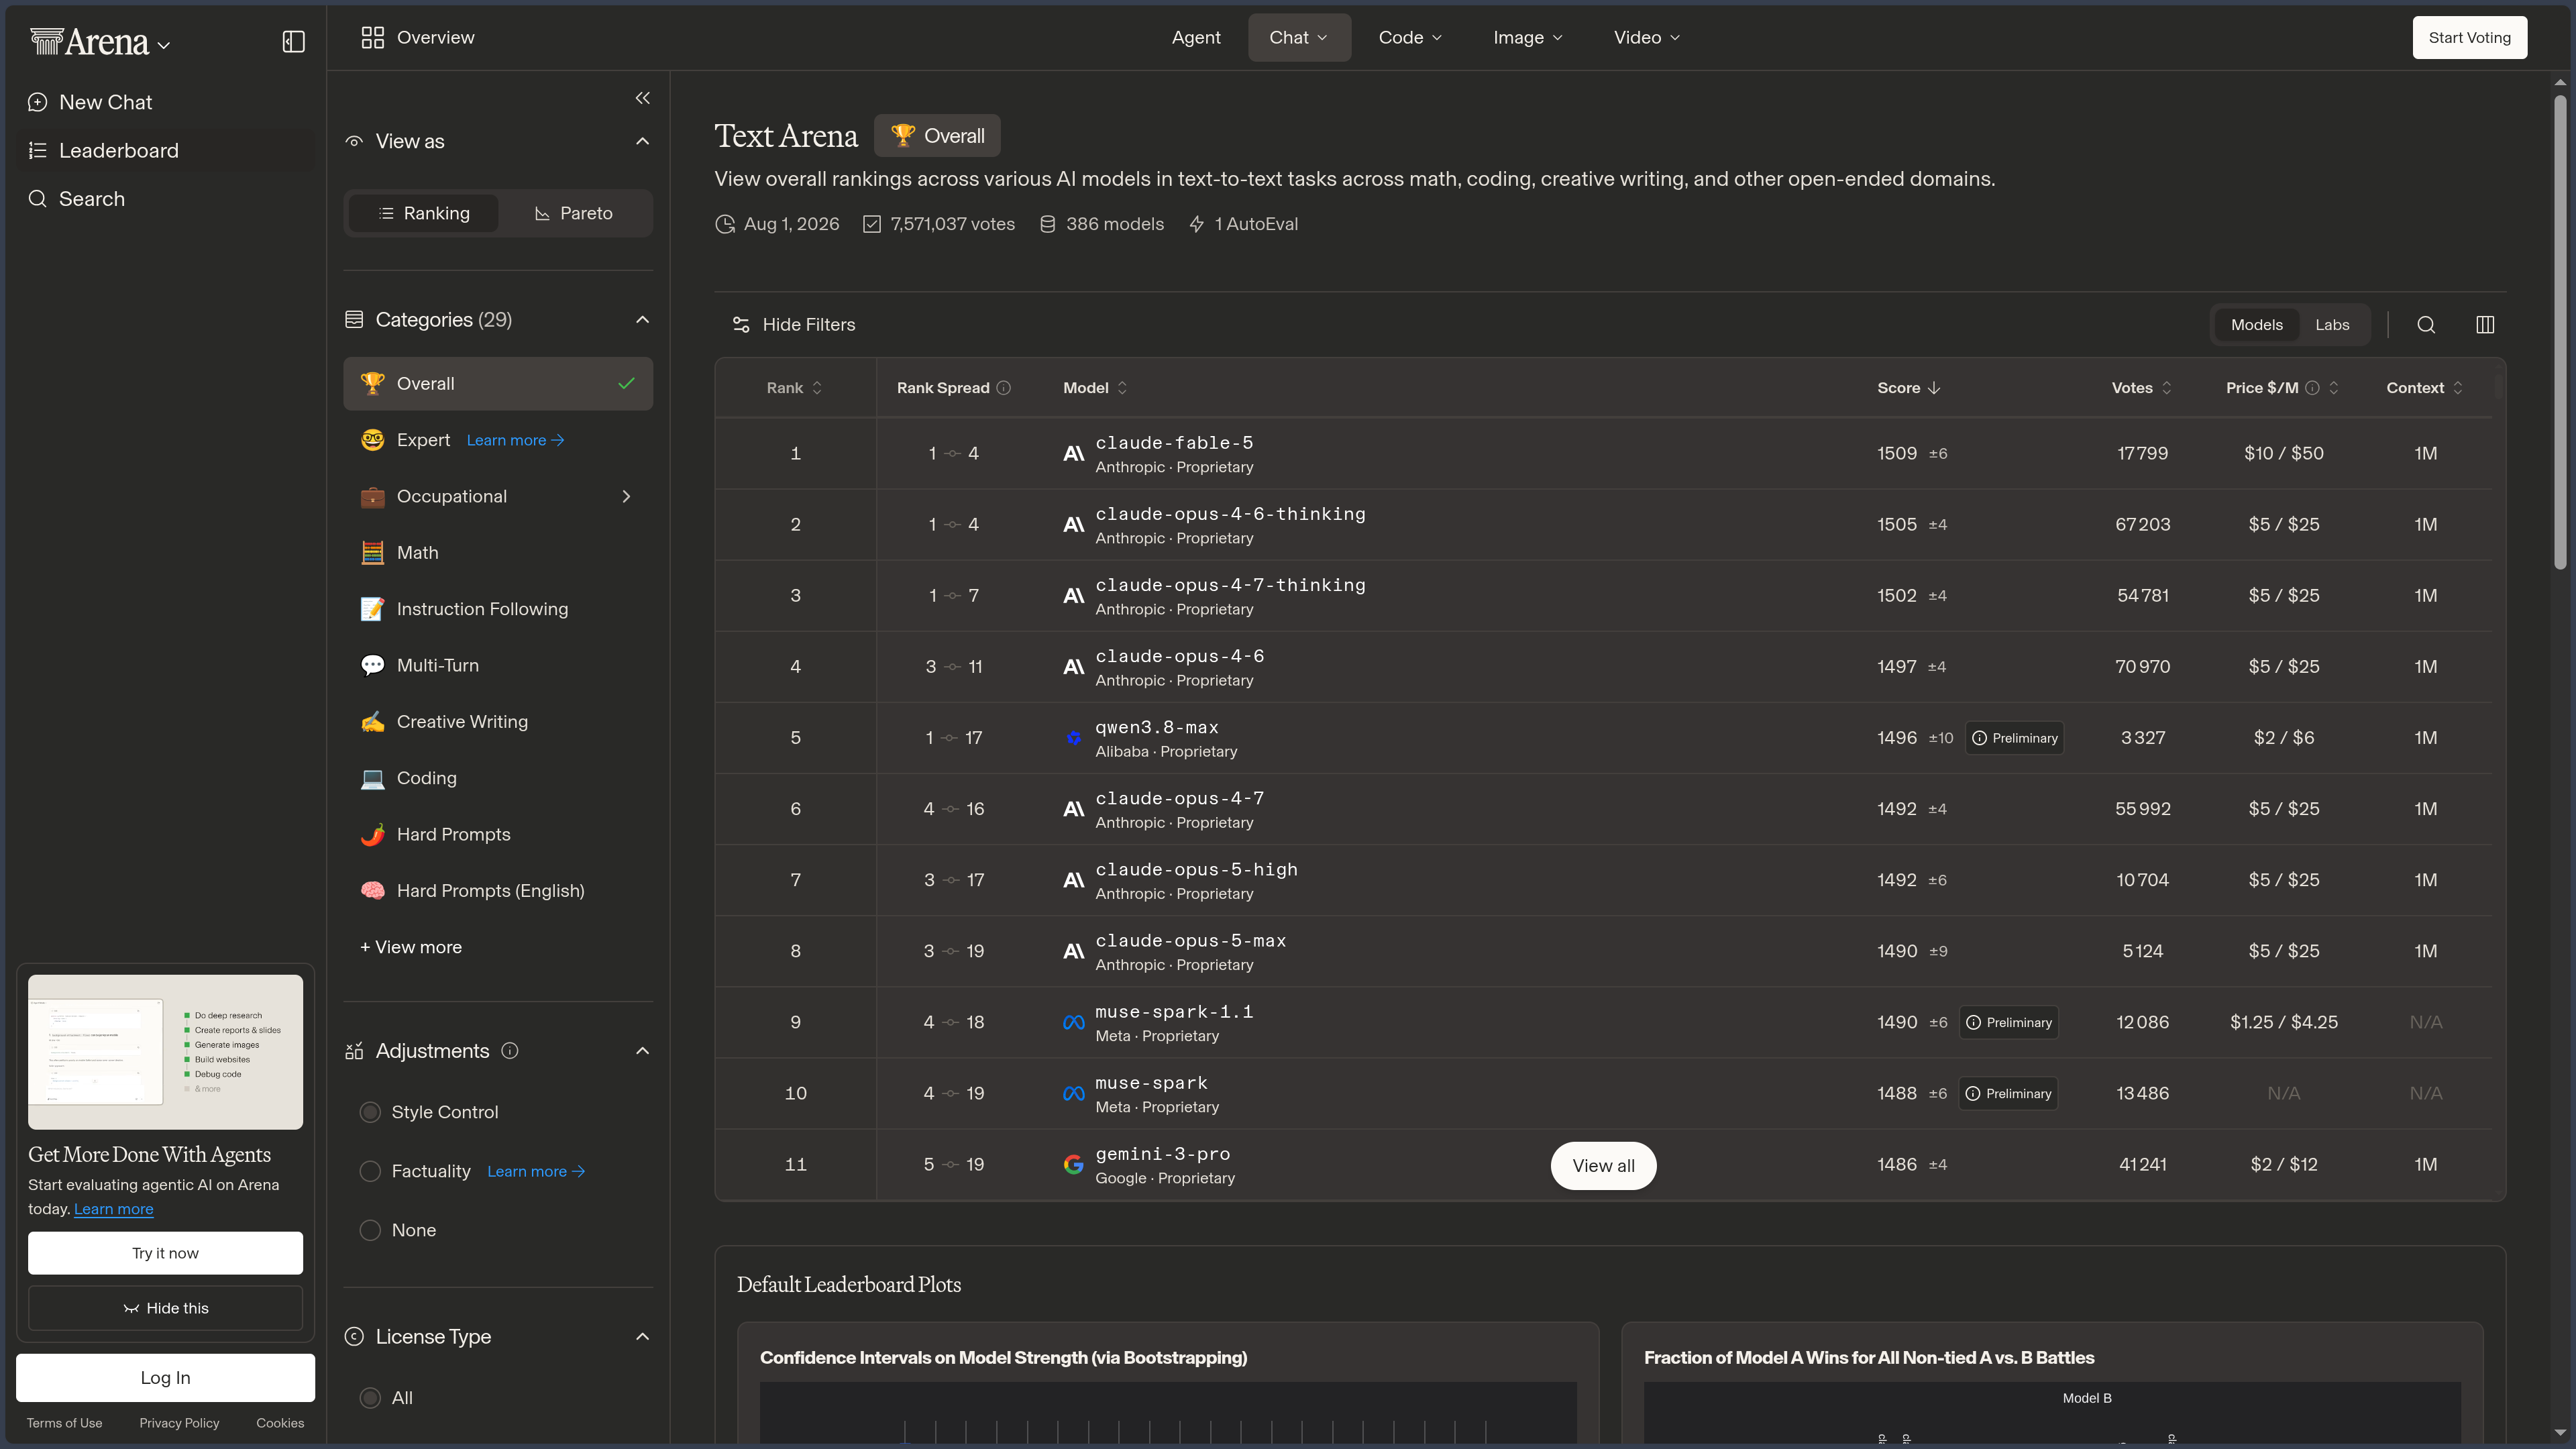
Los votos alimentan clasificaciones relativas.
Arena proporciona varios indicadores destinados a evitar una lectura demasiado simplista del rango: volumen de votos, rangos probables de posición, intervalos de confianza o clasificaciones especializadas.
Esta información es esencial.
Dos modelos separados por varios puestos pueden a veces ser estadísticamente muy cercanos.
A la inversa, una clasificación obtenida con pocos votos debe considerarse con mayor prudencia.
Los resultados también pueden evolucionar cuando:
- un modelo cambia;
- aparecen nuevas versiones;
- evolucionan los usos de los usuarios;
- una arena recibe más votos;
- ciertas categorías se vuelven más populares.
La clasificación es, por tanto, una fotografía cambiante, no una certificación permanente.
Enrutamiento y acceso a los modelos
Arena también propone mecanismos capaces de elegir automáticamente un modelo en función de la tarea.
Esta lógica de enrutamiento es interesante porque invierte el problema.
El usuario ya no necesita necesariamente conocer las fortalezas de decenas de modelos.
El sistema puede intentar elegir una referencia adecuada.
La contrapartida es una capa adicional de opacidad: el modelo elegido puede variar según el rendimiento observado, la disponibilidad o la latencia.
El otro interés práctico de Arena es el acceso a numerosos modelos desde una interfaz común.
Para descubrir una nueva referencia, esto evita abrir inmediatamente una cuenta o una suscripción con cada proveedor.
Investigación, metodología y apertura parcial
Arena no se limita a mostrar resultados.
Parte de su metodología, de sus trabajos de investigación y de sus datos se publica.
Algunos componentes vinculados al cálculo de las clasificaciones también son accesibles bajo licencia abierta.
Esta transparencia permite a investigadores y desarrolladores comprender mejor la lógica de agregación de votos y los límites de la evaluación.
No significa que el conjunto del servicio web, de los datos, de los modelos o de la infraestructura sea open source.
La apertura es, por tanto, metodológica y parcial, no total.
Casos de uso
Probar un modelo antes de adoptarlo
Arena permite enviar a un nuevo modelo solicitudes cercanas a tu propio trabajo y luego comparar sus respuestas con las de referencias ya conocidas.
A menudo resulta más instructivo que una demostración oficial cuidadosamente seleccionada.
Comparar modelos para escritura o investigación
Una misma consigna editorial puede revelar diferencias de tono, precisión, respeto de las restricciones o creatividad.
Para una búsqueda web, la comparación puede centrarse en la calidad de las fuentes, la cobertura del tema o la prudencia de la síntesis.
Explorar los modelos creativos
Image Arena, Video Arena y los espacios dedicados al código permiten observar directamente varios resultados producidos a partir del mismo brief.
Este enfrentamiento es útil para evaluar una dirección artística o un prototipo sin depender de las galerías promocionales de los editores.
Probar la resistencia en varios turnos
Una comparación puede prolongarse para verificar si un modelo conserva restricciones, acepta una corrección o se mantiene coherente tras varios intercambios.
Construir una vigilancia sobre la IA
Las clasificaciones especializadas ofrecen una fotografía cambiante del panorama de los modelos.
Permiten identificar los sistemas que progresan, los que merecen una prueba más profunda y los ámbitos donde las diferencias siguen siendo pequeñas.
Estudiar las preferencias humanas
Arena también interesa a investigadores y equipos que trabajan en evaluación.
Los votos muestran cómo reaccionan usuarios reales a respuestas reales, con todos los sesgos, ambigüedades y preferencias que esto implica.
Opinión PANACHES
La mejor idea sigue siendo el anonimato
Una marca, un precio o una reputación influyen ya en nuestra lectura antes incluso de haber examinado el resultado.
Ocultar el nombre de los modelos no elimina todos los sesgos, pero al menos obliga a mirar la respuesta antes que el logotipo.
Es una disciplina sencilla y muy sana.
Arena mide una preferencia, no una verdad
Una respuesta más larga, más segura o más elegante puede vencer a una respuesta más sobria pero más exacta.
Los prompts comunitarios también pueden ser vagos, subjetivos o estar dominados por ciertos usos.
El rango se vuelve mucho más interesante cuando va acompañado de su contexto: tarea evaluada, número de votos, incertidumbre y fecha.
Las arenas especializadas son más útiles que una clasificación universal
El panorama de la IA se ha vuelto demasiado multimodal para resumirse en una sola columna.
El mejor modelo de código no es necesariamente el mejor generador de imágenes.
El mejor asistente documental no es forzosamente el más agradable para escribir.
Arena resulta realmente interesante cuando fomenta esta lectura por tarea.
Un excelente filtro antes de una prueba seria
Arena responde muy bien a la pregunta:
"¿Este modelo merece que lo pruebe?"
Responde mucho menos bien a:
"¿Puede sustituir a mi flujo de trabajo actual?"
La segunda pregunta exige probar la aplicación oficial, las integraciones, el precio, los límites, la confidencialidad y el rendimiento con tus propios datos.
Un laboratorio público
La lógica comunitaria implica una verdadera prudencia sobre los datos enviados.
Arena se adapta a prompts de prueba, a comparaciones públicas y a la exploración.
Lo es mucho menos para un contrato confidencial, código propietario, una obra no publicada o datos personales.
Puntos de atención
- Las clasificaciones miden preferencias relativas: no resumen ni la verdad, ni la seguridad, ni el coste.
- El contexto de la clasificación importa: arena, fecha, volumen de votos e incertidumbre deben considerarse.
- Probar con tus propias solicitudes sigue siendo esencial: una buena puntuación media no garantiza la idoneidad para un idioma o un flujo de trabajo concreto.
- Arena no siempre reproduce la aplicación oficial: parámetros, memoria, herramientas e integraciones pueden diferir.
- Las clasificaciones especializadas suelen ser más útiles que un rango global para elegir un modelo.
- La popularidad de un estilo de respuesta puede influir en los votos sin garantizar una mayor exactitud.
- Los modelos pueden volverse temporalmente indisponibles o estar sujetos a cuotas.
- Los datos pueden transitar por varios actores: evita la información confidencial o sensible.
- La metodología es parcialmente abierta, no todo el servicio.
- Arena no es una API de producción: una integración duradera debe utilizar las interfaces previstas por los proveedores.