Presentación
LM Studio es una aplicación de escritorio dedicada a ejecutar modelos de inteligencia artificial en el propio ordenador. Permite buscar modelos, descargar sus archivos, cargarlos en memoria y conversar con ellos sin tener que configurar manualmente toda una infraestructura de inferencia. Desarrollada por Element Labs, está disponible para Windows, macOS y Linux.
El principio es sencillo: LM Studio proporciona el entorno de ejecución, pero no impone un único modelo. El usuario puede elegir entre modelos compatibles, entre ellos familias como Llama, Qwen, Mistral o gpt-oss. Sus capacidades, tamaño y licencia dependen de sus respectivos desarrolladores. El programa utiliza principalmente el motor llama.cpp para modelos GGUF y también admite MLX en los Mac equipados con un chip Apple Silicon.
Más allá del chat, LM Studio puede consultar documentos, poner los modelos a disposición de otras aplicaciones mediante una API local y servir de base para experimentos de desarrollo. Su rama 0.4, lanzada en enero de 2026, introdujo especialmente una arquitectura de servicio autónomo, solicitudes paralelas y una API REST renovada. La versión 0.4.25, publicada el 19 de septiembre de 2026, continúa esta evolución.
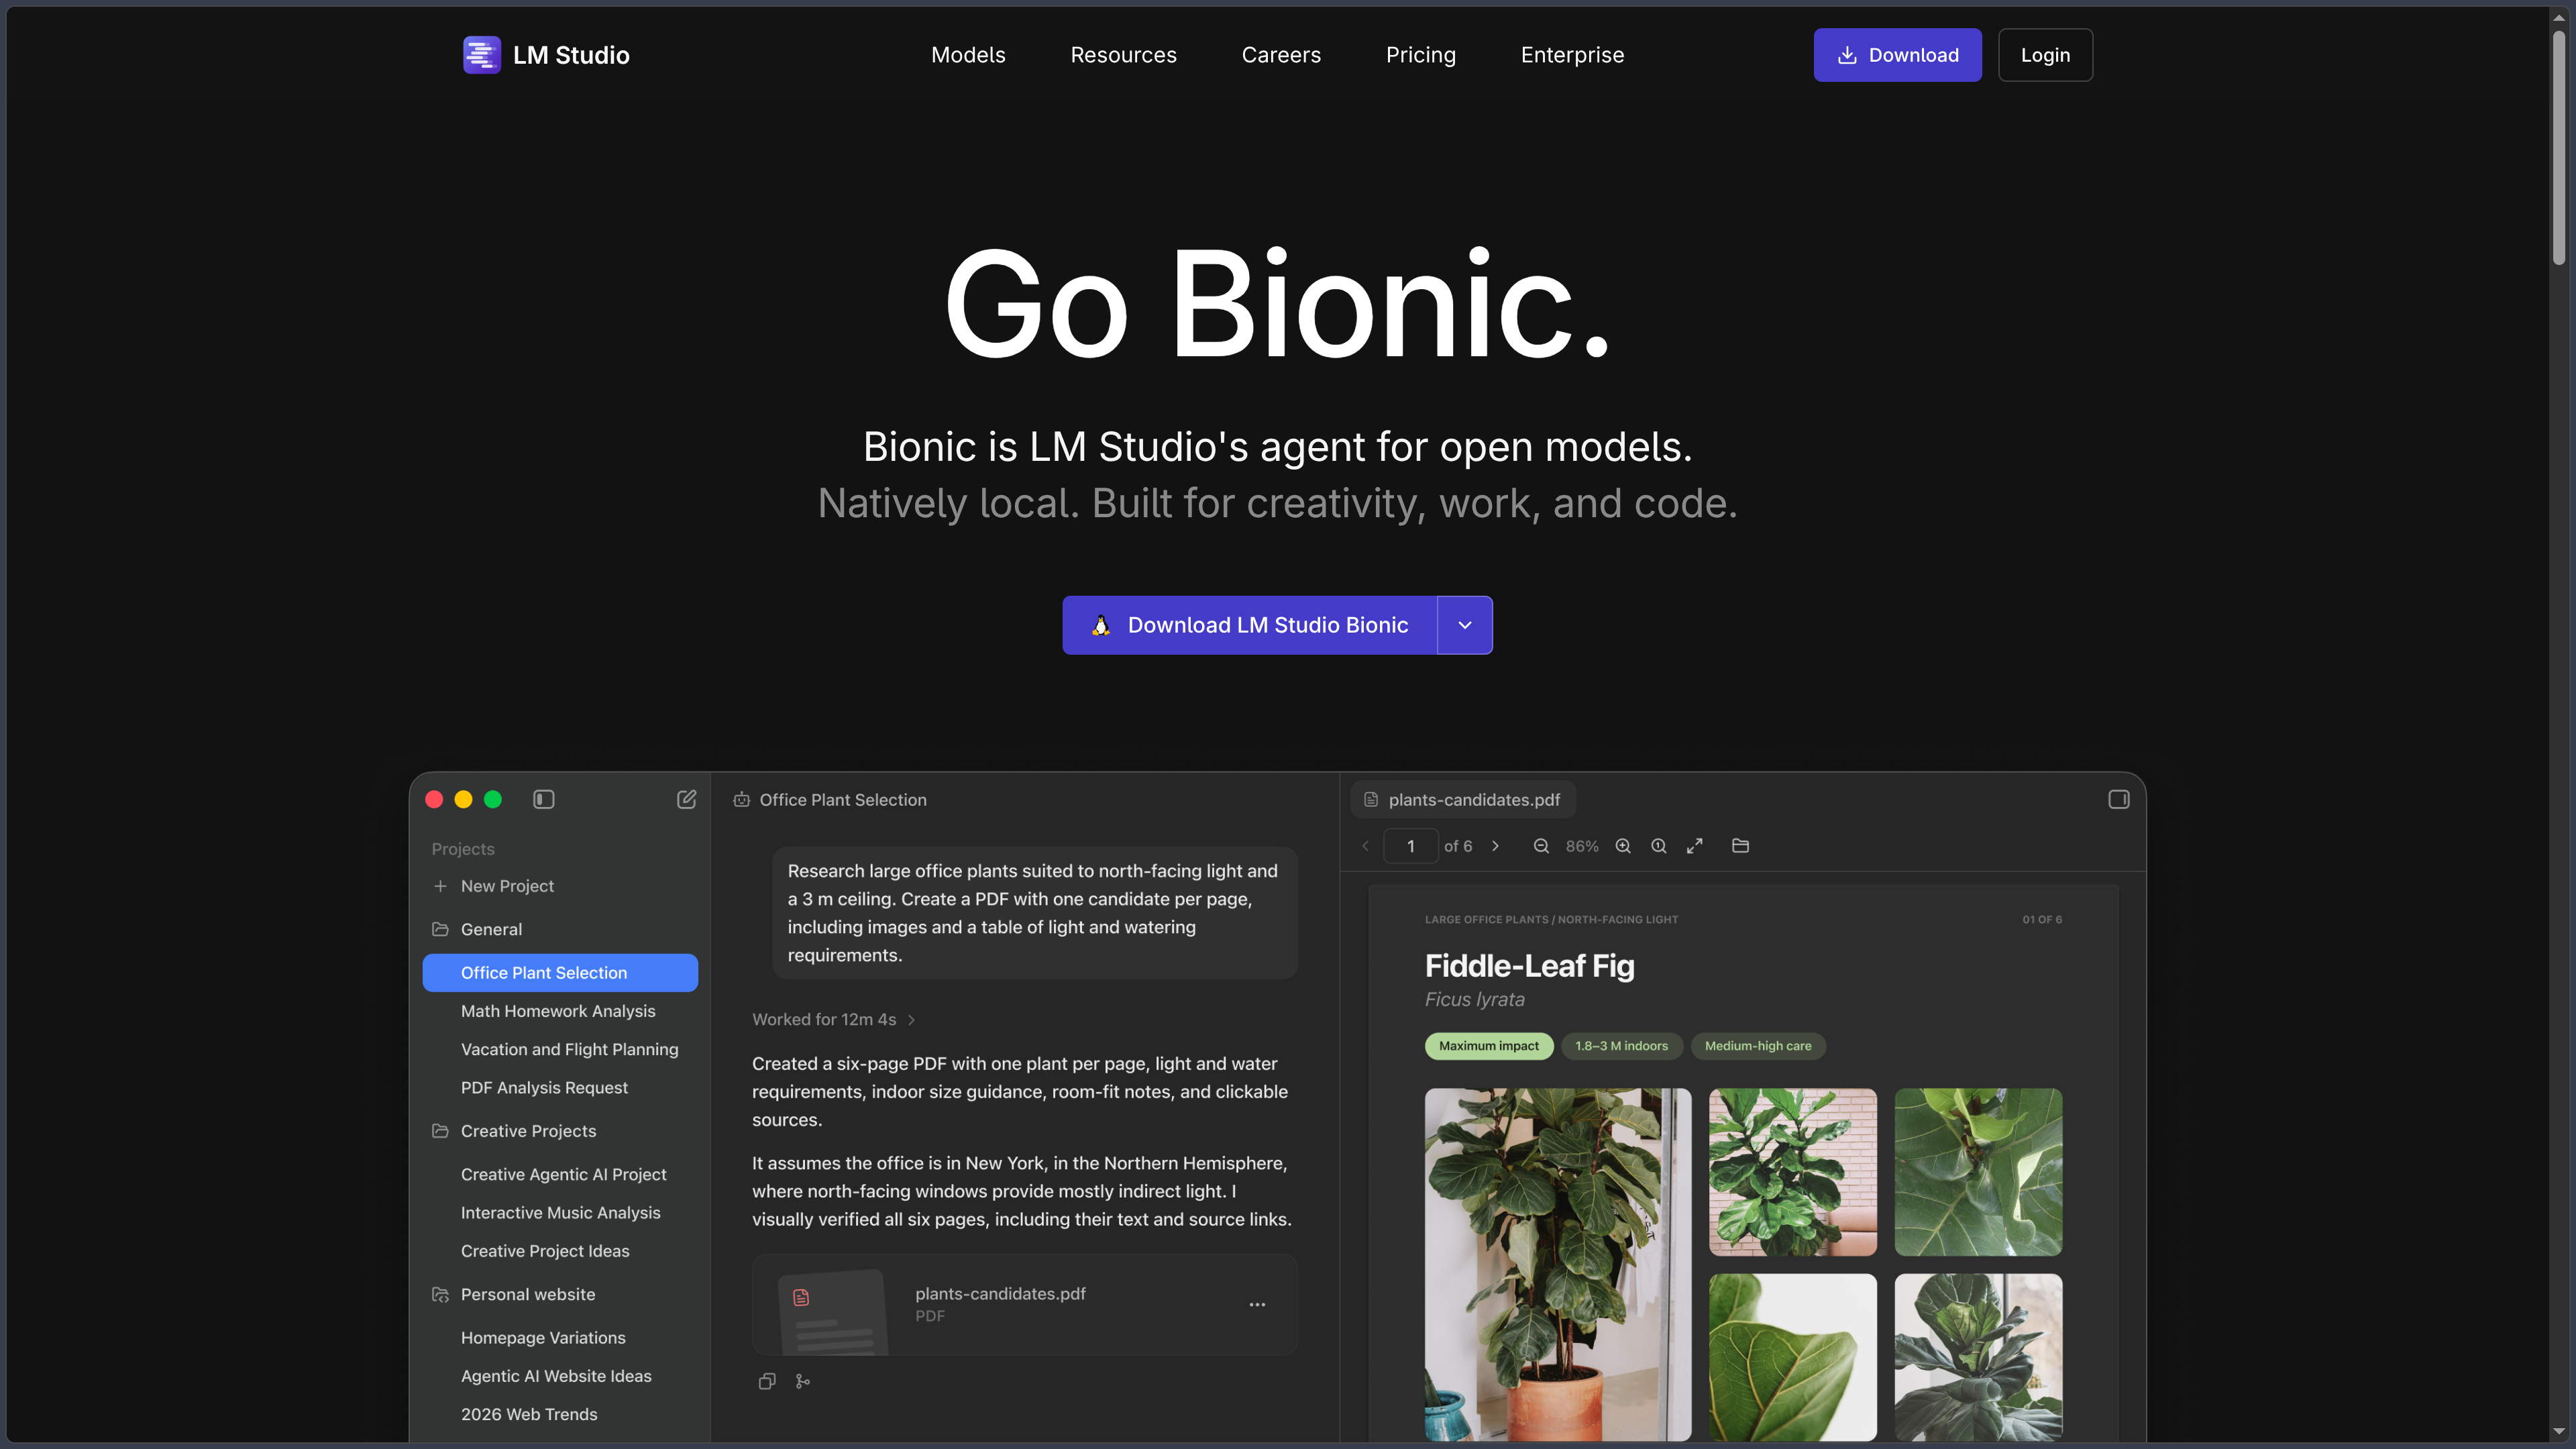
La aplicación es gratuita para uso personal y profesional interno. Sigue siendo propietaria, aunque algunos motores y herramientas de su ecosistema sean open source. También hay que distinguir LM Studio Desktop de LM Studio Bionic, otra aplicación del mismo desarrollador orientada al trabajo con agentes y modelos en la nube opcionales: las suscripciones de Bionic no constituyen una suscripción obligatoria a LM Studio.
Funcionalidades
Descubrir, descargar y organizar modelos
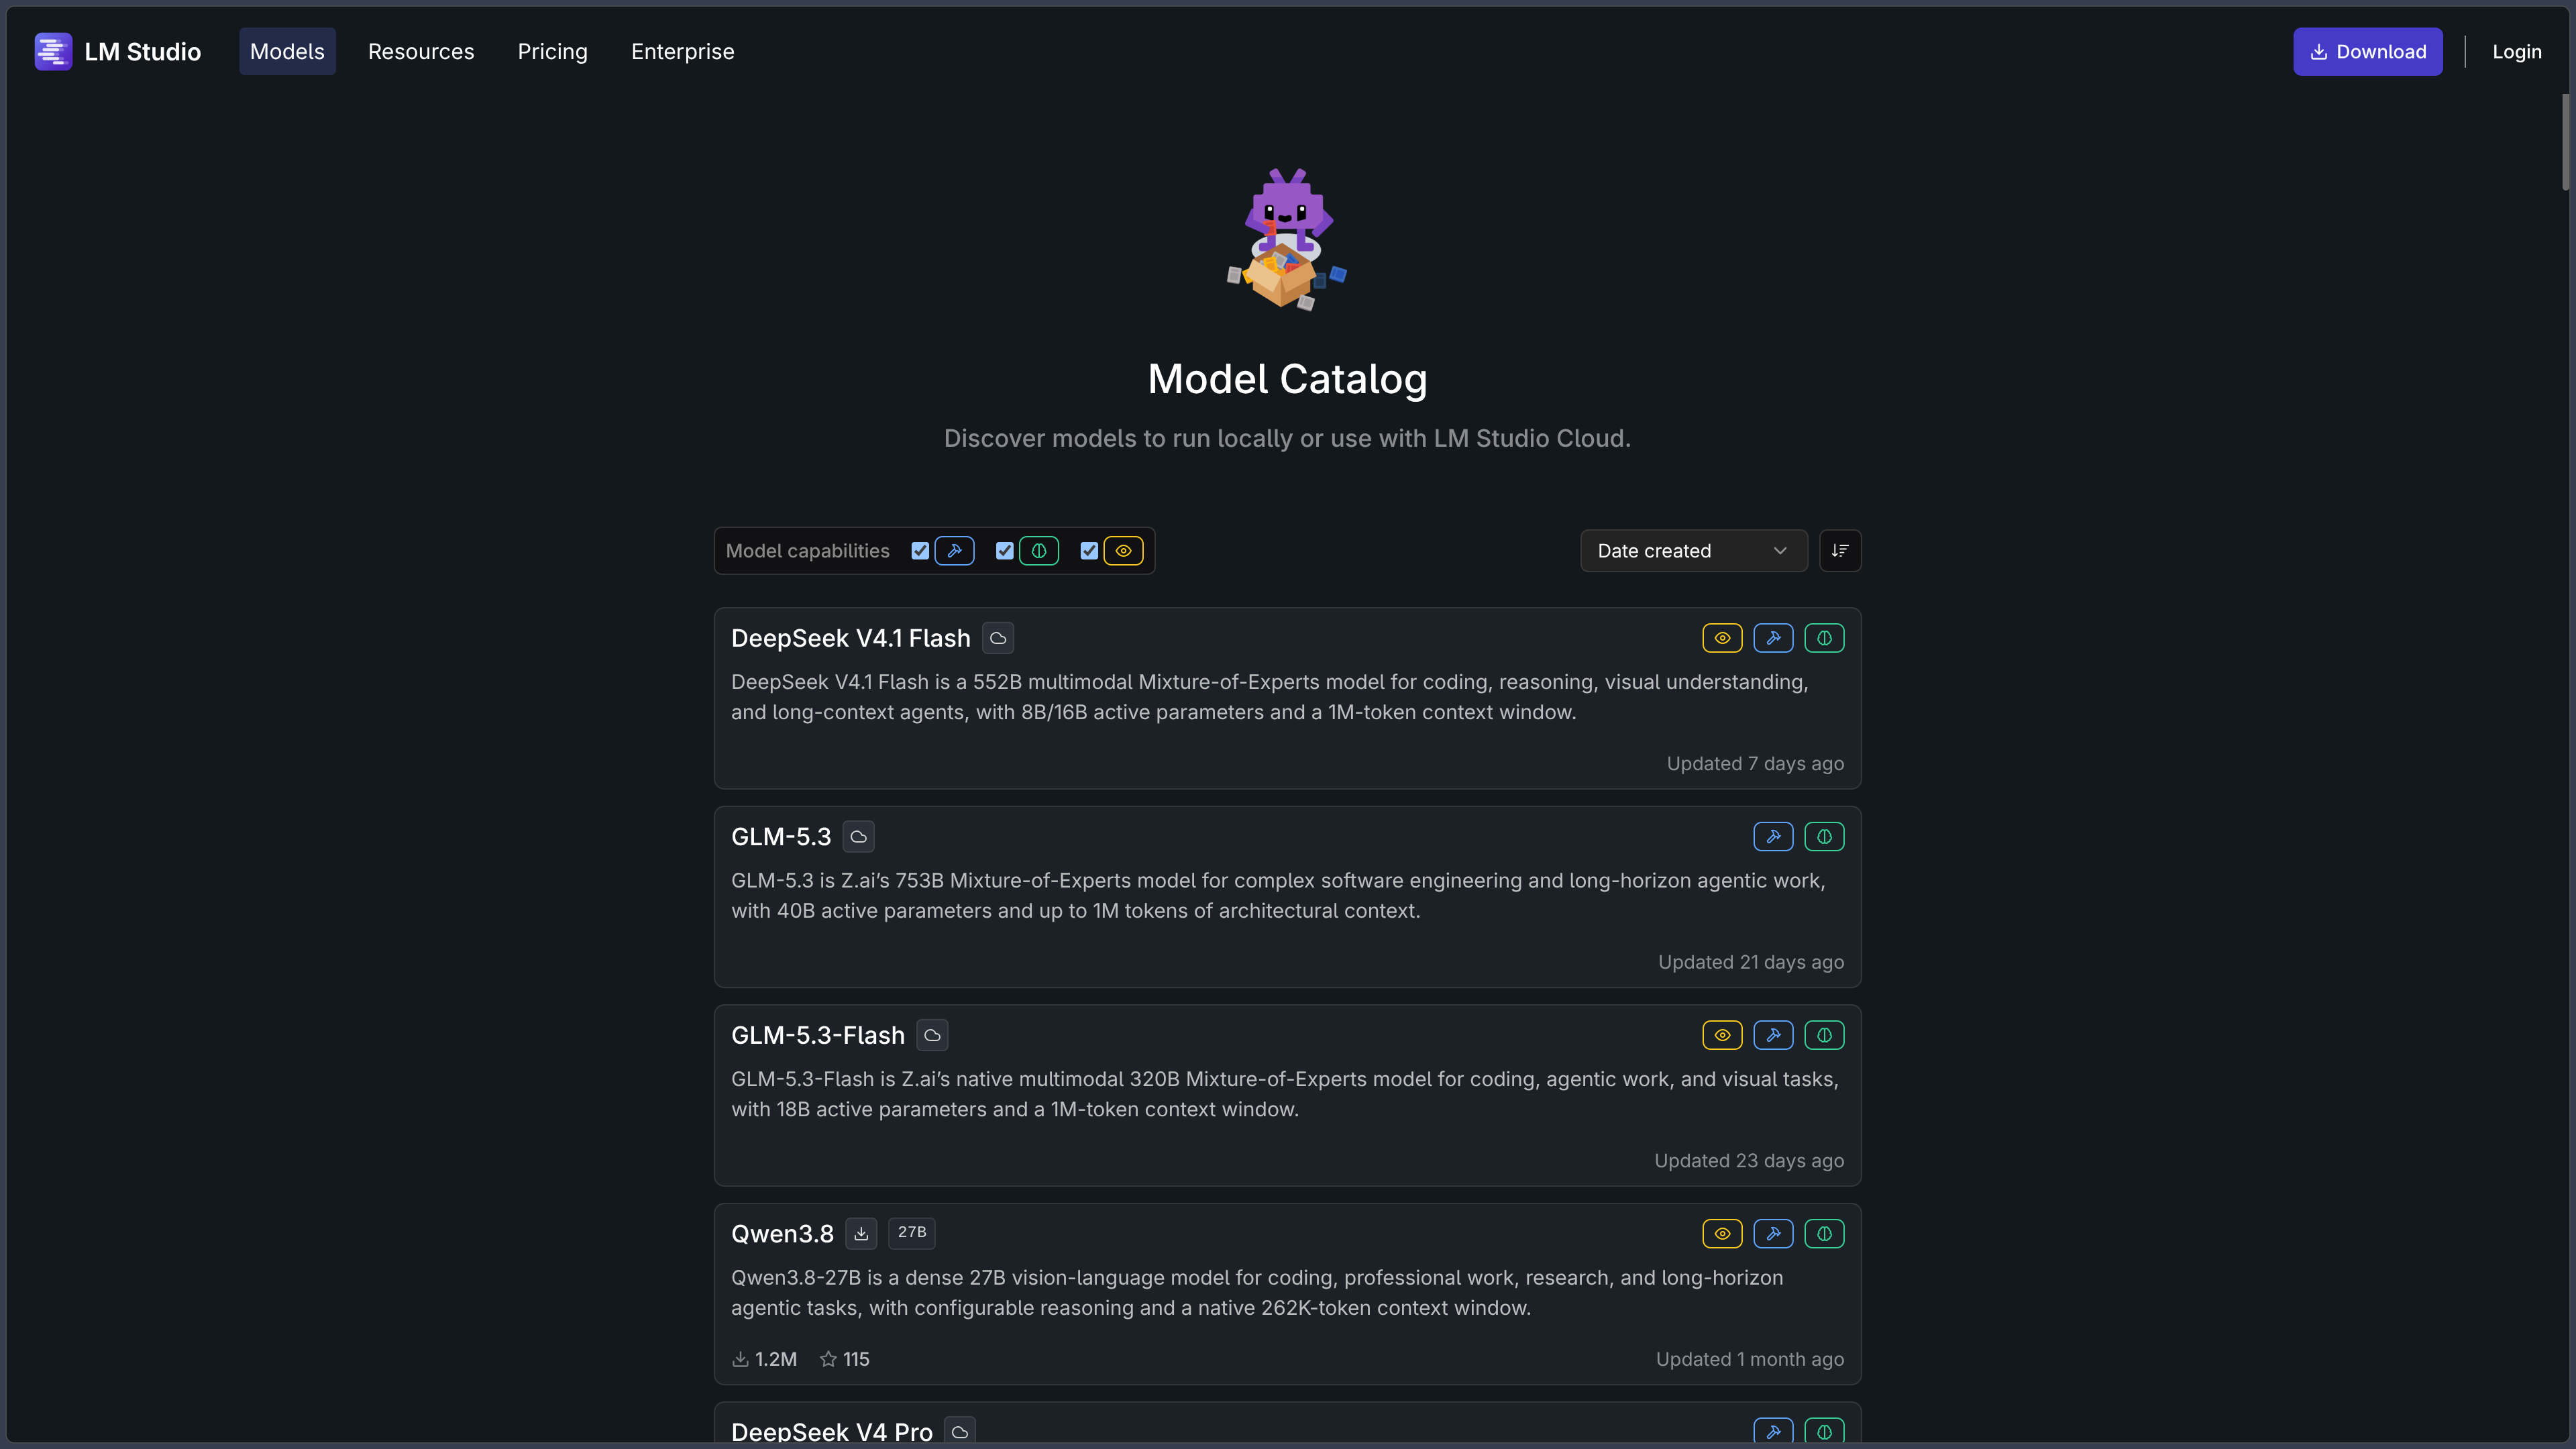
La interfaz permite explorar un catálogo de modelos y buscar archivos distribuidos, entre otros lugares, a través de Hugging Face. Una vez elegido el modelo, LM Studio descarga sus pesos y lo añade a una biblioteca local. También es posible importar modelos compatibles obtenidos por otros medios.
La elección no se limita al nombre del modelo. Pueden ofrecerse varias variantes, especialmente según el formato GGUF o MLX y el nivel de cuantización. Una versión más cuantizada suele ocupar menos memoria, pero puede modificar la calidad de las respuestas. A la inversa, un modelo muy voluminoso puede resultar difícil de ejecutar correctamente en un equipo modesto.
LM Studio permite gestionar estos archivos y seleccionar la variante que se va a cargar. Sin embargo, no hay que confundir la presencia de un modelo en el catálogo con una autorización universal para reutilizarlo: cada modelo tiene su propia licencia, a veces sujeta a condiciones comerciales particulares.
Conversar con un modelo y ajustar su ejecución
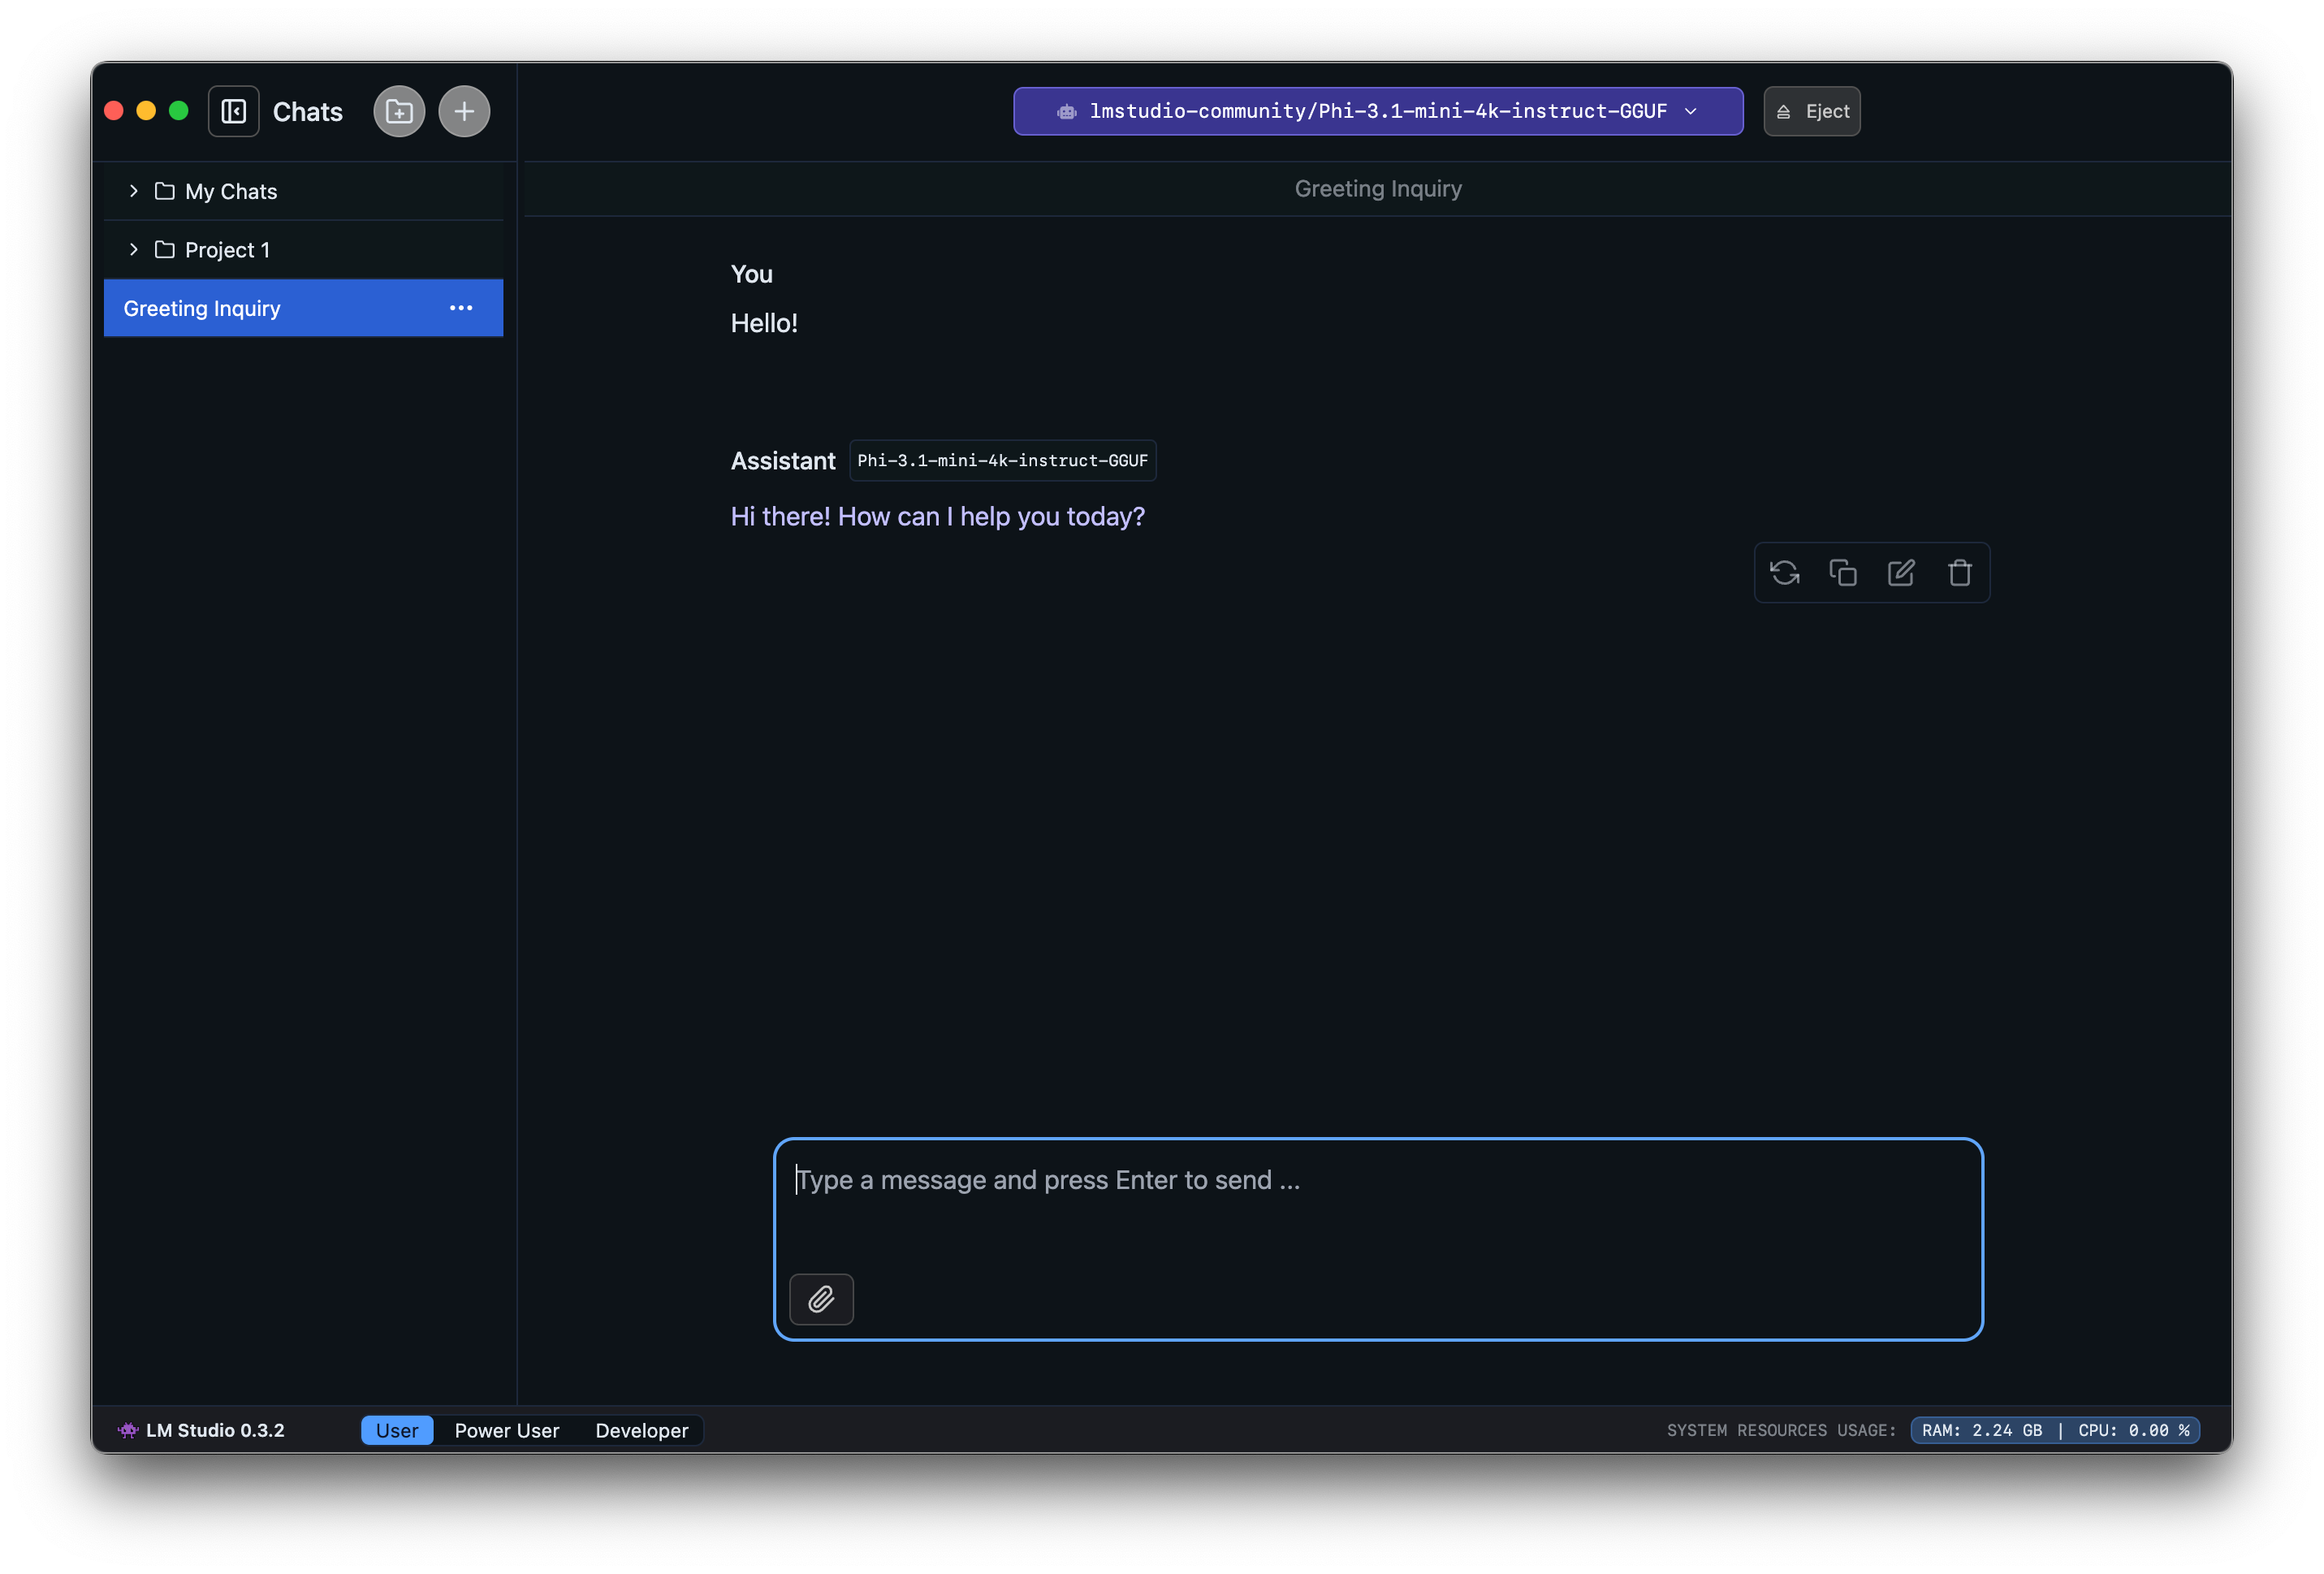
El chat integrado permite probar directamente un modelo descargado: redacción, explicación de código, síntesis, reformulación o preguntas generales. El usuario puede conservar varias conversaciones y exportar sus intercambios en formato de texto, Markdown o PDF. Algunas capacidades, como el análisis de imágenes o la llamada a herramientas, siguen dependiendo del modelo que se haya cargado.
Los parámetros de inferencia ofrecen más control que una interfaz de conversación convencional. Es posible ajustar especialmente el tamaño del contexto, la temperatura o la distribución del cálculo entre el procesador y la tarjeta gráfica. Los ajustes de carga pueden guardarse para un modelo y reutilizarse en sesiones posteriores.
Este control tiene una contrapartida: los resultados dependen en gran medida de la combinación de modelo y hardware. Una ventana de contexto larga aumenta las necesidades de memoria; una cuantización demasiado agresiva puede degradar las respuestas; un modelo poco adecuado para una tarea no se vuelve eficaz por el mero hecho de ejecutarse en local.
Consultar documentos sin enviarlos a un servicio externo
LM Studio admite documentos PDF, DOCX y TXT como archivos adjuntos de una conversación. Cuando un archivo cabe en la ventana de contexto del modelo, su contenido puede añadirse directamente al intercambio. Para documentos más largos, el programa puede recurrir a un enfoque de generación aumentada por recuperación (RAG): busca fragmentos relevantes y se los proporciona al modelo para construir la respuesta.
Este funcionamiento resulta útil para consultar un manual, resumir documentación o hacer preguntas sobre un conjunto de notas. No obstante, sigue limitado por la calidad de la búsqueda y el contexto disponible: puede que no se recupere un fragmento importante y que el modelo interprete mal una fuente. Por tanto, las respuestas deben comprobarse cuando sirven para verificar una información precisa.
Con un modelo descargado y un uso estrictamente local, el tratamiento de los documentos puede realizarse sin conexión. Esta garantía no debe extenderse automáticamente a herramientas externas ni a otras aplicaciones conectadas a un servicio en la nube.
Poner los modelos a disposición mediante una API local
LM Studio puede iniciar un servidor de inferencia HTTP desde su espacio para desarrolladores. Otra aplicación puede enviar entonces solicitudes al modelo cargado sin pasar por una API remota de generación. El servidor escucha de forma predeterminada en localhost:1234 y también puede configurarse para funcionar en la red local.
El entorno ofrece una API REST nativa, además de interfaces compatibles con las API de OpenAI y Anthropic. Esta compatibilidad facilita la conexión de programas, scripts o asistentes que permiten personalizar la dirección de su proveedor de modelos. Los desarrolladores también pueden utilizar los SDK oficiales de Python y TypeScript/JavaScript.
La API nativa v1 añade gestión de modelos, conversaciones con estado y funciones de control del servidor. Desde la rama 0.4, la inferencia también puede procesar varias solicitudes en paralelo mediante continuous batching, dependiendo de los ajustes y las capacidades del motor utilizado.
La seguridad del servidor merece especial atención: su funcionamiento en localhost no debe confundirse con abrirlo a la red. El servidor puede configurarse con autenticación mediante tokens; exponer su puerto a otros dispositivos o activar CORS sin necesidad aumenta la superficie de acceso.
Interfaz gráfica, terminal y ejecución sin interfaz
LM Studio ya no se limita a su ventana de escritorio. Su ecosistema comprende tres componentes complementarios:
| Componente | Función |
|---|---|
| LM Studio Desktop | Interfaz gráfica para descubrir modelos, conversar, gestionar los ajustes e iniciar el servidor. |
lms |
Interfaz de línea de comandos para descargar, cargar y descargar de memoria modelos, conversar y controlar el servidor. |
llmster |
Servicio autónomo sin interfaz gráfica, adecuado para un equipo dedicado, un servidor o un entorno de integración continua. |
Esta separación permite comenzar con una interfaz accesible y automatizar progresivamente las operaciones. Un desarrollador puede, por ejemplo, descargar un modelo, cargarlo con unos parámetros definidos e iniciar su servidor desde el terminal. La carga bajo demanda y la descarga automática de memoria también ayudan a evitar que esta permanezca ocupada innecesariamente.
La presencia de llmster explica la compatibilidad con un uso autoalojado: la inferencia puede funcionar en una máquina controlada por el usuario sin necesidad de mantener una sesión gráfica permanente.
Herramientas MCP e integraciones de desarrollo
LM Studio admite el Model Context Protocol (MCP), que permite a un modelo compatible interactuar con herramientas proporcionadas por servidores externos o locales. Estas integraciones pueden ampliar las capacidades de una conversación más allá de la simple generación de texto, por ejemplo para consultar un recurso o desencadenar una operación autorizada.
La compatibilidad con herramientas depende del modelo elegido, de la configuración de los servidores MCP y de los permisos concedidos. Las API también permiten utilizar servidores configurados previamente o, cuando la opción está activada, servidores definidos para una solicitud concreta.
Esta flexibilidad conlleva un riesgo real: una herramienta con acceso al sistema de archivos o a datos privados puede dar al modelo la capacidad de actuar sobre esos recursos. Los permisos deben limitarse a lo estrictamente necesario, y las conexiones MCP no deben equipararse por defecto a una ejecución local aislada.
LM Link: aprovechar la potencia de otro equipo
LM Link conecta varios dispositivos para permitir que un equipo ligero utilice un modelo ejecutado en un ordenador más potente. Las comunicaciones pasan por un enlace cifrado de extremo a extremo, construido con tecnología Tailscale.
Esta función permite, por ejemplo, mantener un modelo voluminoso en una estación de trabajo y utilizarlo desde un portátil. La aplicación independiente Locally, disponible para iPhone y iPad, también puede acceder de este modo a los modelos de un ordenador con LM Studio. Esto no convierte LM Studio Desktop en una aplicación nativa para iOS o iPadOS.
LM Link necesita una conexión para establecer el enlace. Por tanto, hay que distinguir este escenario remoto de un uso completamente sin conexión en una sola máquina.
Privacidad y funcionamiento sin conexión
Una vez instalados la aplicación y los modelos, el chat, las interacciones con documentos y el servidor local pueden funcionar sin Internet. Según la política de privacidad de LM Studio, las conversaciones y los documentos procesados localmente permanecen en la máquina; en cambio, la búsqueda y descarga de modelos, así como la comprobación de actualizaciones, requieren comunicaciones de red.
Esta privacidad depende del modo de uso. Autorizar el acceso al servidor desde la red, conectar una herramienta MCP externa o utilizar una aplicación en la nube independiente modifica el alcance de la circulación de datos. El usuario debe examinar esas conexiones por separado en lugar de considerar que todo lo que lleva el nombre LM Studio funciona automáticamente sin conexión.
Casos de uso
Descubrir la IA local sin desplegar una infraestructura completa
LM Studio facilita las primeras pruebas con modelos descargables. Permite comparar varias variantes, observar su consumo de memoria y comprobar la calidad de las respuestas con el mismo conjunto de preguntas. Es una manera concreta de determinar qué puede ejecutar realmente un ordenador antes de construir un proyecto más ambicioso.
Trabajar con documentos confidenciales
Un usuario puede cargar un modelo local y después adjuntar documentación técnica, notas o un informe para obtener una síntesis o encontrar fragmentos útiles. Cuando el funcionamiento sigue siendo estrictamente local, los archivos no necesitan transmitirse a un proveedor remoto de generación. No obstante, la calidad del RAG y las respuestas del modelo deben comprobarse con los documentos originales.
Conectar una aplicación a un modelo local
El servidor API permite sustituir, para determinados usos, un proveedor remoto de generación por una instancia local. Una aplicación de chat, un entorno de desarrollo o un script de Python puede entonces llamar al modelo por HTTP o mediante un SDK. Mantener la compatibilidad con interfaces de API habituales facilita la experimentación, sin garantizar que todos los modelos tengan las mismas capacidades.
Instalar una infraestructura de inferencia personal
Con llmster, el terminal y LM Link, una estación de trabajo puede convertirse en un servidor de inferencia accesible para otros dispositivos autorizados. Esta organización resulta adecuada para pruebas automatizadas, experimentos en una red privada o el uso de un ordenador potente desde un portátil. El control de acceso y los recursos de hardware pasan entonces a ser tan importantes como la elección del modelo.
Conclusión
LM Studio hace accesible la ejecución de modelos locales sin ocultar por completo los parámetros técnicos. Su interfaz facilita el descubrimiento, la descarga y el chat, mientras que el servidor API, el terminal y llmster abren el camino a integraciones más estructuradas.
Su interés también reside en la libertad de elección: no impone un único modelo y permite adaptar el tamaño, el formato y los ajustes de ejecución al equipo disponible. El tratamiento local de documentos y conversaciones constituye una ventaja para quienes desean controlar dónde se realiza la inferencia.
Esta autonomía no elimina, sin embargo, las necesidades de hardware ni las limitaciones de los modelos. Memoria RAM, memoria de vídeo, cuantización, longitud del contexto, calidad de las respuestas y licencias de los modelos deben evaluarse antes de elegir una configuración. Una API compatible tampoco garantiza que todos los modelos gestionen correctamente herramientas, imágenes o salidas estructuradas.
Por último, LM Studio Desktop debe distinguirse de los productos relacionados de su desarrollador: Bionic es una aplicación independiente, con funciones de agente y servicios en la nube opcionales; Locally es la aplicación móvil que puede acceder a modelos mediante LM Link. Para descubrir la IA local, probar un modelo con documentos propios o crear un punto de acceso API en un equipo bajo control del usuario, LM Studio constituye un entorno coherente y evolutivo.
Puntos de atención
- LM Studio Desktop es gratuito para uso personal y profesional interno, pero su código es propietario. Los motores open source que utiliza no cambian la licencia de la aplicación.
- Las licencias de los modelos son independientes. Poder descargar un modelo no garantiza la autorización para utilizarlo comercialmente ni para redistribuir sus pesos.
- El hardware determina qué modelos pueden utilizarse. LM Studio recomienda especialmente 16 GB de RAM; en Windows x64 se necesita AVX2 y se recomienda una tarjeta gráfica con al menos 4 GB de VRAM. Las necesidades reales varían según el modelo.
- Debe comprobarse la compatibilidad del sistema. En Mac, la aplicación requiere un chip Apple Silicon y macOS 14 como mínimo; los Mac Intel no son compatibles. En Linux, la documentación oficial señala reservas sobre determinadas distribuciones y versiones.
- El RAG no garantiza una recuperación exhaustiva. En documentos largos, puede que algunos fragmentos no se encuentren y las respuestas deben contrastarse con las fuentes.
- El servidor API no debe exponerse sin precauciones. Restringir la escucha a
localhostcuando sea posible y activar la autenticación para accesos de red o integraciones sensibles. - MCP y LM Link amplían el perímetro de confianza. Una herramienta externa puede acceder a recursos autorizados; LM Link necesita una conexión para establecer un enlace remoto.
- Bionic y Locally son aplicaciones independientes. Las suscripciones en la nube de Bionic y las funciones móviles de Locally no deben atribuirse a LM Studio Desktop.
- El uso local puede funcionar sin conexión después de las descargas, pero la búsqueda de modelos, las actualizaciones y cualquier servicio externo activado requieren una evaluación específica de sus intercambios de datos.