Présentation
LM Studio est une application de bureau dédiée à l’exécution de modèles d’intelligence artificielle sur son propre ordinateur. Elle permet de rechercher des modèles, de télécharger leurs fichiers, de les charger en mémoire et de discuter avec eux sans devoir configurer manuellement toute une infrastructure d’inférence. Développée par Element Labs, elle est disponible sur Windows, macOS et Linux.
Le principe est simple : LM Studio fournit l’environnement d’exécution, mais pas un modèle unique imposé. L’utilisateur peut choisir parmi des modèles compatibles, notamment des familles comme Llama, Qwen, Mistral ou gpt-oss. Leurs capacités, leur taille et leur licence dépendent de leurs éditeurs respectifs. Le logiciel utilise principalement le moteur llama.cpp pour les modèles GGUF et prend aussi en charge MLX sur les Mac équipés d’une puce Apple Silicon.
Au-delà du chat, LM Studio peut consulter des documents, exposer les modèles à d’autres applications par une API locale et servir de base à des expérimentations de développement. Sa branche 0.4, lancée en janvier 2026, a notamment introduit une architecture de service autonome, les requêtes parallèles et une API REST renouvelée. La version 0.4.25, publiée le 19 septembre 2026, poursuit cette évolution.
L’application est gratuite pour un usage personnel et professionnel interne. Elle reste propriétaire, même si certains moteurs et outils de son écosystème sont open source. Il faut également distinguer LM Studio Desktop de LM Studio Bionic, une autre application du même éditeur, orientée vers le travail avec des agents et des modèles cloud optionnels : les abonnements Bionic ne constituent pas un abonnement obligatoire à LM Studio.
Fonctionnalités
Découvrir, télécharger et organiser des modèles
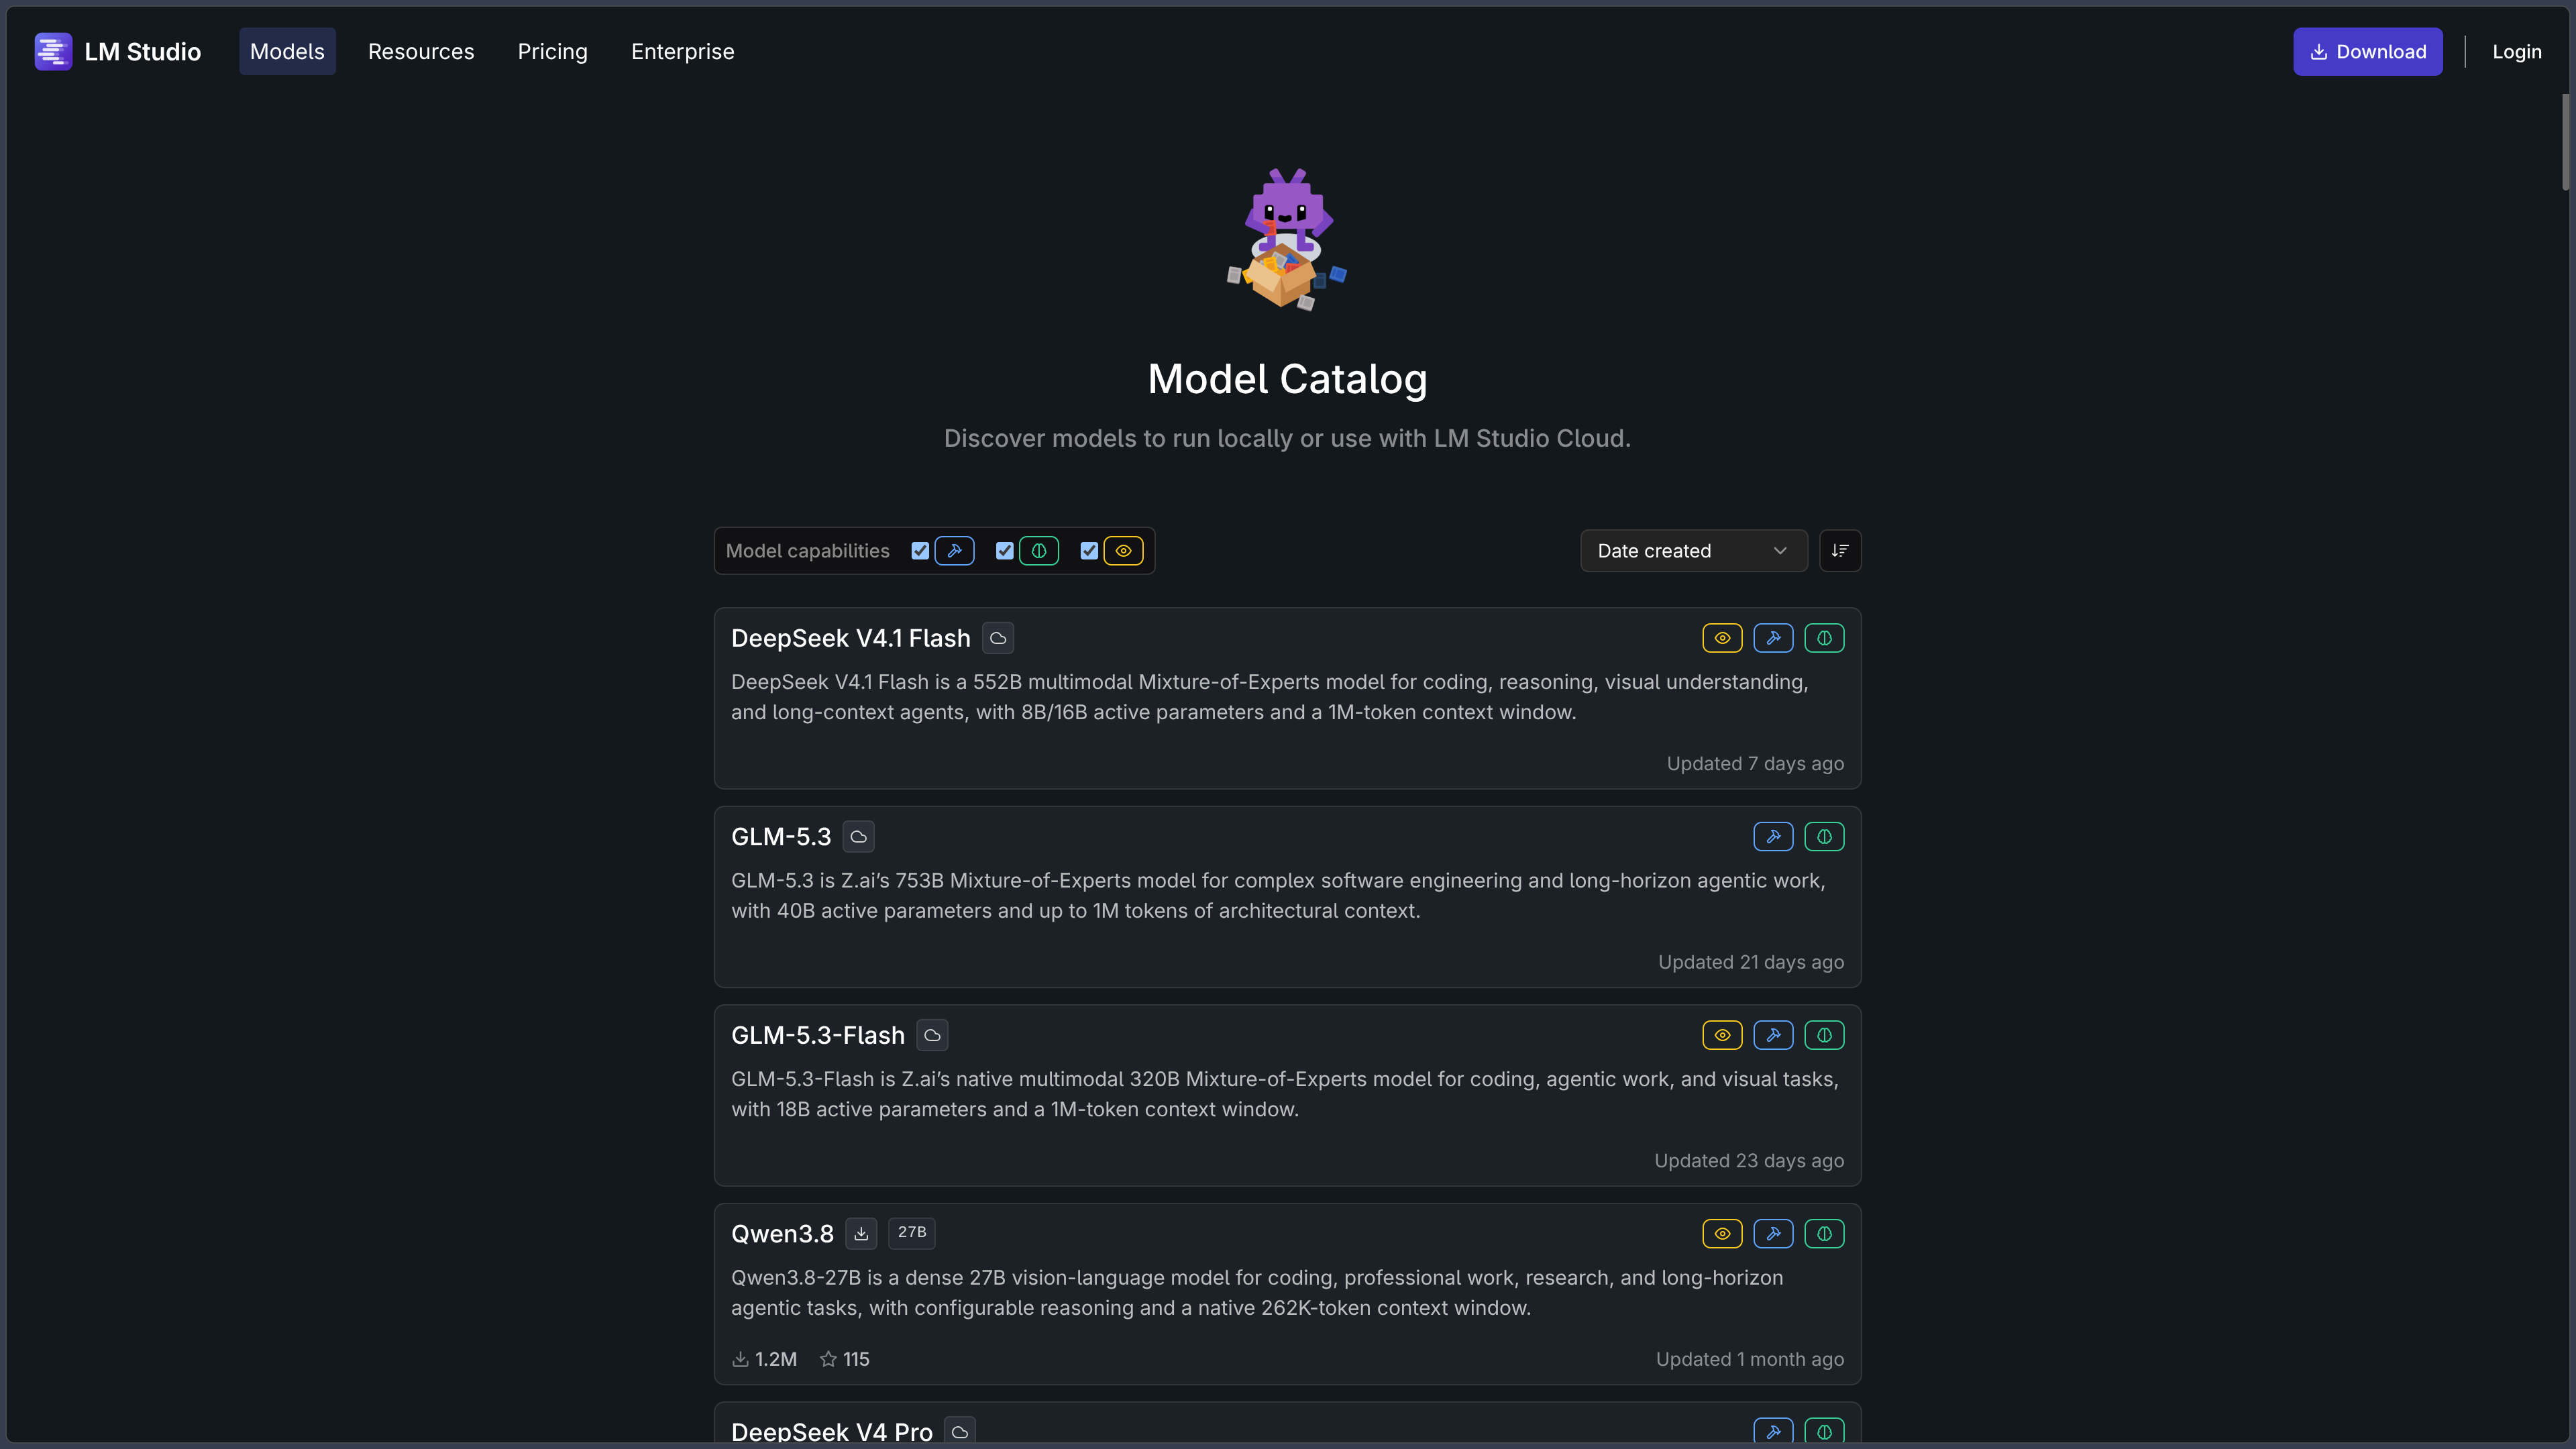
L’interface permet d’explorer un catalogue de modèles et de rechercher des fichiers distribués notamment par Hugging Face. Une fois le modèle choisi, LM Studio télécharge ses poids puis l’ajoute à une bibliothèque locale. Il est également possible d’importer des modèles compatibles obtenus par d’autres moyens.
Le choix ne se limite pas au nom du modèle. Plusieurs variantes peuvent être proposées, notamment selon le format GGUF ou MLX et le niveau de quantification. Une version plus fortement quantifiée occupe généralement moins d’espace mémoire, mais peut modifier la qualité des réponses. Un modèle très volumineux peut, à l’inverse, devenir difficile à exécuter correctement sur une machine modeste.
LM Studio permet de gérer ces fichiers et de sélectionner la variante à charger. Il ne faut cependant pas confondre la présence d’un modèle dans le catalogue avec une autorisation universelle de réutilisation : chaque modèle possède sa propre licence, parfois assortie de conditions commerciales particulières.
Discuter avec un modèle et régler son exécution
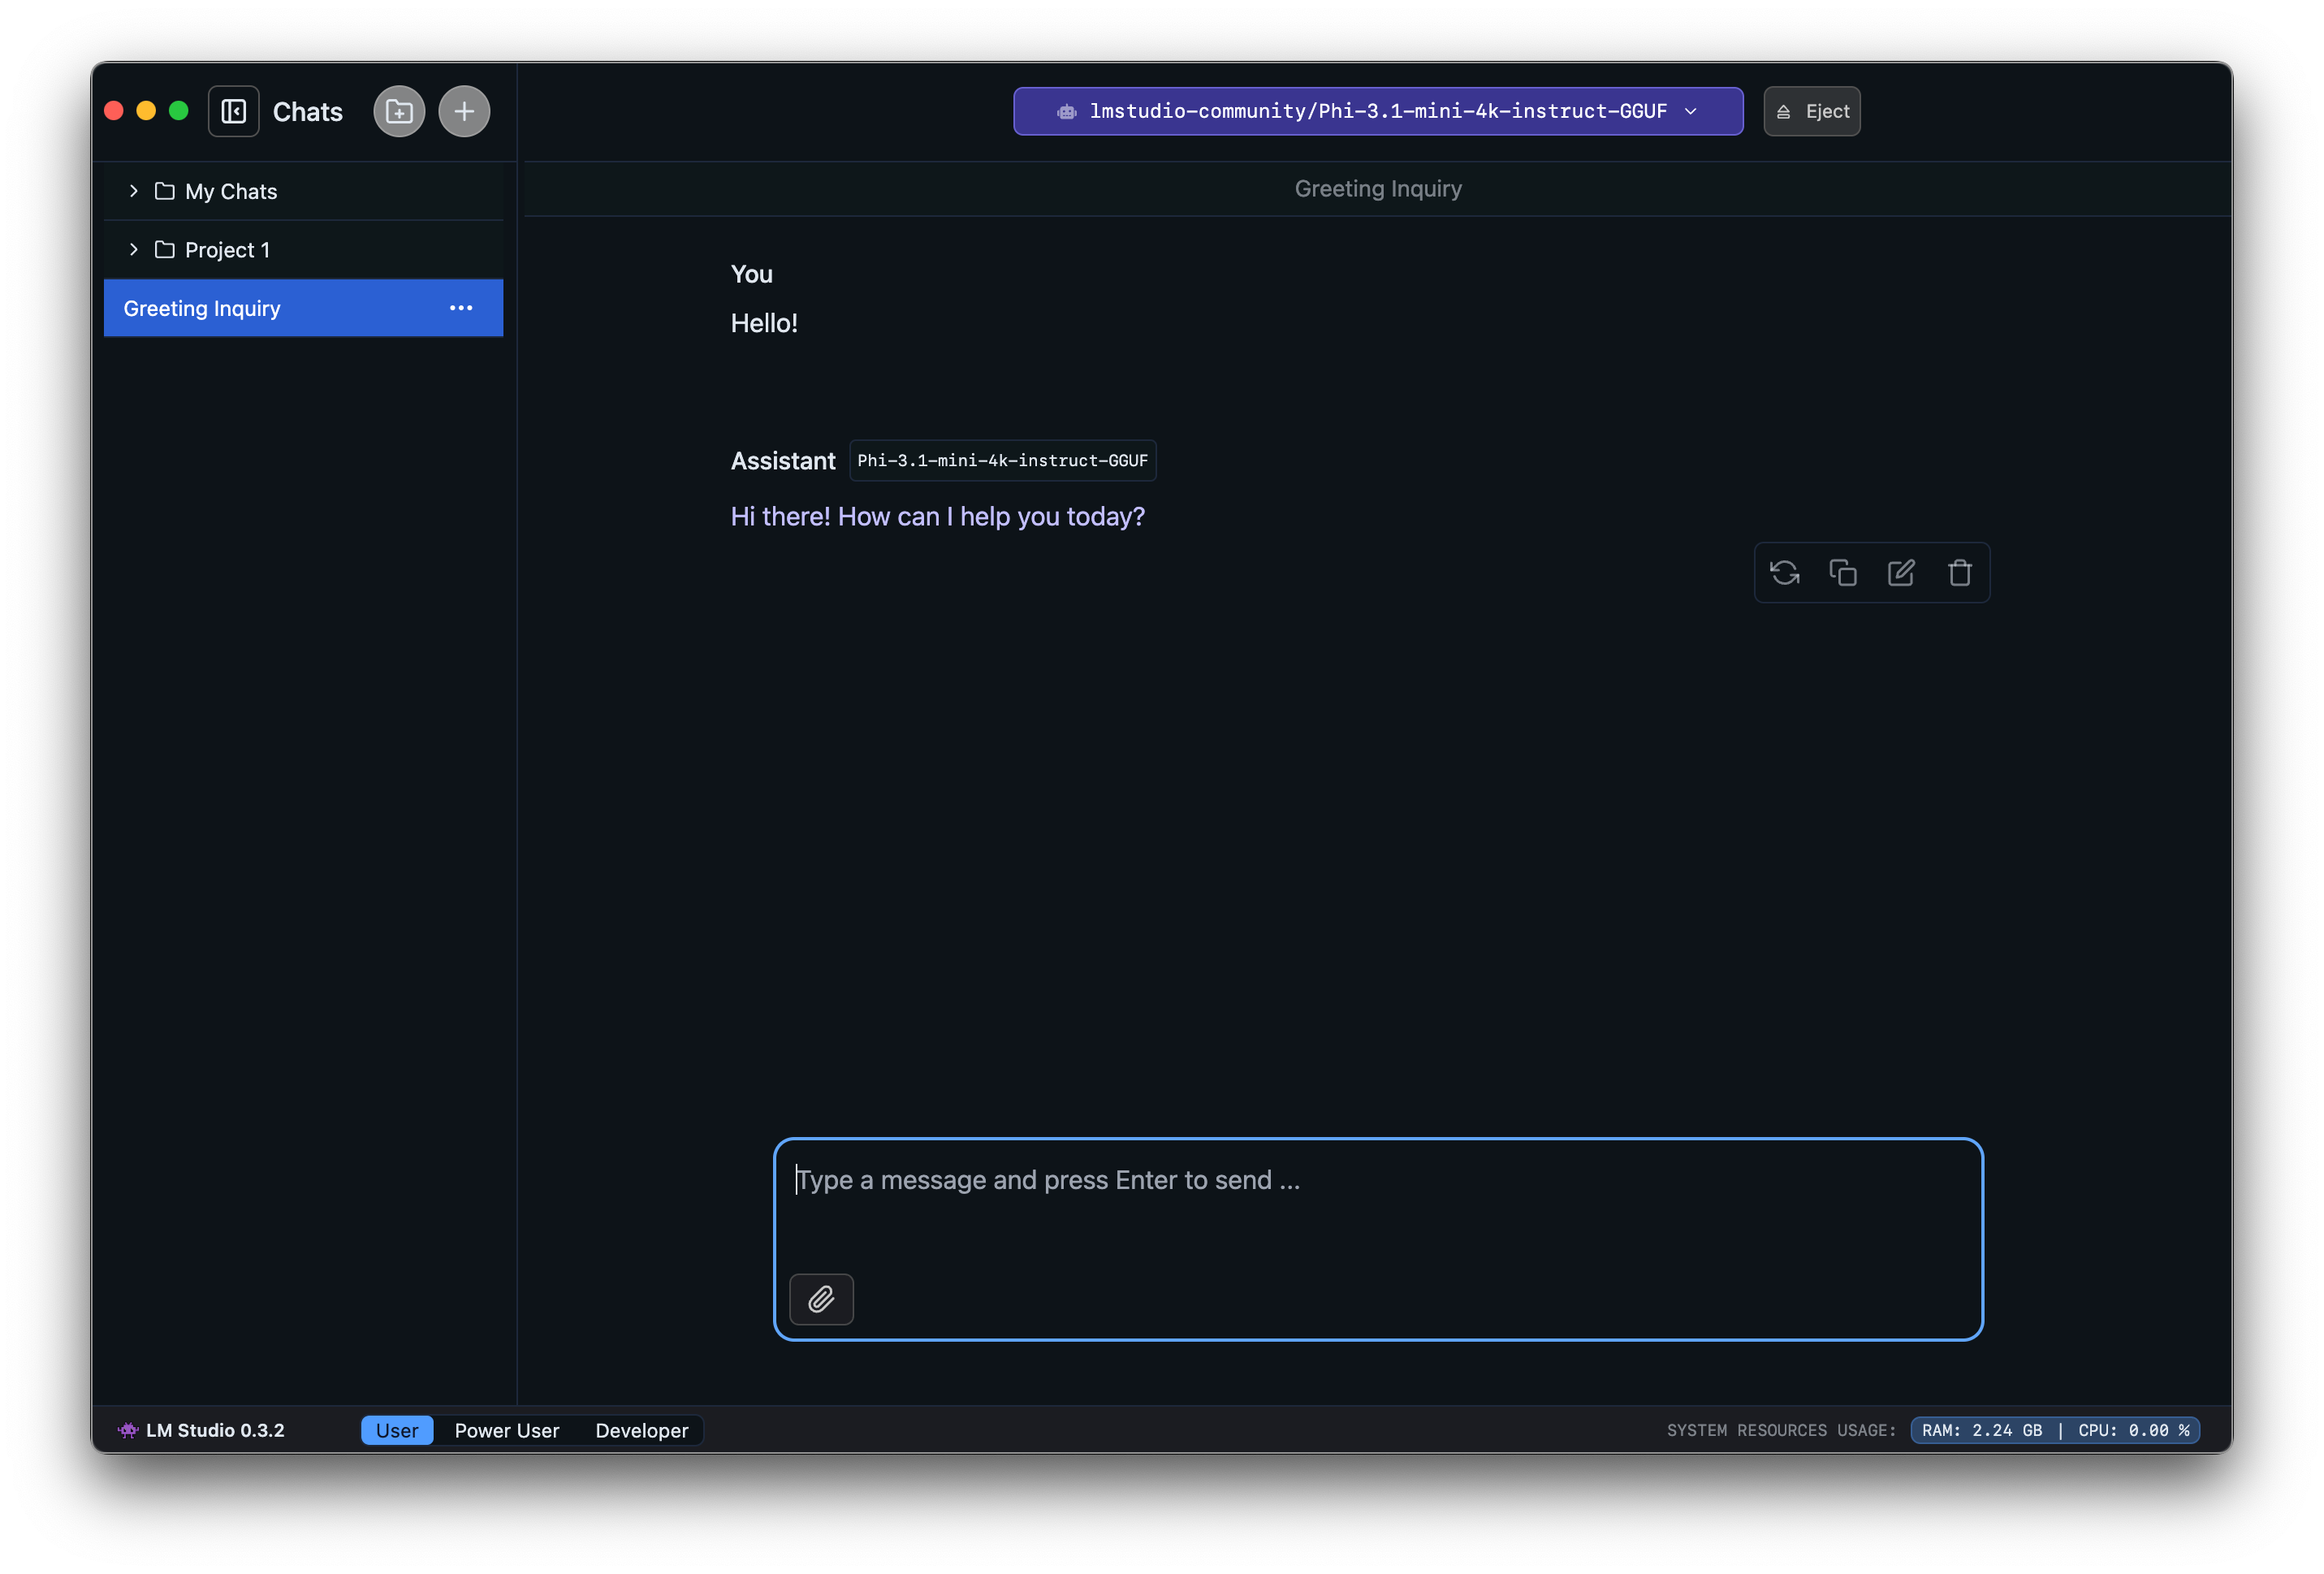
Le chat intégré sert à tester directement un modèle téléchargé : rédaction, explication de code, synthèse, reformulation ou questions générales. L’utilisateur peut conserver plusieurs conversations et exporter ses échanges au format texte, Markdown ou PDF. Certaines capacités, comme l’analyse d’images ou l’appel d’outils, restent conditionnées au modèle effectivement chargé.
Les paramètres d’inférence donnent davantage de contrôle qu’une interface de discussion classique. On peut notamment ajuster la taille du contexte, la température ou la répartition du calcul entre processeur et carte graphique. Les réglages de chargement peuvent être sauvegardés pour un modèle et réutilisés lors des sessions suivantes.
Ce contrôle a une contrepartie : les résultats dépendent fortement du couple modèle–matériel. Une fenêtre de contexte longue augmente les besoins en mémoire ; une quantification trop agressive peut dégrader les réponses ; un modèle mal adapté à la tâche ne devient pas performant simplement parce qu’il tourne en local.
Interroger ses documents sans les envoyer à un service externe
LM Studio accepte des documents PDF, DOCX et TXT en pièce jointe d’une conversation. Lorsqu’un fichier entre dans la fenêtre de contexte du modèle, son contenu peut être ajouté directement à l’échange. Pour les documents plus longs, le logiciel peut recourir à une approche de recherche augmentée par génération (RAG) : il recherche des passages pertinents puis les fournit au modèle pour construire la réponse.
Ce fonctionnement est utile pour consulter un manuel, résumer une documentation ou poser des questions sur un ensemble de notes. Il reste néanmoins limité par la qualité de la recherche et par le contexte disponible : un passage important peut ne pas être retrouvé et le modèle peut mal interpréter une source. Les réponses doivent donc être contrôlées lorsqu’elles servent à vérifier une information précise.
Avec un modèle téléchargé et une utilisation strictement locale, le traitement des documents peut se faire hors connexion. Cette garantie ne doit pas être étendue automatiquement à des outils externes ou à d’autres applications connectées à un service cloud.
Mettre les modèles à disposition par une API locale
LM Studio peut lancer un serveur d’inférence HTTP depuis son espace développeur. Une autre application peut alors envoyer des requêtes au modèle chargé, sans passer par une API distante de génération. Le serveur écoute par défaut sur localhost:1234 et peut également être configuré pour fonctionner sur le réseau local.
L’environnement propose une API REST native ainsi que des interfaces compatibles avec les API d’OpenAI et d’Anthropic. Cette compatibilité simplifie le raccordement de logiciels, scripts ou assistants capables de personnaliser l’adresse de leur fournisseur de modèles. Les développeurs peuvent également utiliser les SDK officiels Python et TypeScript/JavaScript.
L’API native v1 ajoute la gestion des modèles, des conversations avec état et des fonctions de contrôle du serveur. Depuis la branche 0.4, l’inférence peut aussi traiter plusieurs requêtes en parallèle grâce au continuous batching, sous réserve des réglages et des capacités du moteur utilisé.
La sécurité du serveur mérite une attention particulière : le fonctionnement sur localhost ne doit pas être confondu avec une ouverture sur le réseau. Le serveur peut être configuré avec une authentification par jeton ; exposer son port à d’autres appareils ou activer CORS sans nécessité augmente la surface d’accès.
Interface graphique, terminal et exécution sans interface
LM Studio ne se limite plus à sa fenêtre de bureau. Son écosystème comprend trois composants complémentaires :
| Composant | Rôle |
|---|---|
| LM Studio Desktop | Interface graphique pour découvrir les modèles, discuter, gérer les réglages et lancer le serveur. |
lms |
Interface en ligne de commande pour télécharger, charger et décharger des modèles, discuter et piloter le serveur. |
llmster |
Service autonome sans interface graphique, adapté à une machine dédiée, un serveur ou un environnement d’intégration continue. |
Cette séparation permet de commencer par une interface accessible, puis d’automatiser progressivement les opérations. Un développeur peut, par exemple, télécharger un modèle, le charger avec des paramètres définis et démarrer son serveur depuis le terminal. La gestion du chargement à la demande et du déchargement automatique aide également à éviter de monopoliser inutilement la mémoire.
La présence de llmster explique le support d’un usage auto-hébergé : l’inférence peut fonctionner sur une machine contrôlée par l’utilisateur sans nécessiter une session graphique permanente.
Outils MCP et intégrations de développement
LM Studio prend en charge le Model Context Protocol (MCP), qui permet à un modèle compatible d’interagir avec des outils fournis par des serveurs externes ou locaux. Ces intégrations peuvent étendre les capacités d’une conversation au-delà de la simple génération de texte, par exemple pour consulter une ressource ou déclencher une opération autorisée.
La prise en charge des outils dépend du modèle choisi, de la configuration des serveurs MCP et des permissions accordées. Les API permettent également d’utiliser des serveurs configurés à l’avance ou, lorsque l’option est activée, des serveurs définis pour une requête précise.
Cette souplesse s’accompagne d’un risque réel : un outil ayant accès au système de fichiers ou à des données privées peut donner au modèle la capacité d’agir sur ces ressources. Les autorisations doivent rester limitées à ce qui est nécessaire, et les connexions MCP ne doivent pas être assimilées à une exécution locale isolée par défaut.
LM Link : utiliser la puissance d’une autre machine
LM Link relie plusieurs appareils pour permettre à une machine légère de solliciter un modèle exécuté sur un ordinateur plus puissant. Les communications passent par une liaison chiffrée de bout en bout, construite avec la technologie Tailscale.
Cette fonction permet, par exemple, de conserver un modèle volumineux sur une station de travail et de l’utiliser depuis un ordinateur portable. L’application distincte Locally, disponible sur iPhone et iPad, peut aussi accéder aux modèles d’un ordinateur LM Studio par ce moyen. Cela ne fait pas de LM Studio Desktop une application native iOS ou iPadOS.
LM Link nécessite une connexion pour établir la liaison. Il faut donc distinguer ce scénario distant d’un usage totalement hors connexion sur une seule machine.
Confidentialité et fonctionnement hors connexion
Une fois l’application et les modèles installés, le chat, les échanges avec les documents et le serveur local peuvent fonctionner sans Internet. Selon la politique de confidentialité de LM Studio, les conversations et documents traités en local restent sur la machine ; la recherche et le téléchargement de modèles ainsi que la vérification des mises à jour nécessitent en revanche des communications réseau.
Cette confidentialité dépend du mode d’utilisation. Autoriser un serveur sur le réseau, connecter un outil MCP externe ou utiliser une application cloud distincte change le périmètre de circulation des données. L’utilisateur doit examiner séparément ces connexions plutôt que de considérer que tout ce qui porte le nom LM Studio est automatiquement hors ligne.
Cas d’usage
Découvrir l’IA locale sans déployer une infrastructure complète
LM Studio facilite les premiers essais avec des modèles téléchargeables. Il permet de comparer plusieurs variantes, d’observer leur consommation mémoire et de tester la qualité des réponses sur un même ensemble de questions. C’est une manière concrète de déterminer ce qu’un ordinateur peut réellement exécuter avant de construire un projet plus ambitieux.
Travailler sur des documents confidentiels
Un utilisateur peut charger un modèle local puis joindre une documentation technique, des notes ou un rapport pour en obtenir une synthèse ou retrouver des passages utiles. Lorsque le fonctionnement reste strictement local, les fichiers n’ont pas à être transmis à un fournisseur de génération distant. La qualité du RAG et les réponses du modèle doivent toutefois être vérifiées sur les documents originaux.
Connecter une application à un modèle local
Le serveur API permet de remplacer, pour certains usages, un fournisseur de génération distant par une instance locale. Une application de chat, un environnement de développement ou un script Python peut alors appeler le modèle par HTTP ou par SDK. Le maintien de la compatibilité avec les interfaces d’API courantes facilite l’expérimentation, sans garantir que chaque modèle possède les mêmes capacités.
Installer une infrastructure d’inférence personnelle
Avec llmster, le terminal et LM Link, une station de travail peut devenir un serveur d’inférence accessible à d’autres appareils autorisés. Cette organisation convient aux tests automatisés, aux expérimentations sur un réseau privé ou à l’utilisation d’un ordinateur puissant depuis un portable. Le contrôle des accès et les ressources matérielles deviennent alors aussi importants que le choix du modèle.
Conclusion
LM Studio rend l’exécution de modèles locaux accessible sans masquer complètement les paramètres techniques. Son interface facilite la découverte, le téléchargement et le chat, tandis que le serveur API, le terminal et llmster ouvrent la voie à des intégrations plus structurées.
Son intérêt repose aussi sur le choix : il n’impose pas un modèle unique et permet d’adapter la taille, le format et les réglages d’exécution à la machine disponible. Le traitement local des documents et des conversations constitue un avantage pour les utilisateurs qui souhaitent maîtriser où se déroule l’inférence.
Cette autonomie ne supprime cependant ni les besoins matériels ni les limites des modèles. Mémoire vive, mémoire vidéo, quantification, longueur de contexte, qualité des réponses et licences des modèles doivent être évaluées avant de retenir une configuration. Une API compatible ne garantit pas non plus que tous les modèles gèrent correctement les outils, les images ou les sorties structurées.
Enfin, LM Studio Desktop doit rester distingué des produits voisins de son éditeur : Bionic est une application séparée, avec des fonctions d’agent et des services cloud optionnels ; Locally est l’application mobile qui peut accéder à des modèles via LM Link. Pour découvrir l’IA locale, tester un modèle sur ses documents ou créer un point d’accès API sur une machine maîtrisée, LM Studio constitue un environnement cohérent et évolutif.
Points d’attention
- LM Studio Desktop est gratuit pour un usage personnel et professionnel interne, mais son code est propriétaire. Les moteurs open source qu’il utilise ne changent pas la licence de l’application.
- Les licences des modèles sont indépendantes. La possibilité de télécharger un modèle ne garantit pas l’autorisation de l’utiliser commercialement ou de redistribuer ses poids.
- Le matériel détermine les modèles utilisables. LM Studio recommande notamment 16 Go de RAM ; sous Windows x64, AVX2 est nécessaire et une carte graphique disposant d’au moins 4 Go de VRAM est recommandée. Les besoins réels varient selon le modèle.
- La compatibilité système doit être vérifiée. Sur Mac, l’application requiert une puce Apple Silicon et macOS 14 au minimum ; les Mac Intel ne sont pas pris en charge. Sous Linux, la documentation officielle indique des réserves concernant certaines distributions et versions.
- Le RAG n’est pas une garantie d’exhaustivité. Pour les documents longs, certains passages peuvent ne pas être retrouvés et les réponses doivent être confrontées aux sources.
- Le serveur API ne doit pas être exposé sans précaution. Restreindre l’écoute à
localhostlorsque c’est possible et activer l’authentification pour les accès réseau ou les intégrations sensibles. - MCP et LM Link étendent le périmètre de confiance. Un outil externe peut accéder à des ressources autorisées ; LM Link requiert une connexion pour établir une liaison distante.
- Bionic et Locally sont des applications distinctes. Les abonnements cloud de Bionic et les fonctions mobiles de Locally ne doivent pas être attribués à LM Studio Desktop.
- L’usage local peut être hors connexion après téléchargement, mais la recherche de modèles, les mises à jour et tout service externe activé nécessitent leur propre examen des échanges de données.