Presentación
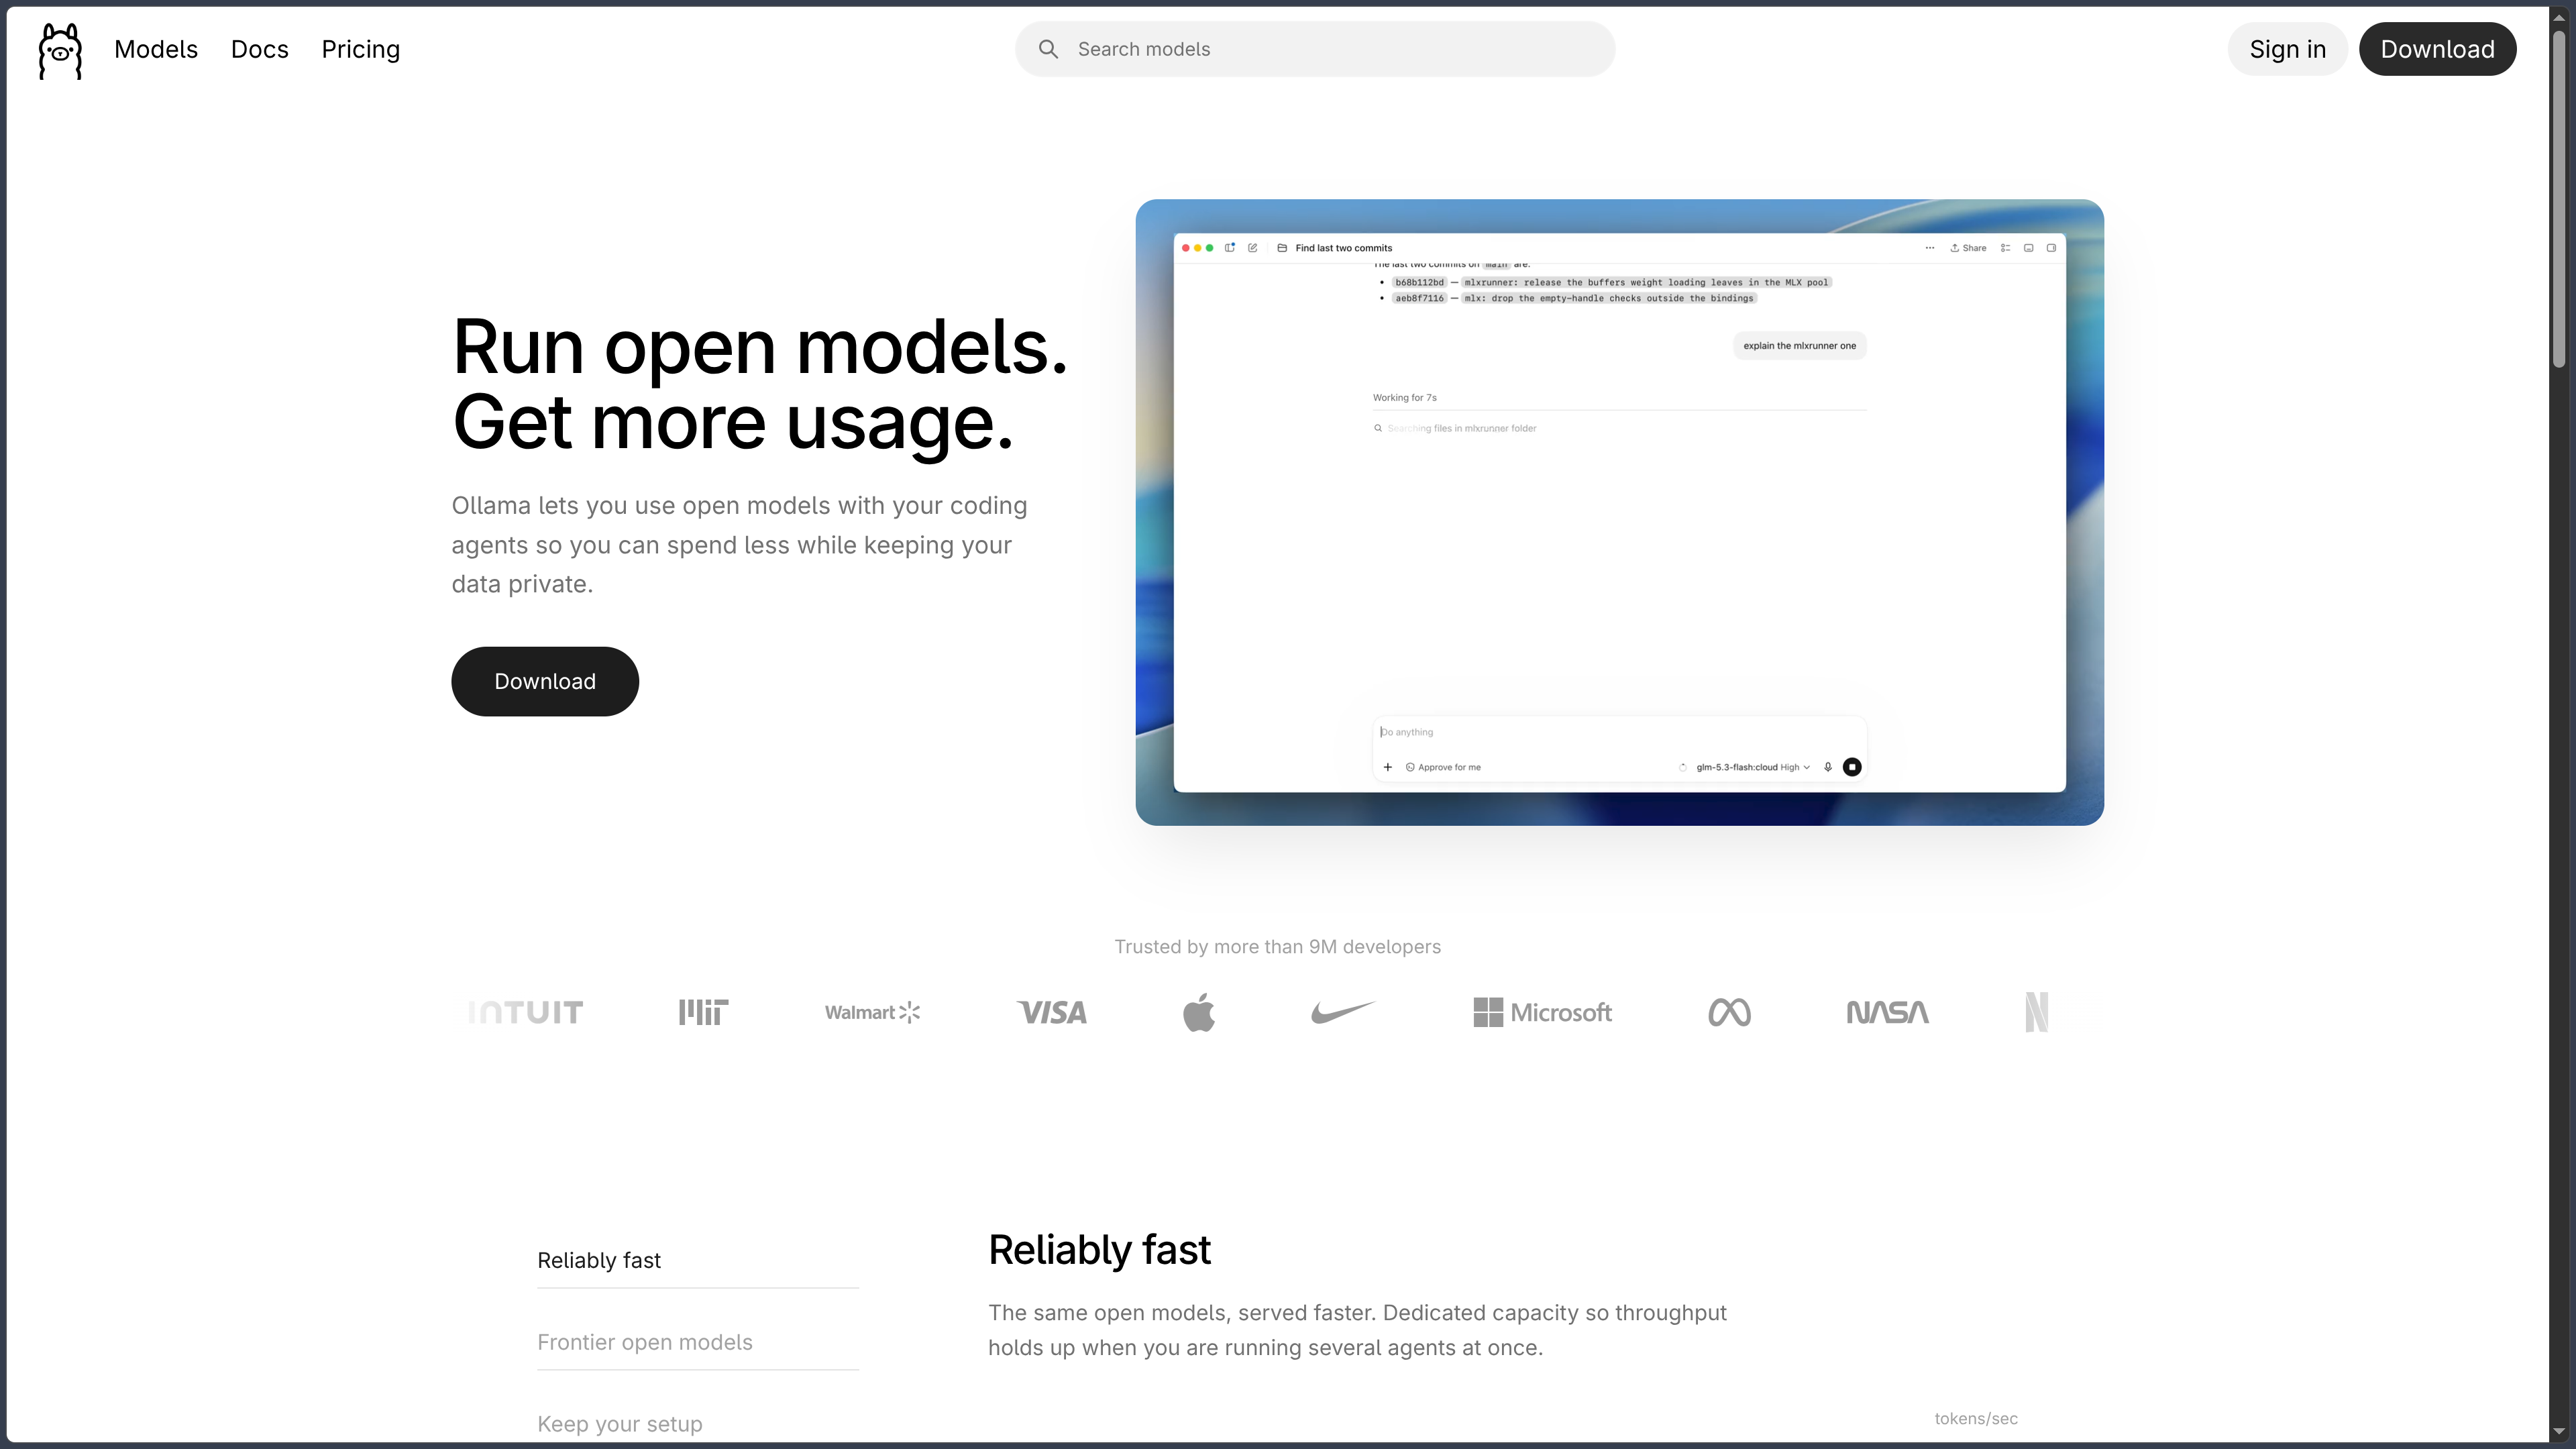
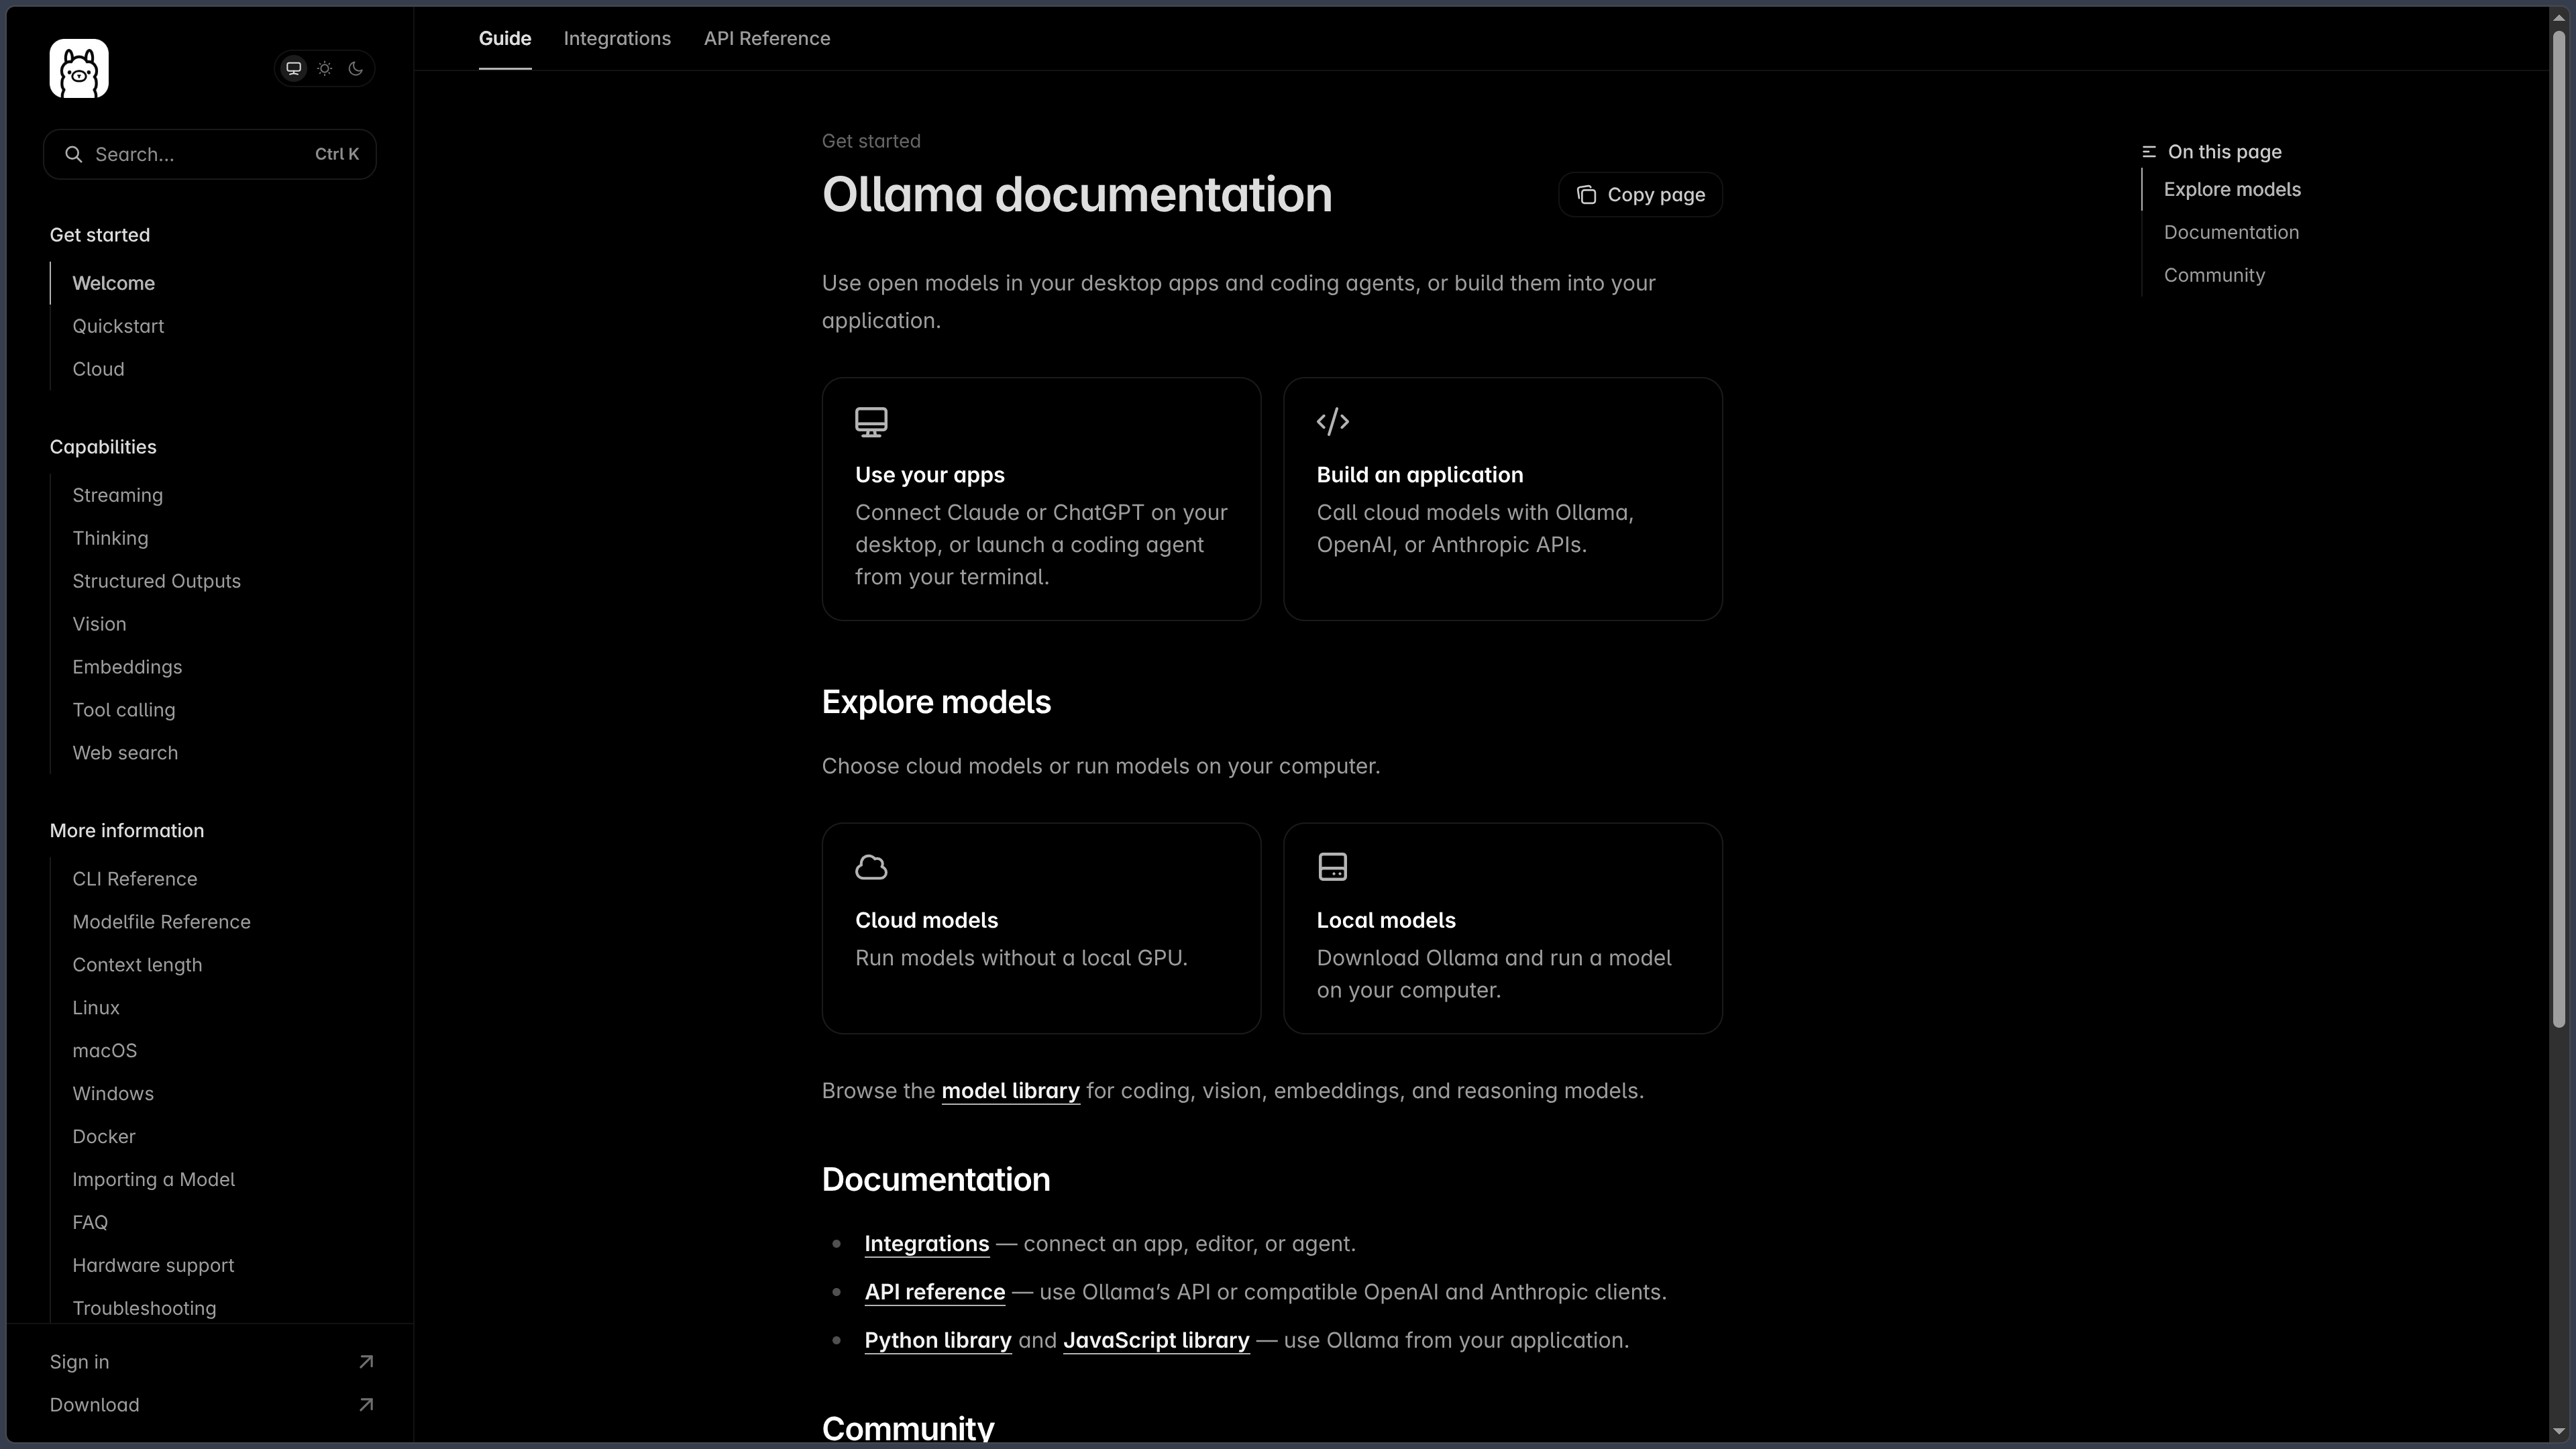
Ollama es un entorno open source para utilizar modelos de inteligencia artificial, desarrollado por Ollama Inc. Su función histórica consiste en simplificar la descarga y ejecución de modelos directamente en un ordenador: el usuario elige un modelo compatible, lo obtiene de un catálogo y puede iniciar una conversación o ponerlo a disposición de otras aplicaciones sin tener que desplegar por su cuenta toda una infraestructura de inferencia.
El software funciona en Windows, macOS y Linux. Está dirigido tanto a quienes desean probar modelos abiertos como a desarrolladores que buscan un motor de IA local y equipos que quieren integrar estos modelos en sus herramientas. Una aplicación de escritorio con chat e importación de archivos complementa ahora los comandos de terminal y el servidor API que dieron a conocer Ollama.
Sin embargo, su alcance se ha ampliado: Ollama distingue actualmente entre modelos locales y modelos alojados en su nube. Los primeros se ejecutan en el hardware del usuario y siguen siendo gratuitos por parte de Ollama. Los segundos utilizan máquinas remotas, especialmente para acceder a modelos demasiado grandes para un ordenador personal, con créditos y facturación según el uso. Elegir Ollama no significa, por tanto, que cada solicitud permanezca automáticamente en el dispositivo: depende del modelo y del modo de ejecución seleccionados.
La herramienta admite varias familias de modelos destinados especialmente a la conversación, el razonamiento, la programación, la visión y las representaciones vectoriales (embeddings). Proporciona una interfaz común para explorar estos usos, pero la calidad, las capacidades y la licencia varían según el modelo, que sigue siendo un componente distinto del propio software Ollama.
A 19 de septiembre de 2026, la versión estable publicada en GitHub es Ollama 0.34.2; la versión 0.34.3 también aparece como versión preliminar. El proyecto evoluciona rápidamente, especialmente en los motores de inferencia, la compatibilidad con hardware y las integraciones con asistentes de desarrollo.
Funcionalidades
Descargar, gestionar y ejecutar modelos
El catálogo de Ollama centraliza modelos listos para descargarse y utilizarse. Un comando como ollama run gemma4 permite obtener un modelo compatible si todavía no está instalado y después iniciar una conversación. Otros comandos sirven para mostrar los modelos disponibles, descargar una variante, consultar sus características o eliminar los archivos que ya no son necesarios.
Cada ficha del catálogo puede presentar varias variantes: tamaño, cuantización, capacidades y, en ocasiones, longitud del contexto. Estos elementos influyen directamente en la memoria necesaria, la velocidad de generación y las tareas que se pueden realizar. Un modelo pequeño cuantizado será más accesible en un ordenador corriente, mientras que un modelo de gran tamaño puede exigir mucha RAM o memoria de vídeo.
Descargar un modelo no equivale a entrenarlo. Ollama ejecuta principalmente modelos cuyos pesos ya existen. Permite ajustar su comportamiento e importar ciertos formatos, pero un entrenamiento completo o una adaptación especializada puede requerir otras herramientas. Los pesos descargados también ocupan espacio en disco, a veces varias decenas de gigabytes según el modelo elegido.
Una aplicación de escritorio y una interfaz de terminal
La aplicación Ollama para Windows y macOS permite descargar modelos y conversar con ellos mediante una interfaz gráfica. Admite especialmente arrastrar y soltar archivos de texto y PDF, así como imágenes cuando el modelo seleccionado tiene las capacidades necesarias. Para documentos voluminosos, aumentar la ventana de contexto puede mejorar la cantidad de texto que se tiene en cuenta, a costa de un mayor consumo de memoria.
El terminal conserva toda su importancia, especialmente en Linux y en máquinas utilizadas como servidores. Permite iniciar un modelo, automatizar su instalación o ejecutar Ollama en un entorno de desarrollo. La interfaz gráfica facilita el descubrimiento; la CLI y la API ofrecen un mayor control sobre los flujos de trabajo técnicos.
No debe confundirse la aplicación oficial con todas las interfaces de terceros compatibles con Ollama. Proyectos como Open WebUI ofrecen su propia experiencia de chat y sus propias funciones, pero no forman parte de la aplicación Ollama en sí.
Una API local para aplicaciones y scripts
Ollama expone una API REST que generalmente funciona en http://localhost:11434. Permite que una aplicación envíe mensajes a un modelo, reciba una respuesta, genere embeddings o gestione los modelos instalados. Las bibliotecas oficiales de Python y JavaScript facilitan la integración sin tener que reconstruir cada solicitud HTTP.
Ollama también ofrece compatibilidad con una parte de la API de OpenAI. En ocasiones, una aplicación que utiliza un cliente compatible puede redirigirse al servidor Ollama sustituyendo la dirección de su API y el modelo. Sin embargo, esta compatibilidad no reproduce íntegramente todas las funciones de OpenAI: hay que comprobar los endpoints y las opciones de los que depende el proyecto.
La API local resulta especialmente útil para conectar un modelo con un editor, un asistente de programación, un servicio interno o una aplicación desarrollada a medida. No crea, sin embargo, por sí sola una interfaz de usuario completa, un sistema público de autenticación ni una infraestructura de producción segura.
Integraciones con asistentes de desarrollo
El comando ollama launch simplifica la configuración y el inicio de varias herramientas de programación, especialmente Claude Code, Codex y OpenCode. Permite utilizar modelos locales o alojados sin tener que modificar sistemáticamente a mano todas las variables de entorno y direcciones de API.
Ollama también ofrece una integración con Claude Desktop como proveedor externo. Así, se puede sustituir el modelo utilizado conservando parte del software y de los hábitos de trabajo existentes. No obstante, la compatibilidad efectiva depende de la herramienta, del modelo y de las funciones solicitadas, especialmente las llamadas a herramientas y la longitud del contexto.
Esta distinción es importante: Ollama proporciona acceso y ejecución de modelos; un agente de código gestiona el proyecto, los archivos y las acciones. Conectar un modelo a un agente no le proporciona automáticamente el mismo rendimiento ni las mismas capacidades que un servicio propietario. El éxito de las modificaciones de código siempre debe comprobarse mediante pruebas y revisión humana.
Modelos personalizados, parámetros y contexto
Un Modelfile permite definir una configuración reutilizable a partir de un modelo existente: instrucciones del sistema, parámetros de generación, modelo base o plantilla de conversación. Esta personalización puede servir para preparar un asistente con un papel específico y respuestas más coherentes con un uso determinado.
El tamaño de la ventana de contexto también puede configurarse dentro de los límites del modelo y del hardware. Una ventana más larga permite procesar más texto en una solicitud, pero suele aumentar las necesidades de memoria y el coste de procesamiento. Los agentes de programación exigentes se benefician especialmente de un contexto adaptado al tamaño de los archivos y de los intercambios.
Ollama también admite funciones como las salidas estructuradas y las llamadas a herramientas con modelos compatibles. Aun así, una llamada a herramienta debe ser interpretada y ejecutada por la aplicación que orquesta el modelo: Ollama no convierte cada modelo en un agente autónomo con solo activar una opción.
Embeddings e integración en un sistema RAG
Ollama puede ejecutar modelos especializados en embeddings, que convierten texto en vectores numéricos. Estas representaciones sirven para buscar fragmentos cercanos por su significado, en lugar de depender únicamente de la presencia de palabras idénticas.
Esta capacidad constituye un componente útil para crear un sistema de RAG (Retrieval-Augmented Generation): una aplicación indexa documentos, encuentra los fragmentos pertinentes y después los proporciona al modelo generativo para construir una respuesta mejor fundamentada en las fuentes disponibles.
Sin embargo, hay que distinguir esta función de un gestor documental listo para usar. Ollama produce los embeddings y ejecuta los modelos, pero no proporciona automáticamente toda la cadena RAG: la extracción de archivos, la fragmentación, la base de datos vectorial, la búsqueda, las citas y el control del acceso a los documentos deben estar a cargo de la aplicación o de un framework complementario.
Rendimiento y hardware
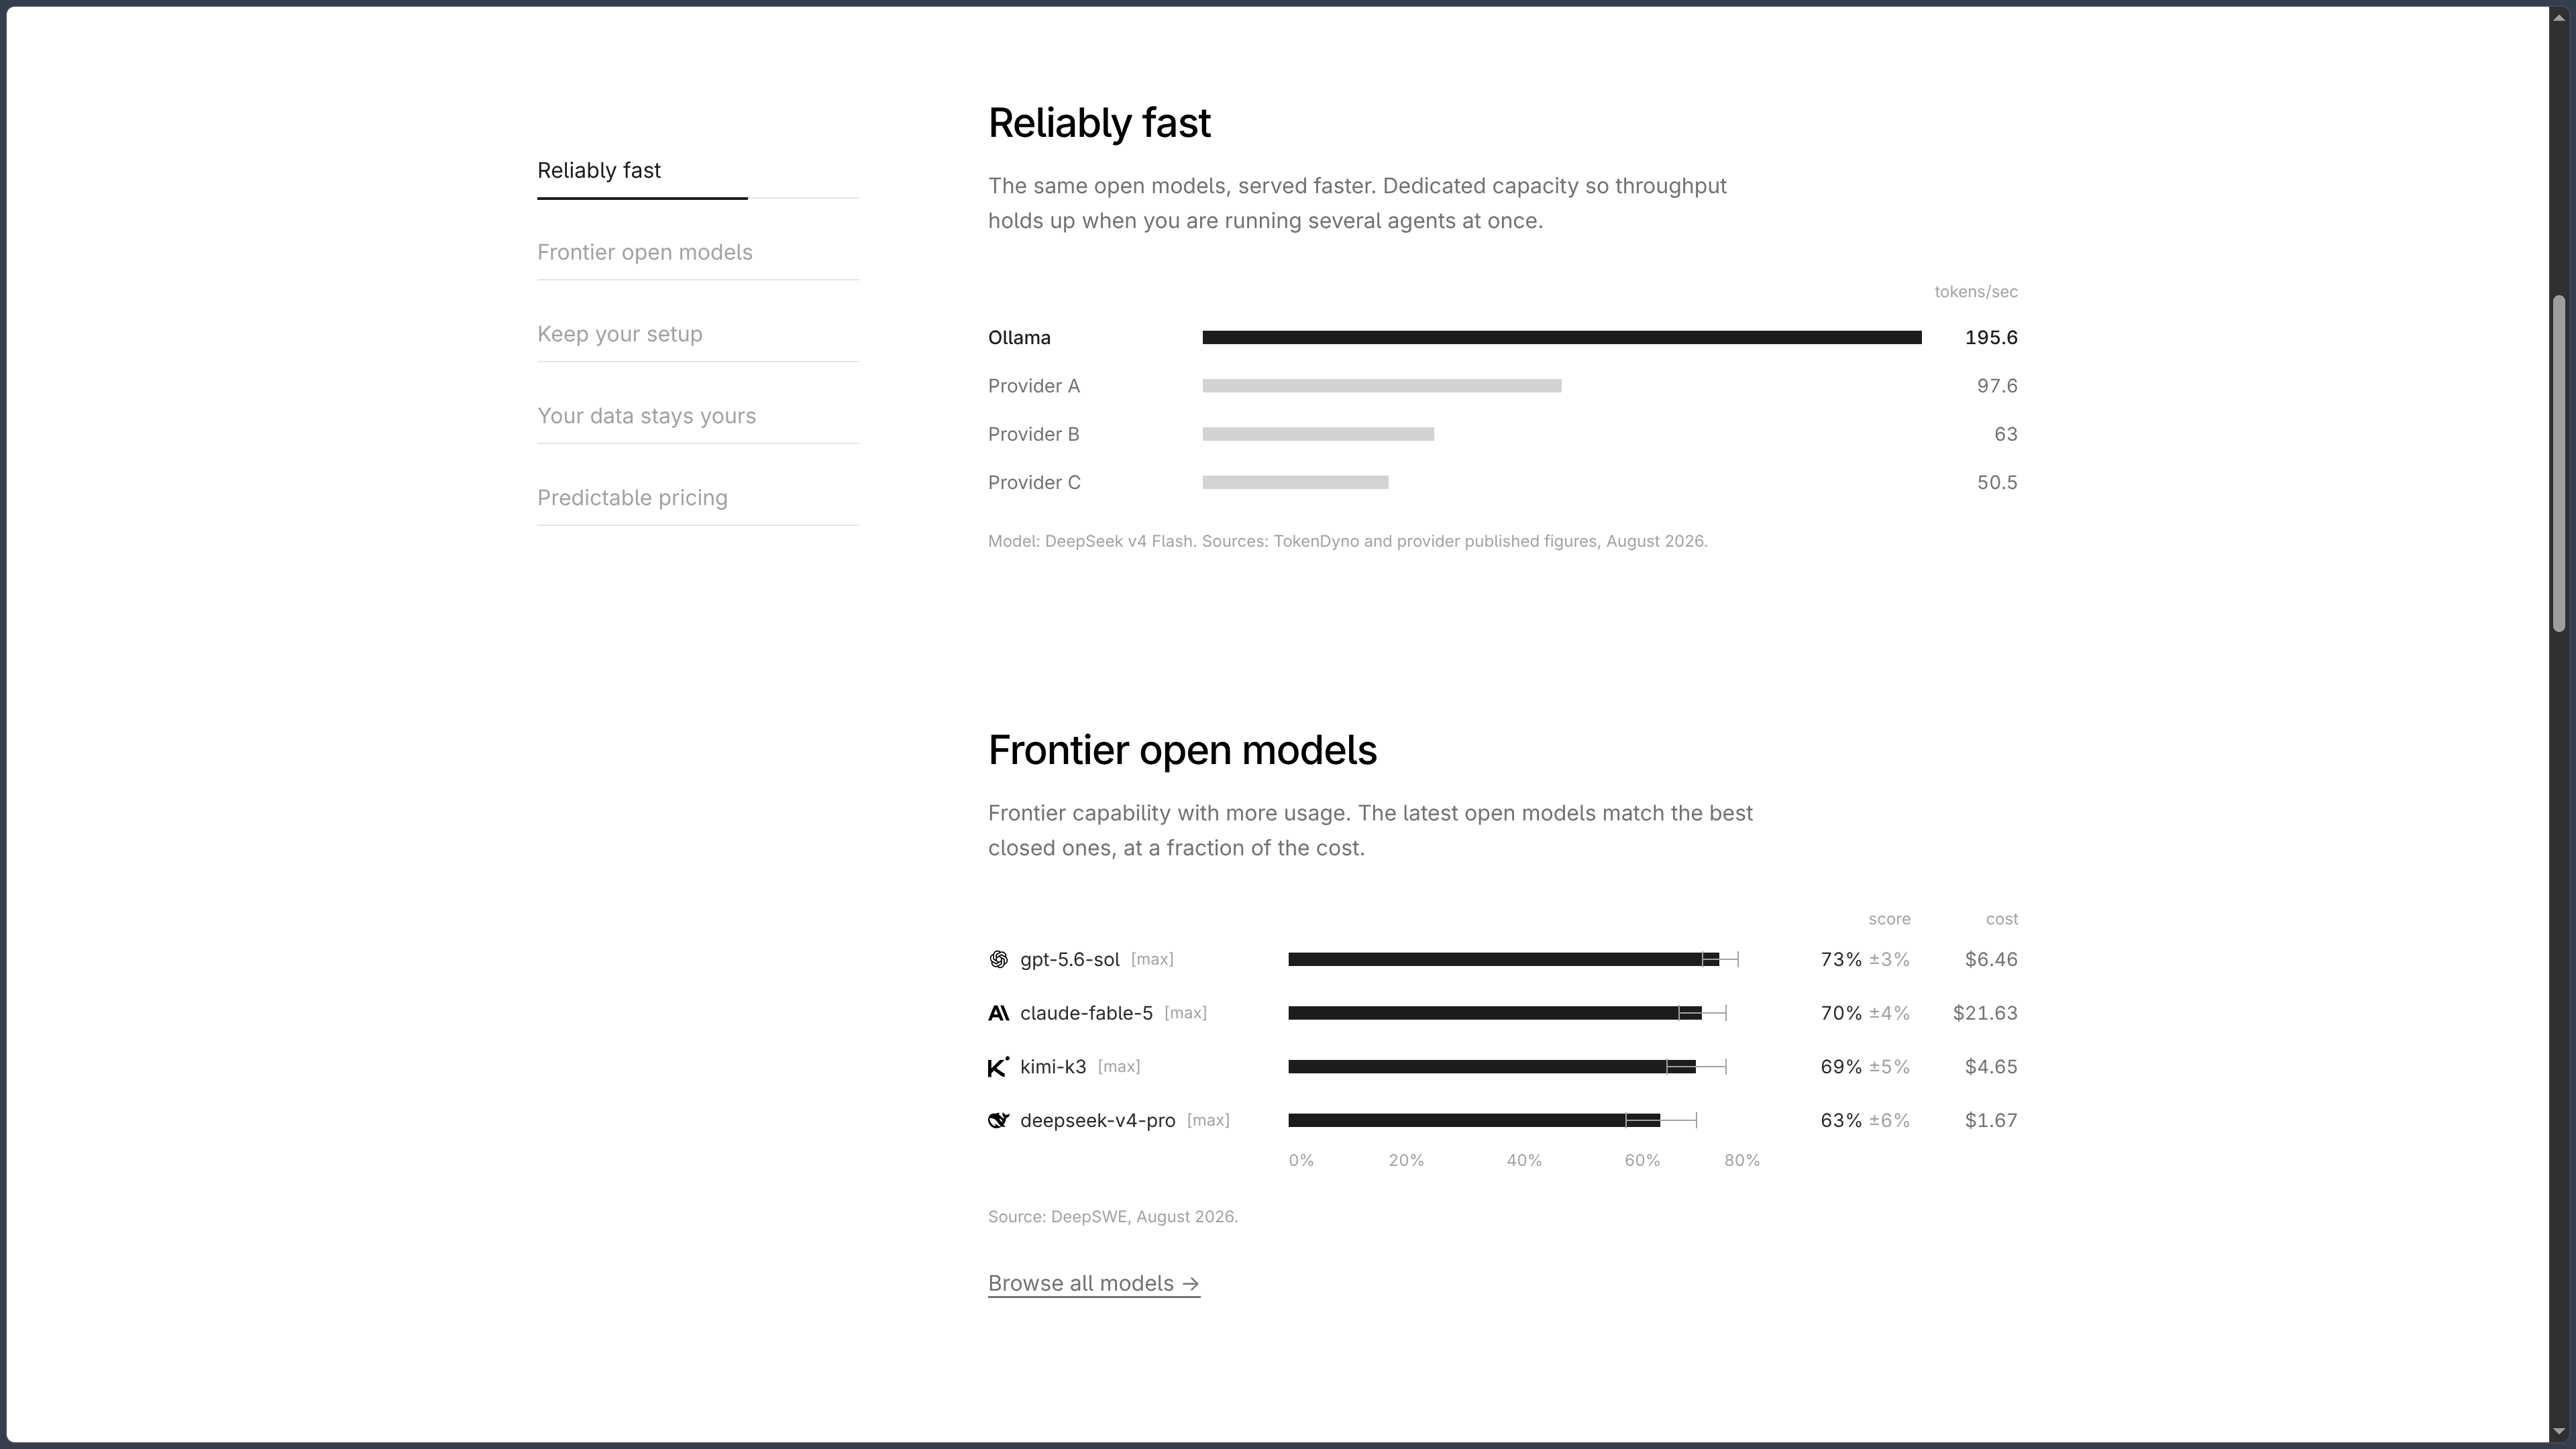
La velocidad depende del modelo, de su cuantización, de la longitud del contexto y del hardware disponible. Ollama puede aprovechar los procesadores y distintas soluciones de aceleración GPU, con una compatibilidad que varía según las tarjetas gráficas, los controladores y el sistema operativo.
En los Mac con chip de Apple, el motor MLX mejora el aprovechamiento de la memoria unificada y de las capacidades de aceleración del equipo. Ollama también utiliza llama.cpp para ampliar la compatibilidad de los modelos, especialmente con el formato GGUF. La compatibilidad con Vulkan contribuye a extender la aceleración a más configuraciones de hardware.
Un modelo que no cabe por completo en la memoria de vídeo puede funcionar más lentamente al utilizar más memoria del sistema o procesador. Para elegir de forma realista, es preferible comparar la huella de memoria de una variante, su velocidad en el propio equipo y sus resultados en las tareas previstas, en lugar de fijarse únicamente en el número de parámetros anunciado.
Modelos en la nube y privacidad: dos modos distintos
Los modelos locales se ejecutan en el ordenador o servidor del usuario. Una vez descargados los archivos necesarios, la inferencia puede realizarse sin enviar los prompts y respuestas a los servidores de Ollama. Esto no impide que una aplicación de terceros, una función externa o una configuración de red particular transmita otros datos: el alcance debe comprobarse en cada flujo de trabajo.
En cambio, los modelos en la nube procesan las solicitudes en una infraestructura remota. Ollama anuncia una política de zero data retention para el contenido de las solicitudes en la nube: según su política de privacidad, los prompts y las respuestas se procesan temporalmente, sin conservarse más allá del tiempo necesario para la solicitud ni utilizarse para entrenar modelos. No obstante, se siguen recopilando datos de cuenta y metadatos de uso limitados.
La documentación de precios indica que el alojamiento se encuentra principalmente en Estados Unidos, con capacidad también en Europa y Singapur. Por tanto, la nube no debe presentarse como ejecución local, incluso cuando el usuario utiliza la misma aplicación o el mismo comando.
Precios: ejecución local gratuita, nube según el uso
Desde el cambio anunciado el 31 de agosto de 2026, la nube de Ollama utiliza precios por número de tokens, con créditos mensuales incluidos en determinadas suscripciones. Los precios dependen del modelo y pueden diferenciar entre tokens de entrada, de salida y procedentes de un contexto almacenado en caché.
| Plan | Funcionamiento anunciado a 19 de septiembre de 2026 |
|---|---|
| Free | Ejecución local gratuita; pequeño crédito mensual en la nube para modelos iniciales, con posibilidad de comprar créditos adicionales. |
| Pro — 20 $/mes | Incluye 60 $ de créditos mensuales en la nube; también se anuncia un plan anual a 200 $. |
| Max — 100 $/mes | 300 $ de créditos mensuales y capacidades ampliadas para usos más intensivos. |
| Team — 500 $/mes | 1.000 $ de créditos compartidos, administración centralizada y número de usuarios no limitado por puesto. |
| Enterprise | Oferta bajo presupuesto para organizaciones con necesidades particulares. |
Los créditos incluidos se renuevan cada mes sin trasladar los importes no utilizados al siguiente. El uso adicional puede facturarse según la tarifa del modelo una vez agotado el crédito disponible. La ejecución en el propio hardware sigue siendo gratuita e ilimitada desde el punto de vista de la facturación de Ollama, al margen del coste del ordenador y de su electricidad.
Casos de uso
Instalar un asistente de IA completamente local
Ollama permite elegir un modelo adaptado al ordenador, descargarlo y utilizarlo en la aplicación oficial o en una interfaz compatible. Este funcionamiento resulta adecuado para probar modelos, redactar, reformular o mantener conversaciones que se desea procesar sin un servicio de inferencia remoto.
La elección del modelo sigue siendo determinante: una variante pequeña puede funcionar con fluidez, pero tener menos capacidad para resolver problemas complejos; una variante más grande puede superar la memoria disponible. Para utilizarlo sin conexión, primero deben instalarse todos los modelos y componentes necesarios.
Añadir IA a una aplicación o herramienta interna
Un desarrollador puede conectar su aplicación a la API local para obtener respuestas, analizar texto o generar datos estructurados. Las bibliotecas Python y JavaScript facilitan la creación de un prototipo y la integración en un programa existente.
La compatibilidad parcial con la API de OpenAI también puede reducir el trabajo de adaptación de un proyecto ya diseñado alrededor de clientes compatibles. Sin embargo, antes de desplegarlo hay que probar las funciones realmente admitidas, la seguridad del acceso por red y el rendimiento con varias solicitudes.
Construir un sistema de búsqueda en documentos propios
Al combinar un modelo de embeddings ejecutado mediante Ollama con una herramienta de indexación y una base de datos vectorial, es posible recuperar fragmentos dentro de una colección de documentos. Después, un modelo generativo puede aprovechar estos extractos para responder a una pregunta.
Esta arquitectura resulta adecuada especialmente para documentación técnica, una base de conocimientos o notas personales. La calidad del RAG depende tanto de la extracción y la búsqueda como del propio modelo: hay que conservar las referencias a los documentos y verificar las respuestas antes de considerarlas establecidas.
Experimentar con agentes de programación
Ollama puede alimentar un asistente de desarrollo compatible con un modelo local y después pasar a un modelo en la nube más grande cuando las necesidades superan los recursos del equipo. ollama launch simplifica esta conexión con determinados agentes populares.
Así, el desarrollador puede comparar varios modelos dentro de un flujo de trabajo similar y decidir cuándo utilizar su propio hardware o una infraestructura alojada. Sin embargo, el modelo no ejecuta por sí solo las operaciones sobre archivos: los permisos, las herramientas y las pruebas dependen del agente y de su configuración.
Comparar local y nube antes de elegir una infraestructura
Un equipo puede crear un prototipo gratuitamente en un ordenador, medir los requisitos de memoria y la calidad de las respuestas y después estudiar el interés de un modelo alojado para tareas más exigentes o solicitudes concurrentes.
La facturación de la nube por token presenta un perfil de coste distinto al de la inferencia local, que utiliza hardware ya disponible. El dimensionamiento adecuado depende del volumen de solicitudes, de la privacidad requerida y de la velocidad buscada; el servicio en la nube no constituye automáticamente un sustituto transparente de un servidor local.
Conclusión
Ollama ha evolucionado desde una utilidad para iniciar modelos locales hasta convertirse en un entorno común para acceder a modelos abiertos en el propio ordenador o en la nube. Su interés reside en una puesta en marcha relativamente directa, su catálogo, su API y la posibilidad de reutilizar los mismos modelos en varias aplicaciones y herramientas de desarrollo.
Para uso local, su modelo es especialmente claro: el software es open source bajo licencia MIT y la ejecución en el propio hardware no genera gastos de suscripción a Ollama. Sin embargo, el usuario sigue siendo responsable de elegir el modelo, comprobar su licencia, disponer de los recursos de hardware necesarios y asegurar las aplicaciones que se conectan a él.
La oferta en la nube amplía el catálogo a modelos que no caben en un ordenador personal. También introduce una facturación independiente, basada en tokens y créditos, y modifica el alcance del tratamiento de datos. Por tanto, es esencial indicar claramente si un modelo se ejecuta en local o sobre una infraestructura remota, en lugar de presentar Ollama en su conjunto como un servicio sistemáticamente sin conexión.
Por último, Ollama sigue siendo ante todo un motor de ejecución e integración. Su API, sus embeddings y sus conexiones con agentes de código son componentes potentes, pero un verdadero sistema documental, un producto multiusuario o un agente autónomo requieren una orquestación adicional. Para descubrir modelos abiertos, crear prototipos de aplicaciones de IA o establecer una infraestructura local evolutiva, esta base ofrece un punto de partida sólido.
Puntos de atención
- El software y los modelos no tienen la misma licencia. Ollama se distribuye bajo MIT, pero los pesos descargados y los servicios en la nube conservan sus propias condiciones, especialmente importantes para un uso comercial.
- Hay que distinguir entre local y nube. La inferencia local no transmite los prompts a Ollama; los modelos alojados procesan las solicitudes a distancia, conforme a la política de privacidad del servicio.
- El acceso local es gratuito, pero el hardware no. El tamaño del modelo, el contexto, la RAM, la VRAM, el espacio en disco y el consumo eléctrico influyen directamente en el coste y la comodidad de uso.
- La nube se factura por token. Los créditos mensuales no se acumulan y pueden generarse gastos adicionales si el uso continúa más allá del importe incluido.
- La compatibilidad con OpenAI es parcial. Facilita determinadas integraciones, pero no garantiza la compatibilidad con todas las API, funciones u opciones.
- Ollama no es un sistema RAG completo listo para usar. Proporciona embeddings e inferencia; la ingesta, indexación, búsqueda, citas y permisos de acceso deben organizarse por separado.
- La compatibilidad con imágenes y herramientas depende del modelo. Un modelo de texto no se vuelve multimodal ni compatible con agentes simplemente por funcionar en Ollama.
- Un servidor expuesto a una red debe protegerse. La API local no debe hacerse accesible públicamente sin autenticación, control de acceso y protecciones adecuadas.
- Las respuestas deben verificarse. Los modelos pueden inventar información o generar código incorrecto; los usos sensibles exigen pruebas, fuentes y validación humana.