Présentation
Ollama est un environnement open source pour utiliser des modèles d’intelligence artificielle, développé par Ollama Inc. Sa fonction historique consiste à simplifier le téléchargement et l’exécution de modèles directement sur un ordinateur : l’utilisateur choisit un modèle compatible, le récupère depuis un catalogue et peut lancer une conversation ou l’exposer à d’autres applications sans déployer lui-même toute une infrastructure d’inférence.
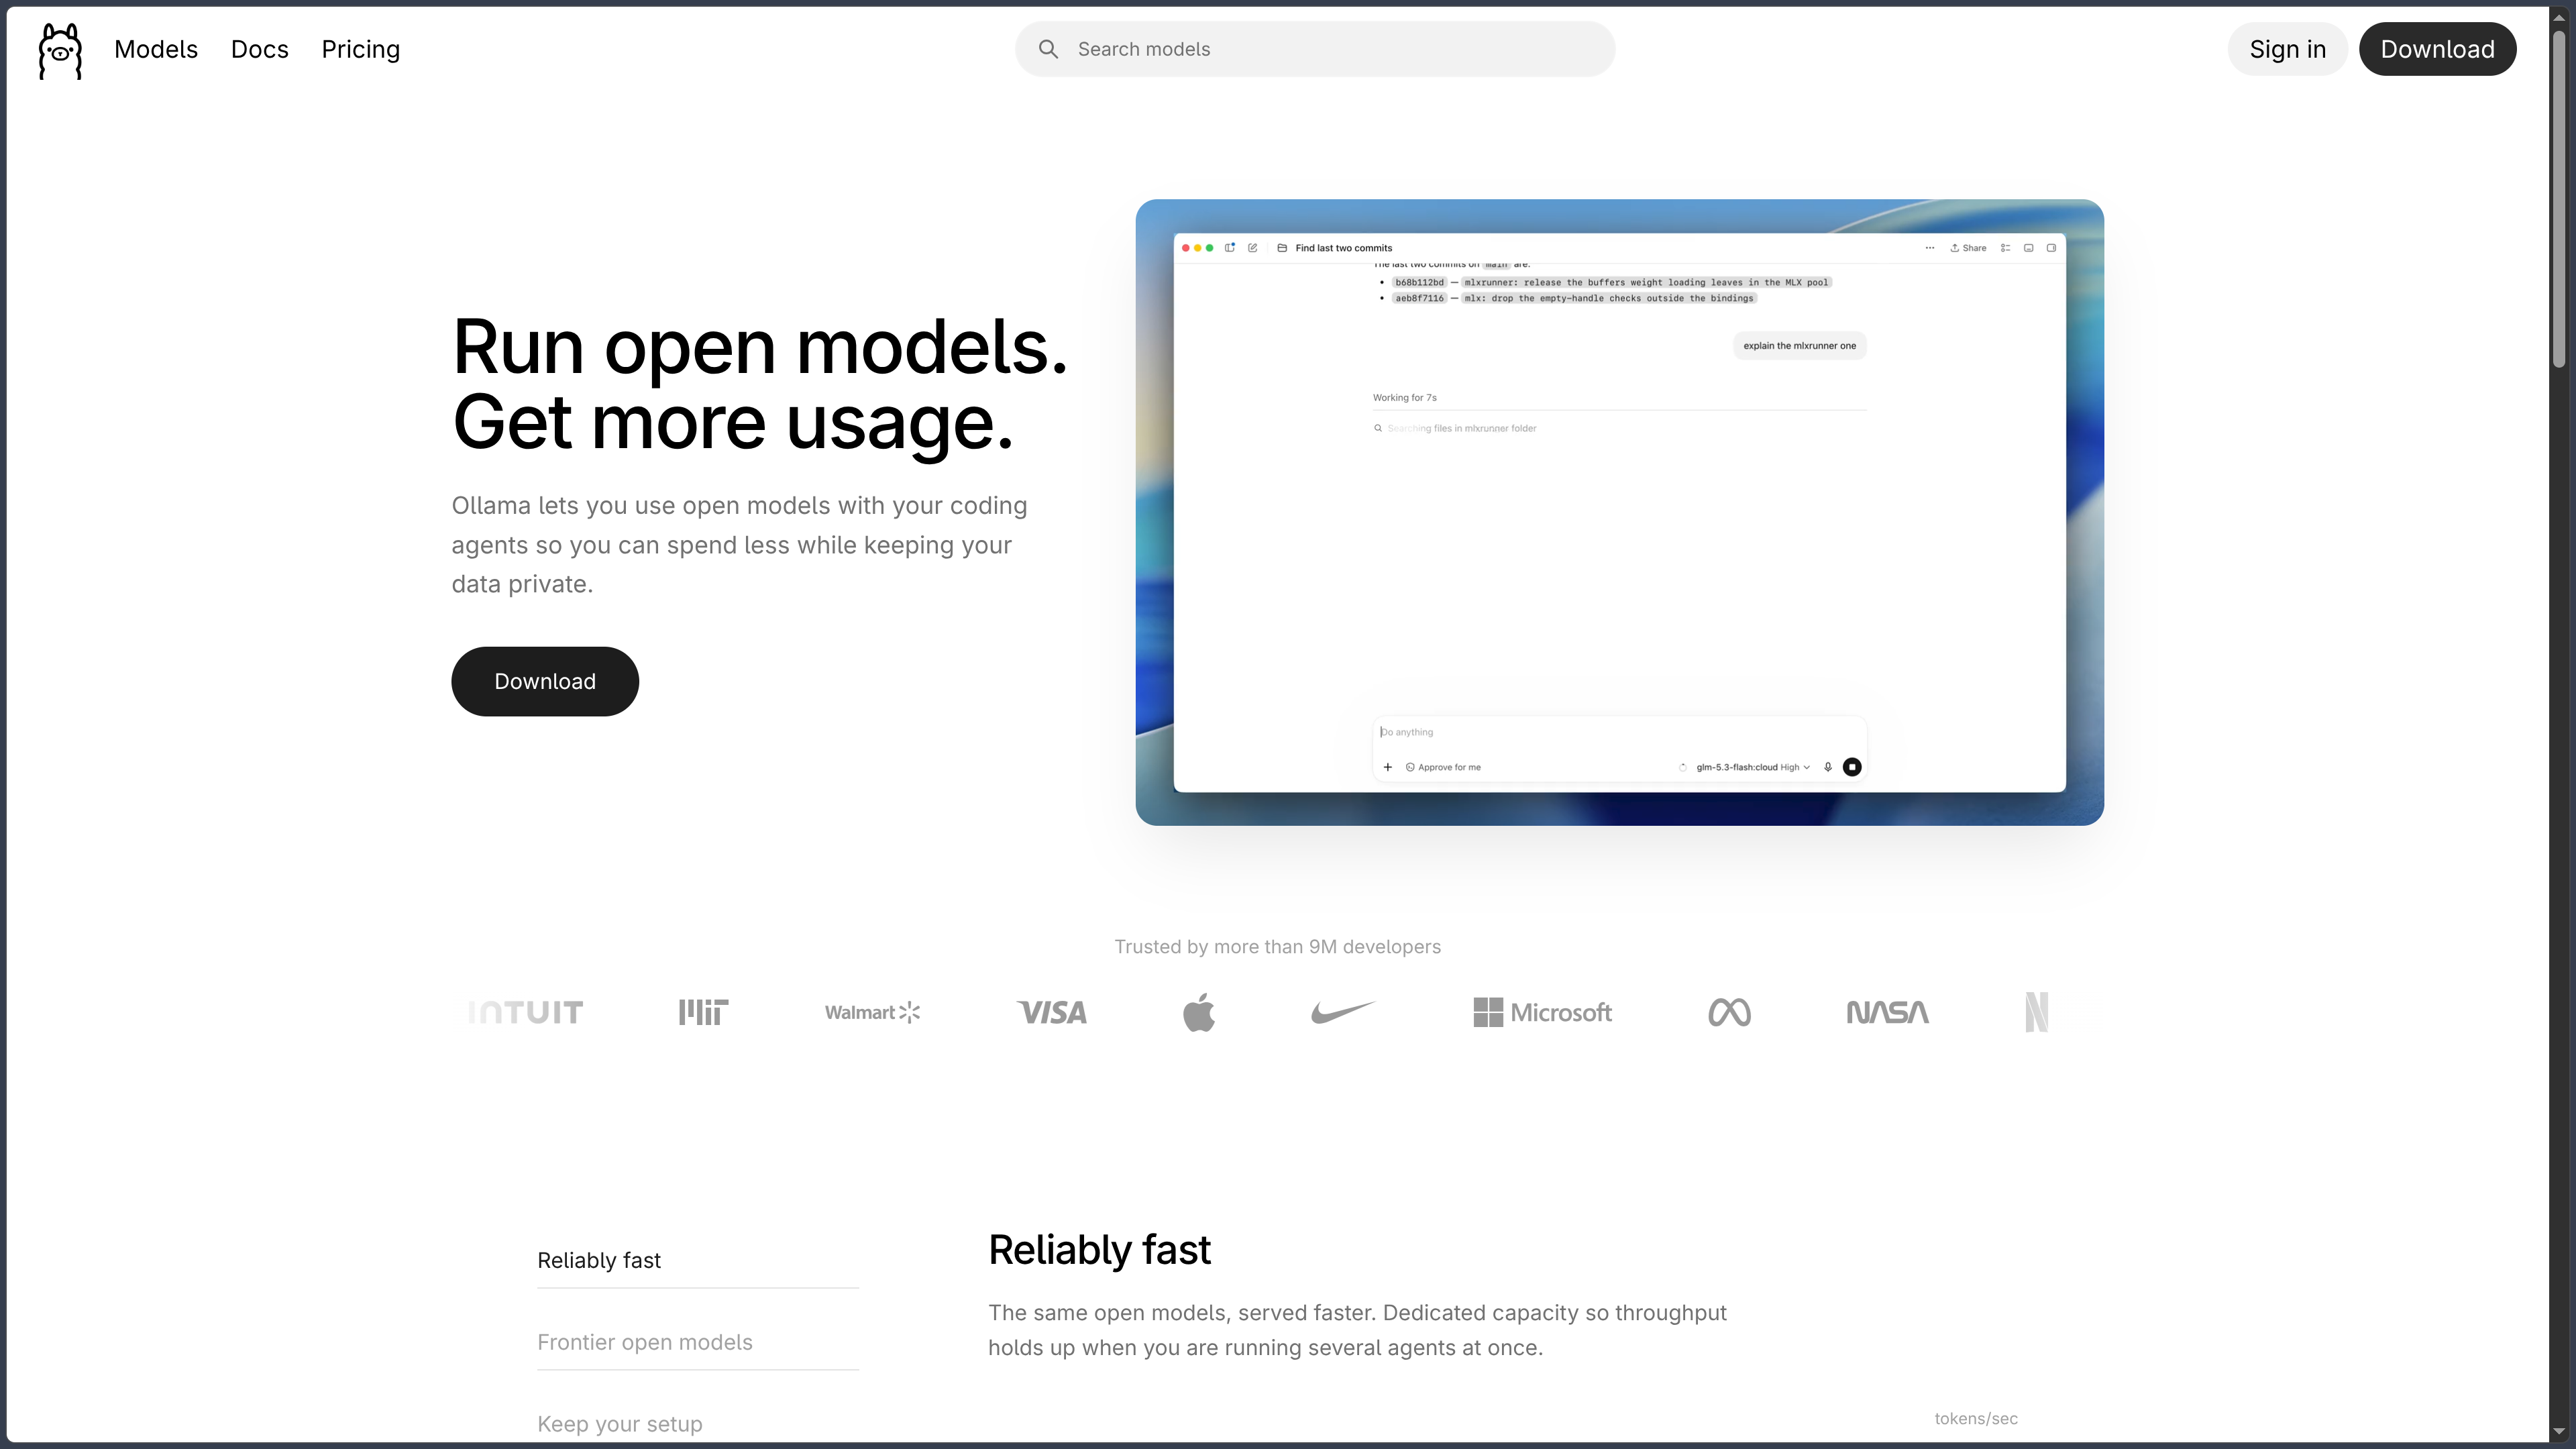
Le logiciel fonctionne sur Windows, macOS et Linux. Il s’adresse à la fois aux personnes qui veulent essayer des modèles ouverts, aux développeurs qui cherchent un moteur d’IA local et aux équipes qui souhaitent intégrer ces modèles à leurs outils. Une application de bureau avec chat et importation de fichiers accompagne désormais les commandes terminal et le serveur API qui ont fait connaître Ollama.
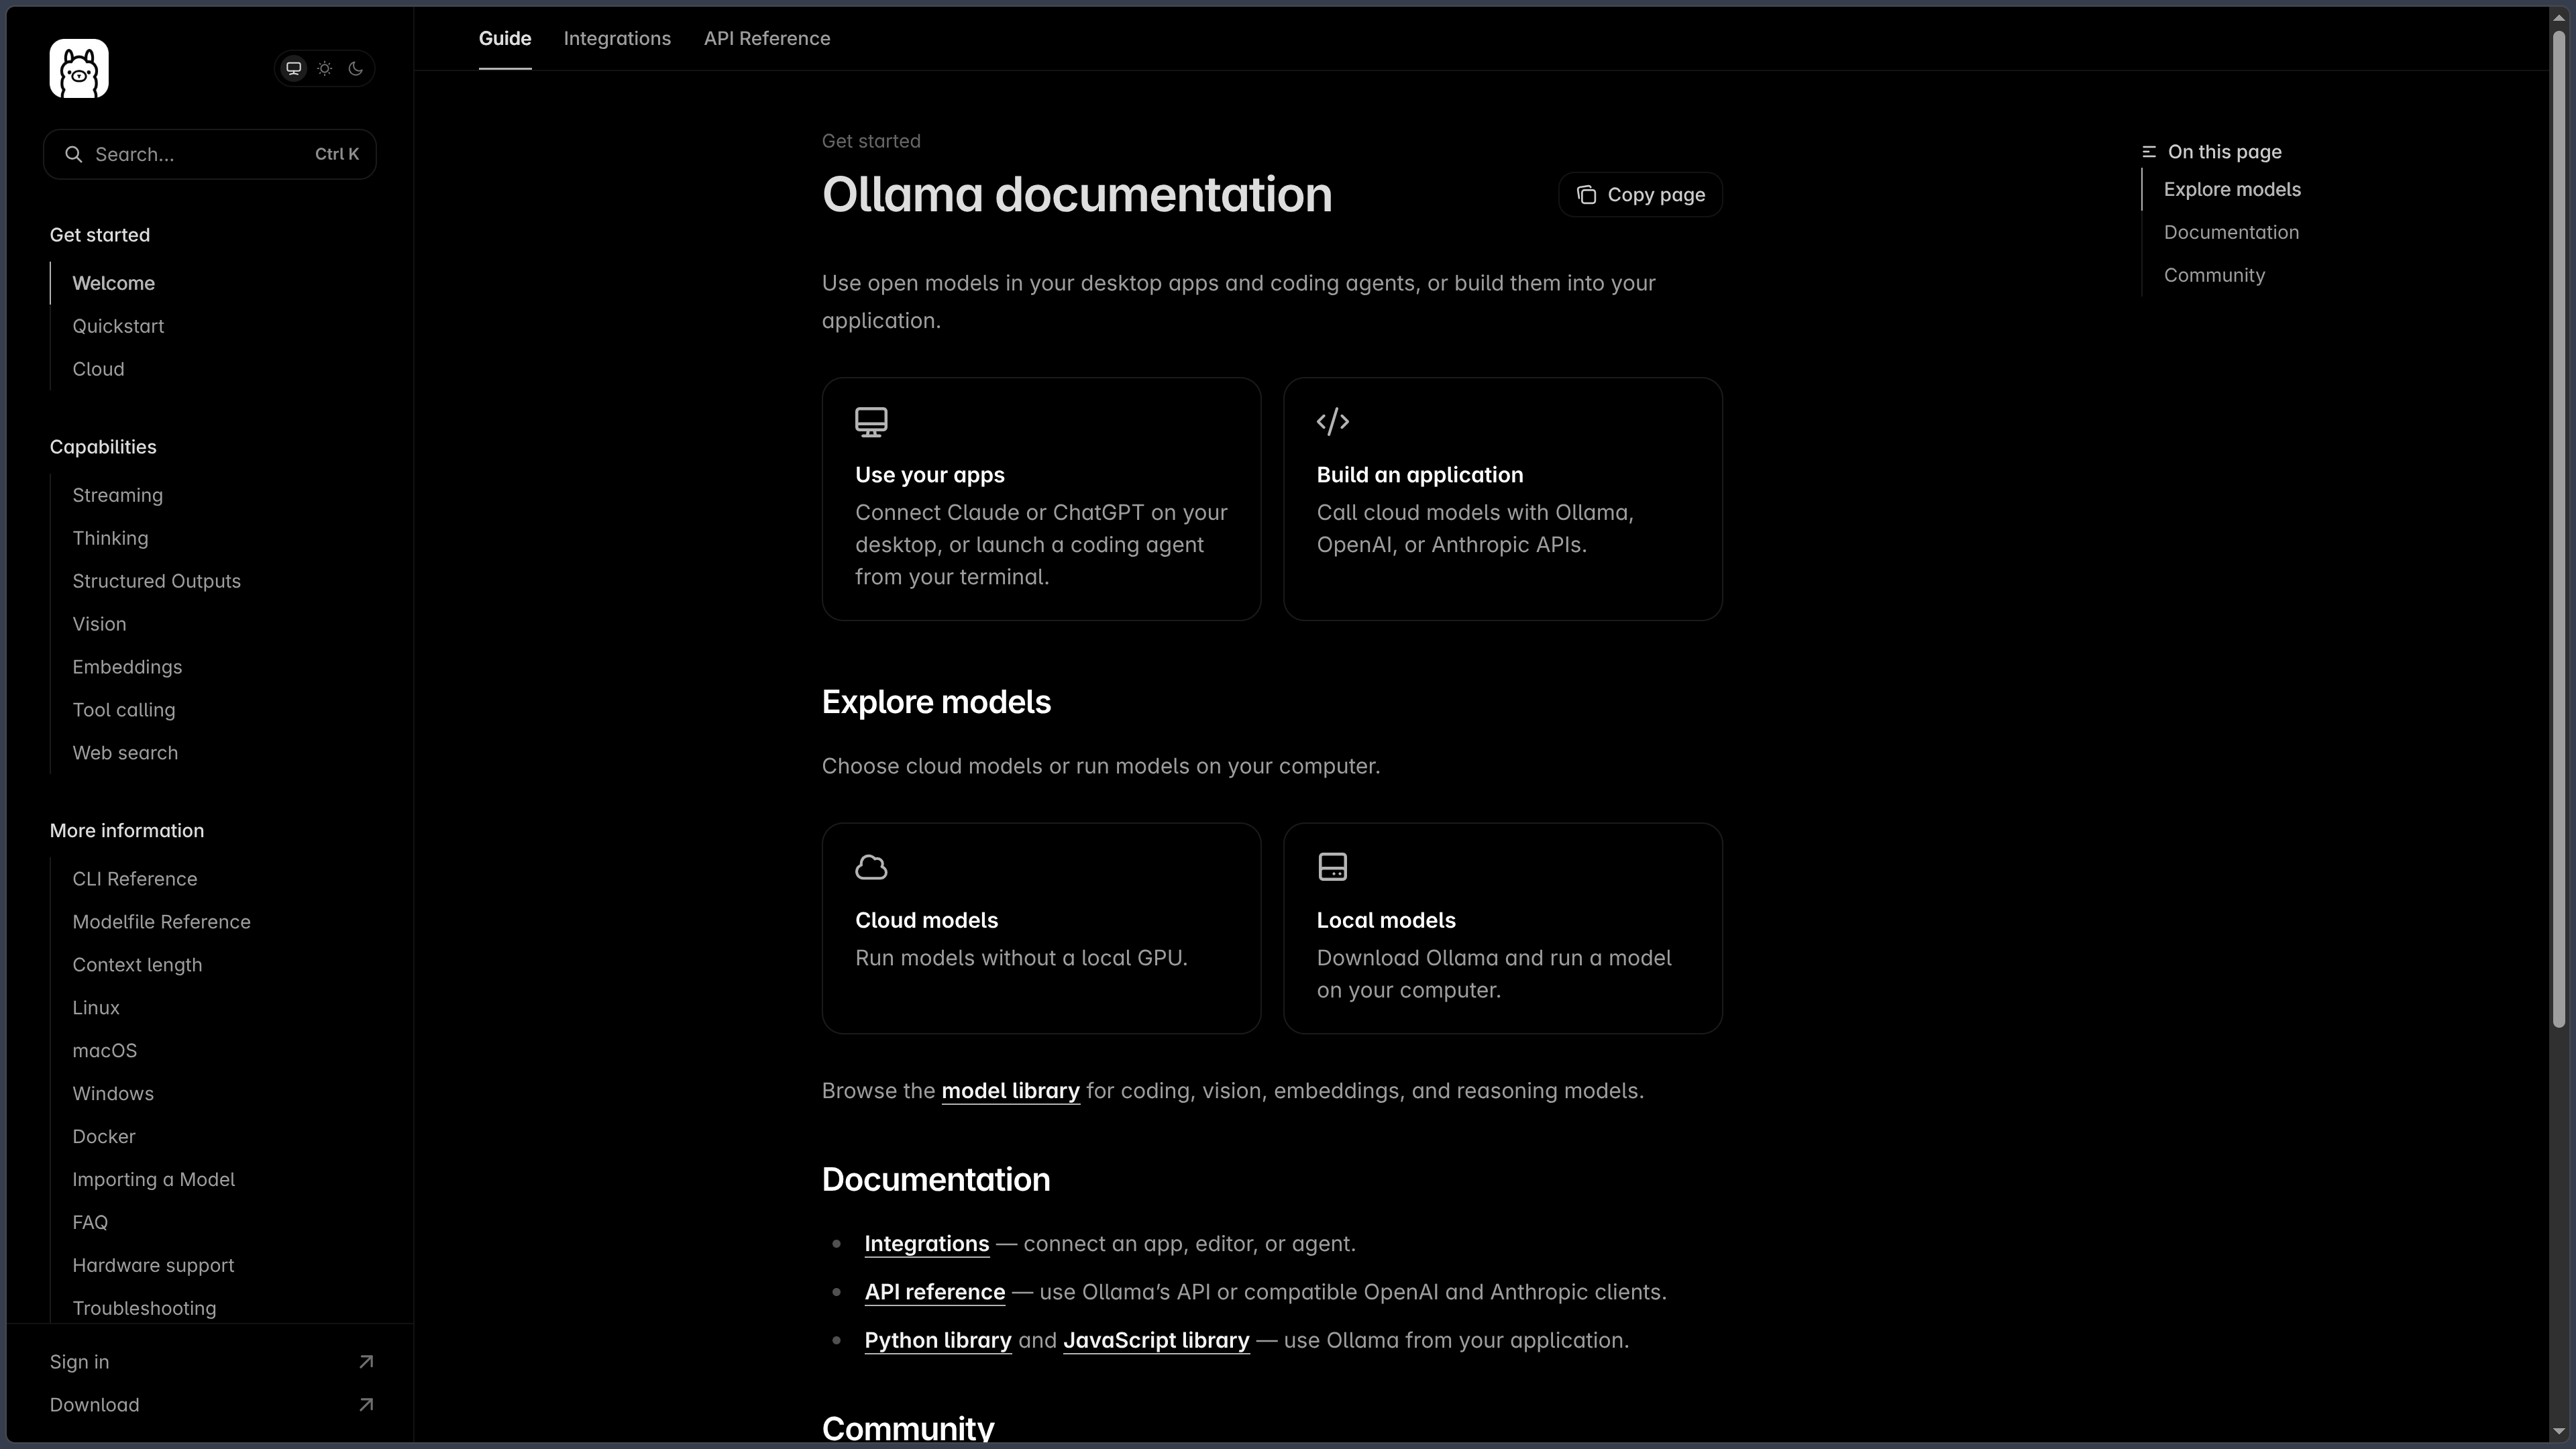
Son périmètre s’est toutefois élargi : Ollama distingue aujourd’hui les modèles locaux et les modèles hébergés dans son cloud. Les premiers s’exécutent sur le matériel de l’utilisateur et restent gratuits du côté d’Ollama. Les seconds utilisent des machines distantes, notamment pour accéder à des modèles trop volumineux pour un ordinateur personnel, avec des crédits et une facturation à l’usage. Choisir Ollama ne signifie donc pas automatiquement que chaque requête reste sur son appareil : cela dépend du modèle et du mode d’exécution sélectionnés.
L’outil prend en charge plusieurs familles de modèles destinées notamment à la conversation, au raisonnement, à la programmation, à la vision et aux représentations vectorielles (embeddings). Il fournit une interface commune pour explorer ces usages, mais la qualité, les capacités et la licence varient selon le modèle, qui reste un composant distinct du logiciel Ollama lui-même.
Au 19 septembre 2026, la branche stable publiée sur GitHub est Ollama 0.34.2 ; une version 0.34.3 apparaît également comme préversion. Le projet évolue rapidement, notamment sur les moteurs d’inférence, la compatibilité matérielle et les intégrations avec les assistants de développement.
Fonctionnalités
Télécharger, gérer et exécuter des modèles
Le catalogue Ollama centralise des modèles prêts à être téléchargés et utilisés. Une commande comme ollama run gemma4 permet de récupérer un modèle compatible s’il n’est pas encore installé, puis de démarrer une conversation. D’autres commandes servent à afficher les modèles présents, récupérer une variante, consulter ses caractéristiques ou supprimer les fichiers devenus inutiles.
Chaque fiche du catalogue peut présenter plusieurs variantes : taille, quantification, capacités et parfois longueur de contexte. Ces éléments ont un effet direct sur la mémoire nécessaire, la vitesse de génération et les tâches réalisables. Un petit modèle quantifié sera plus accessible sur un ordinateur courant, tandis qu’un modèle de grande taille peut exiger beaucoup de RAM ou de mémoire vidéo.
Télécharger un modèle n’équivaut pas à l’entraîner. Ollama exécute principalement des modèles dont les poids existent déjà. Il permet de régler leur comportement et d’importer certains formats, mais un entraînement complet ou une adaptation spécialisée peut nécessiter d’autres outils. Les poids téléchargés occupent aussi de l’espace disque, parfois plusieurs dizaines de gigaoctets selon le modèle choisi.
Une application de bureau et une interface en terminal
L’application Ollama sur Windows et macOS permet de télécharger des modèles et de discuter avec eux dans une interface graphique. Elle accepte notamment le glisser-déposer de fichiers texte et PDF, ainsi que des images lorsque le modèle sélectionné possède les capacités nécessaires. Pour les documents volumineux, l’augmentation de la fenêtre de contexte peut améliorer la quantité de texte prise en compte, au prix d’une consommation mémoire plus importante.
Le terminal conserve toute son importance, notamment sur Linux et les machines utilisées comme serveurs. Il permet de démarrer un modèle, automatiser son installation ou lancer Ollama dans un environnement de développement. L’interface graphique facilite la découverte ; le CLI et l’API donnent davantage de prise sur les workflows techniques.
Il ne faut pas confondre l’application officielle avec toutes les interfaces tierces compatibles Ollama. Des projets comme Open WebUI proposent leur propre expérience de chat et leurs propres fonctions, mais ne font pas partie de l’application Ollama elle-même.
Une API locale pour les logiciels et les scripts
Ollama expose une API REST qui fonctionne généralement sur http://localhost:11434. Elle permet à une application d’envoyer des messages à un modèle, de recevoir une réponse, de générer des embeddings ou de gérer les modèles installés. Des bibliothèques officielles Python et JavaScript facilitent l’intégration sans avoir à reconstruire chaque requête HTTP.
Ollama propose aussi une compatibilité avec une partie de l’API OpenAI. Un logiciel utilisant un client compatible peut parfois être redirigé vers le serveur Ollama en remplaçant son adresse d’API et son modèle. Cette compatibilité n’est toutefois pas une reproduction intégrale de toutes les fonctions d’OpenAI : il faut vérifier les points de terminaison et options dont dépend le projet.
L’API locale est particulièrement utile pour faire communiquer un modèle avec un éditeur, un assistant de programmation, un service interne ou une application développée sur mesure. Elle ne crée cependant pas, à elle seule, une interface utilisateur complète, un système d’authentification public ou une infrastructure de production sécurisée.
Intégrations avec les assistants de développement
La commande ollama launch simplifie la configuration et le lancement de plusieurs outils de programmation, notamment Claude Code, Codex et OpenCode. Elle permet d’utiliser des modèles locaux ou hébergés sans devoir systématiquement modifier à la main toutes les variables d’environnement et les adresses d’API.
Ollama propose également une intégration avec Claude Desktop en tant que fournisseur tiers. Le modèle employé peut ainsi être remplacé tout en conservant une partie du logiciel et des habitudes de travail déjà utilisés. La compatibilité effective dépend néanmoins de l’outil, du modèle et des fonctions sollicitées, notamment les appels d’outils et la longueur du contexte.
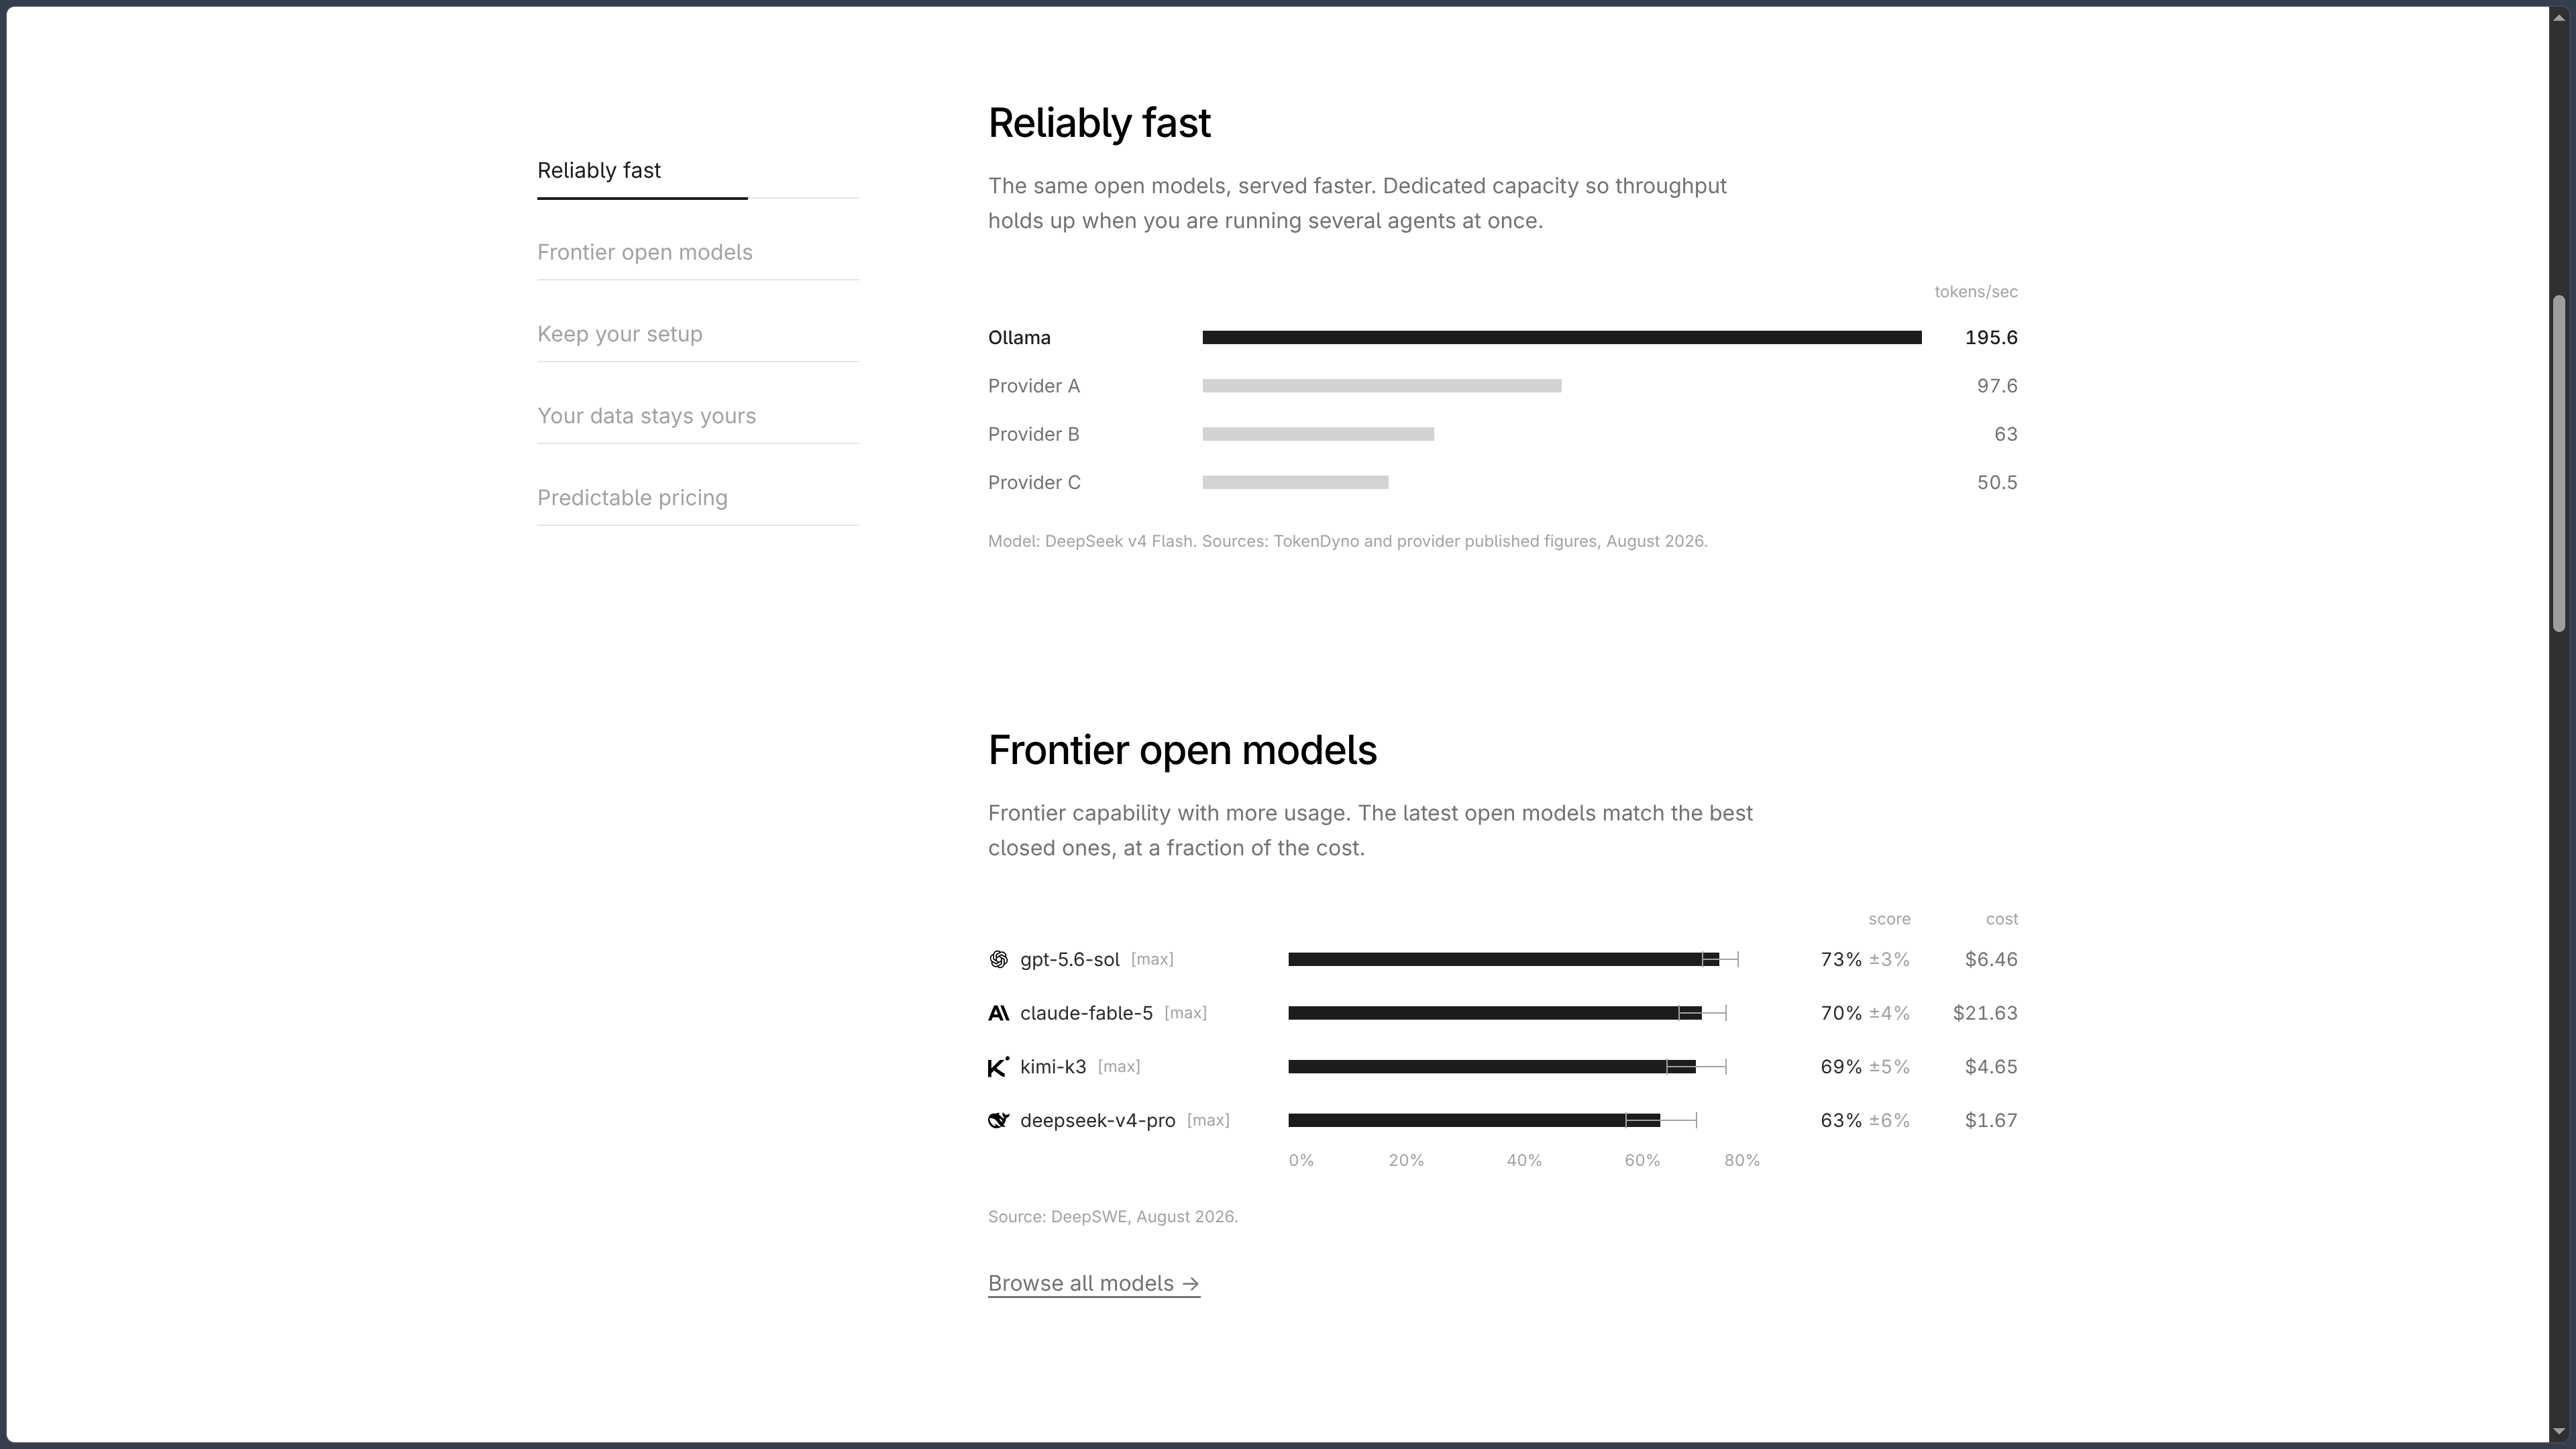
Cette distinction est importante : Ollama fournit l’accès et l’exécution des modèles ; un agent de code gère le projet, les fichiers et les actions. Brancher un modèle sur un agent ne lui donne pas automatiquement les mêmes performances ni les mêmes capacités qu’un service propriétaire. La réussite des modifications de code doit toujours être vérifiée par des tests et une revue humaine.
Modèles personnalisés, paramètres et contexte
Un Modelfile permet de définir une configuration réutilisable à partir d’un modèle existant : instructions système, paramètres de génération, modèle de base ou gabarit de conversation. Cette personnalisation peut servir à préparer un assistant avec un rôle précis et des réponses plus cohérentes avec un usage donné.
La taille de la fenêtre de contexte est également configurable dans les limites du modèle et du matériel. Une fenêtre plus longue permet de traiter davantage de texte dans une requête, mais augmente souvent les besoins en mémoire et le coût de traitement. Les agents de programmation exigeants bénéficient particulièrement d’un contexte adapté à la taille des fichiers et des échanges.
Ollama prend aussi en charge des fonctions comme les sorties structurées et les appels d’outils avec les modèles compatibles. Pour autant, un appel d’outil doit être interprété et exécuté par l’application qui orchestre le modèle : Ollama ne transforme pas chaque modèle en agent autonome par simple activation d’une option.
Embeddings et intégration dans un système RAG
Ollama peut exécuter des modèles spécialisés dans les embeddings, qui convertissent du texte en vecteurs numériques. Ces représentations servent à rechercher des passages proches par leur sens plutôt que par la seule présence de mots identiques.
Cette capacité constitue une brique utile pour créer un système de RAG (Retrieval-Augmented Generation) : une application indexe des documents, retrouve les passages pertinents puis les fournit au modèle de génération afin de construire une réponse mieux ancrée dans les sources disponibles.
Il faut cependant distinguer cette fonction d’un gestionnaire documentaire prêt à l’emploi. Ollama produit les embeddings et exécute les modèles, mais ne fournit pas automatiquement toute la chaîne RAG : extraction des fichiers, découpage, base vectorielle, recherche, citations et contrôle de l’accès aux documents doivent être assurés par l’application ou un framework complémentaire.
Performances et matériel
La vitesse dépend du modèle, de sa quantification, de la longueur du contexte et du matériel disponible. Ollama peut exploiter les processeurs et différentes solutions d’accélération GPU, avec une prise en charge qui varie selon les cartes graphiques, les pilotes et le système d’exploitation.
Sur les Mac à puce Apple, le moteur MLX améliore l’exploitation de la mémoire unifiée et des capacités d’accélération de la machine. Ollama utilise également llama.cpp pour élargir la compatibilité des modèles, notamment au format GGUF. Le support Vulkan contribue à étendre l’accélération à davantage de configurations matérielles.
Un modèle qui ne tient pas entièrement en mémoire vidéo peut fonctionner plus lentement en sollicitant davantage la mémoire système ou le processeur. Pour un choix réaliste, mieux vaut comparer l’empreinte mémoire d’une variante, sa vitesse sur sa propre machine et ses résultats sur les tâches envisagées plutôt que de retenir uniquement le nombre de paramètres annoncé.
Modèles cloud et confidentialité : deux modes distincts
Les modèles locaux s’exécutent sur l’ordinateur ou le serveur de l’utilisateur. Une fois les fichiers nécessaires téléchargés, l’inférence peut se faire sans envoyer les prompts et réponses vers les serveurs d’Ollama. Cela n’empêche pas une application tierce, une fonction externe ou une configuration réseau particulière de transmettre d’autres données : le périmètre doit être vérifié dans chaque workflow.
Les modèles cloud traitent en revanche les requêtes sur une infrastructure distante. Ollama annonce une politique de zero data retention pour les contenus des requêtes cloud : selon sa politique de confidentialité, prompts et réponses sont traités temporairement, sans être conservés au-delà du temps nécessaire à la requête ni utilisés pour entraîner des modèles. Des informations de compte et métadonnées d’usage limitées restent néanmoins collectées.
La documentation tarifaire indique que l’hébergement est principalement situé aux États-Unis, avec des capacités également en Europe et à Singapour. Le cloud ne doit donc pas être présenté comme une exécution locale, même lorsque l’utilisateur passe par la même application ou la même commande.
Tarifs : local gratuit, cloud à l’usage
Depuis le changement annoncé le 31 août 2026, le cloud Ollama utilise une tarification au nombre de jetons, avec des crédits mensuels intégrés à certains abonnements. Les prix dépendent du modèle et peuvent distinguer les jetons d’entrée, de sortie et ceux provenant d’un contexte mis en cache.
| Formule | Fonctionnement annoncé au 19 septembre 2026 |
|---|---|
| Free | Exécution locale gratuite ; petit crédit cloud mensuel pour des modèles de départ, avec possibilité d’acheter des crédits supplémentaires. |
| Pro — 20 $/mois | 60 $ de crédits cloud mensuels inclus ; formule annuelle également affichée à 200 $. |
| Max — 100 $/mois | 300 $ de crédits mensuels et capacités accrues pour des usages plus intensifs. |
| Team — 500 $/mois | 1 000 $ de crédits partagés, administration centralisée et nombre d’utilisateurs non plafonné par siège. |
| Enterprise | Offre sur devis pour les organisations ayant des besoins particuliers. |
Les crédits inclus sont renouvelés chaque mois sans report des montants non consommés. Une utilisation supplémentaire peut être facturée au tarif du modèle après épuisement du crédit disponible. L’exécution sur son propre matériel reste gratuite et illimitée du point de vue de la facturation Ollama, hors coûts de l’ordinateur et de son électricité.
Cas d’usage
Installer un assistant IA entièrement local
Ollama permet de choisir un modèle adapté à son ordinateur, de le télécharger et de l’utiliser dans l’application officielle ou dans une interface compatible. Ce fonctionnement convient aux essais de modèles, à la rédaction, à la reformulation ou à des échanges que l’on souhaite traiter sans service d’inférence distant.
Le choix du modèle reste déterminant : une petite variante peut être fluide, mais moins capable sur un problème complexe ; une variante plus importante peut dépasser la mémoire disponible. Pour une utilisation hors connexion, tous les modèles et composants nécessaires doivent d’abord être installés.
Ajouter une IA à une application ou à un outil interne
Un développeur peut connecter son application à l’API locale pour obtenir des réponses, analyser du texte ou générer des données structurées. Les bibliothèques Python et JavaScript facilitent la construction d’un prototype et l’intégration dans un logiciel existant.
La compatibilité partielle avec l’API OpenAI peut aussi réduire le travail d’adaptation d’un projet déjà conçu autour de clients compatibles. Avant un déploiement, il faut toutefois tester les fonctions réellement prises en charge, la sécurité de l’accès réseau et les performances avec plusieurs requêtes.
Construire une recherche dans ses documents
En associant un modèle d’embeddings exécuté par Ollama à un outil d’indexation et à une base vectorielle, il devient possible de retrouver des passages dans une collection de documents. Un modèle de génération peut ensuite exploiter ces extraits pour répondre à une question.
Cette architecture convient notamment à une documentation technique, une base de connaissances ou des notes personnelles. La qualité du RAG dépend autant de l’extraction et de la recherche que du modèle lui-même : il faut conserver les références aux documents et vérifier les réponses avant de les considérer comme établies.
Expérimenter avec des agents de programmation
Ollama peut alimenter un assistant de développement compatible avec un modèle local, puis passer à un modèle cloud plus volumineux lorsque les besoins dépassent les ressources de la machine. ollama launch simplifie cette mise en relation avec certains agents populaires.
Le développeur peut ainsi comparer plusieurs modèles dans un workflow similaire et décider quand utiliser son propre matériel ou une infrastructure hébergée. Le modèle n’exécute toutefois pas seul les opérations sur les fichiers : les permissions, outils et tests relèvent de l’agent et de sa configuration.
Comparer local et cloud avant de choisir une infrastructure
Une équipe peut prototyper gratuitement sur un ordinateur, mesurer les besoins en mémoire et la qualité des réponses, puis étudier l’intérêt d’un modèle hébergé pour les tâches plus lourdes ou les requêtes concurrentes.
La facturation cloud au jeton donne un autre profil de coût que l’inférence locale, qui mobilise du matériel déjà disponible. Le bon dimensionnement dépend du volume de demandes, de la confidentialité requise et de la vitesse recherchée ; le service cloud ne constitue pas automatiquement un remplacement transparent d’un serveur local.
Conclusion
Ollama a évolué d’un utilitaire de lancement de modèles locaux vers un environnement commun pour accéder à des modèles ouverts sur son ordinateur ou dans le cloud. Son intérêt tient à une prise en main relativement directe, à son catalogue, à l’API et à la possibilité de réutiliser les mêmes modèles dans plusieurs applications et outils de développement.
Pour un usage local, son modèle est particulièrement lisible : le logiciel est open source sous licence MIT et l’exécution sur son propre matériel n’entraîne pas de frais d’abonnement Ollama. L’utilisateur conserve cependant la responsabilité du choix du modèle, de sa licence, des ressources matérielles et de la sécurité des applications qui s’y connectent.
L’offre cloud étend le catalogue aux modèles qui ne tiennent pas sur un ordinateur personnel. Elle apporte aussi une facturation distincte, basée sur les jetons et les crédits, et modifie le périmètre de traitement des données. Il est donc essentiel d’indiquer clairement si un modèle tourne en local ou sur une infrastructure distante, plutôt que de présenter Ollama dans son ensemble comme un service systématiquement hors ligne.
Enfin, Ollama reste avant tout un moteur d’exécution et d’intégration. Son API, ses embeddings et ses connexions avec les agents de code sont des briques puissantes, mais un véritable système documentaire, un produit multi-utilisateur ou un agent autonome demande une orchestration supplémentaire. Pour découvrir les modèles ouverts, prototyper une application IA ou mettre en place une infrastructure locale évolutive, cette base fournit un point de départ solide.
Points d’attention
- Logiciel et modèles n’ont pas la même licence. Ollama est distribué sous MIT, mais les poids téléchargés et les services cloud conservent leurs propres conditions, particulièrement importantes pour un usage commercial.
- Local et cloud doivent être distingués. L’inférence locale ne transmet pas les prompts à Ollama ; les modèles hébergés traitent les requêtes à distance, selon la politique de confidentialité du service.
- L’accès local est gratuit, pas le matériel. Taille du modèle, contexte, RAM, VRAM, espace disque et consommation électrique influencent directement le coût et le confort d’utilisation.
- Le cloud est facturé au jeton. Les crédits mensuels ne sont pas reportés et des dépenses supplémentaires peuvent survenir si l’usage se poursuit au-delà du montant inclus.
- La compatibilité OpenAI est partielle. Elle facilite certaines intégrations, mais ne garantit pas la prise en charge de toutes les API, fonctionnalités ou options.
- Ollama n’est pas un RAG complet prêt à l’emploi. Embeddings et inférence sont fournis ; ingestion, indexation, recherche, citations et droits d’accès doivent être organisés séparément.
- La prise en charge des images et des outils dépend du modèle. Un modèle textuel ne devient pas multimodal ou compatible avec des agents simplement parce qu’il fonctionne dans Ollama.
- Un serveur exposé sur un réseau doit être sécurisé. L’API locale ne doit pas être rendue publiquement accessible sans authentification, contrôle des accès et protections adaptées.
- Les réponses restent à vérifier. Les modèles peuvent inventer des informations ou produire du code incorrect ; les usages sensibles exigent des tests, des sources et une validation humaine.