Présentation
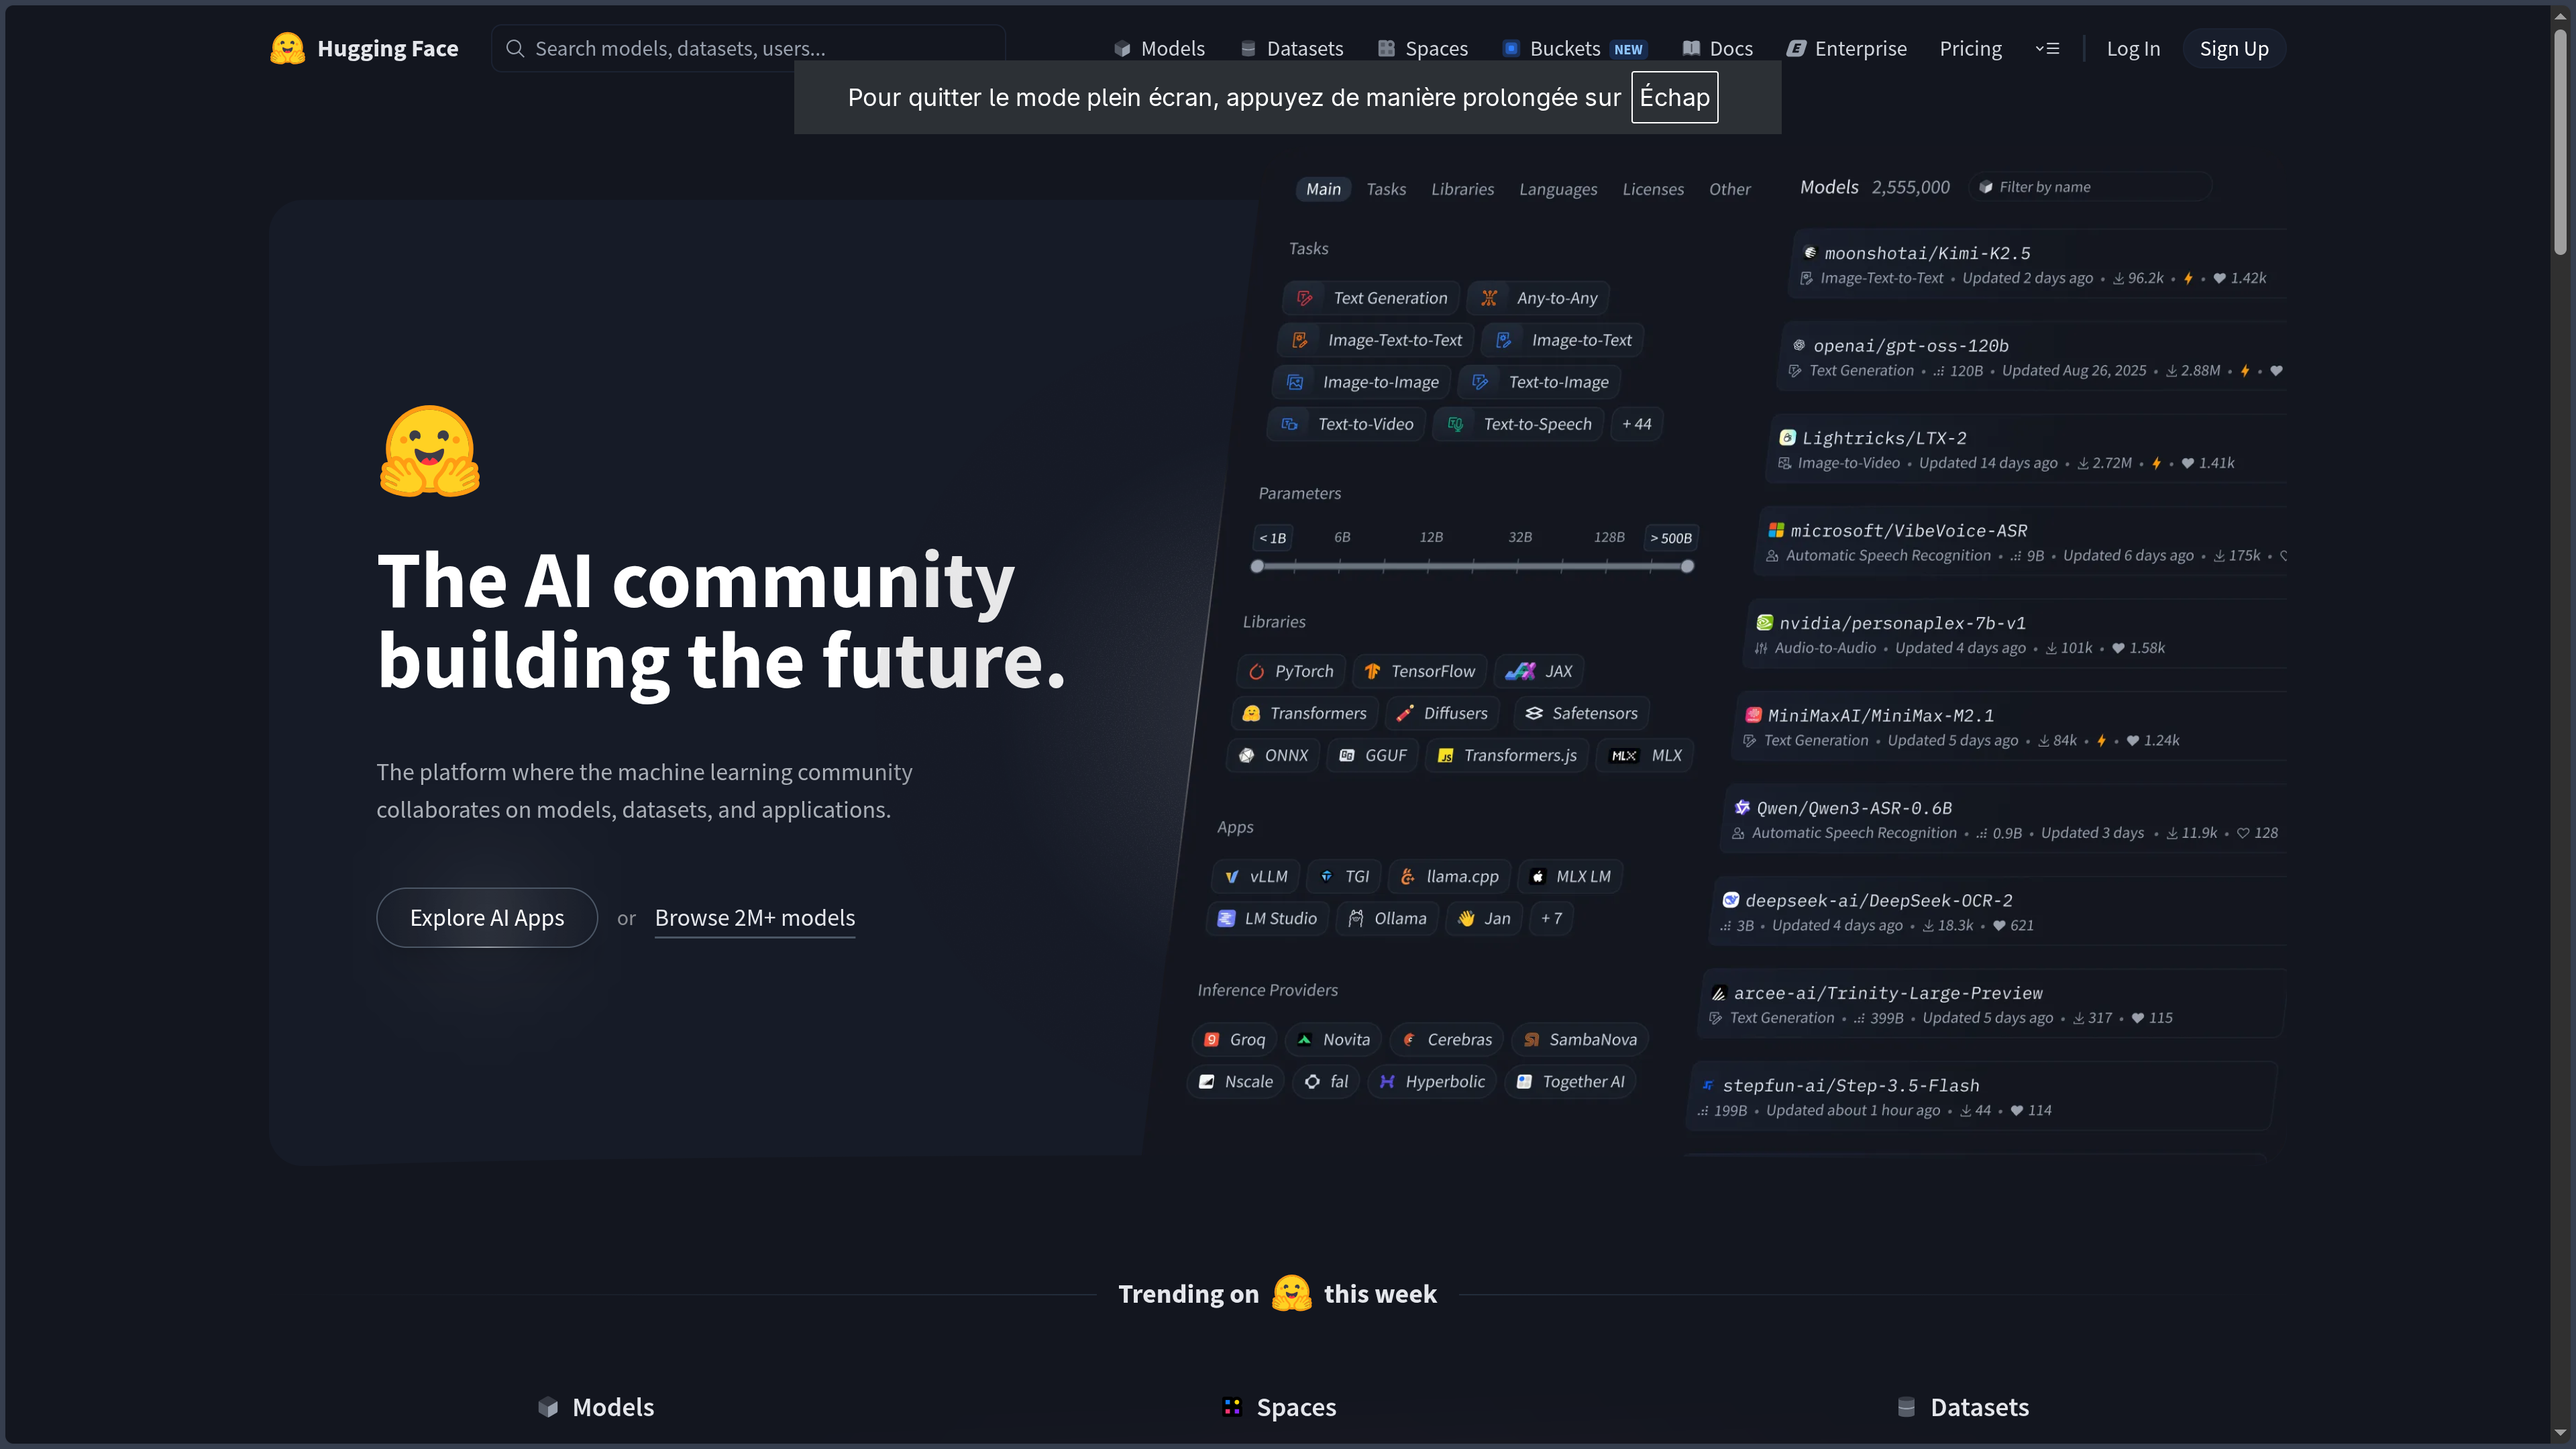
Hugging Face est l’une des principales infrastructures de partage, de découverte et de collaboration autour des modèles d’intelligence artificielle.
Son service central, le Hugging Face Hub, fonctionne comme une plateforme de dépôts adaptée au machine learning.
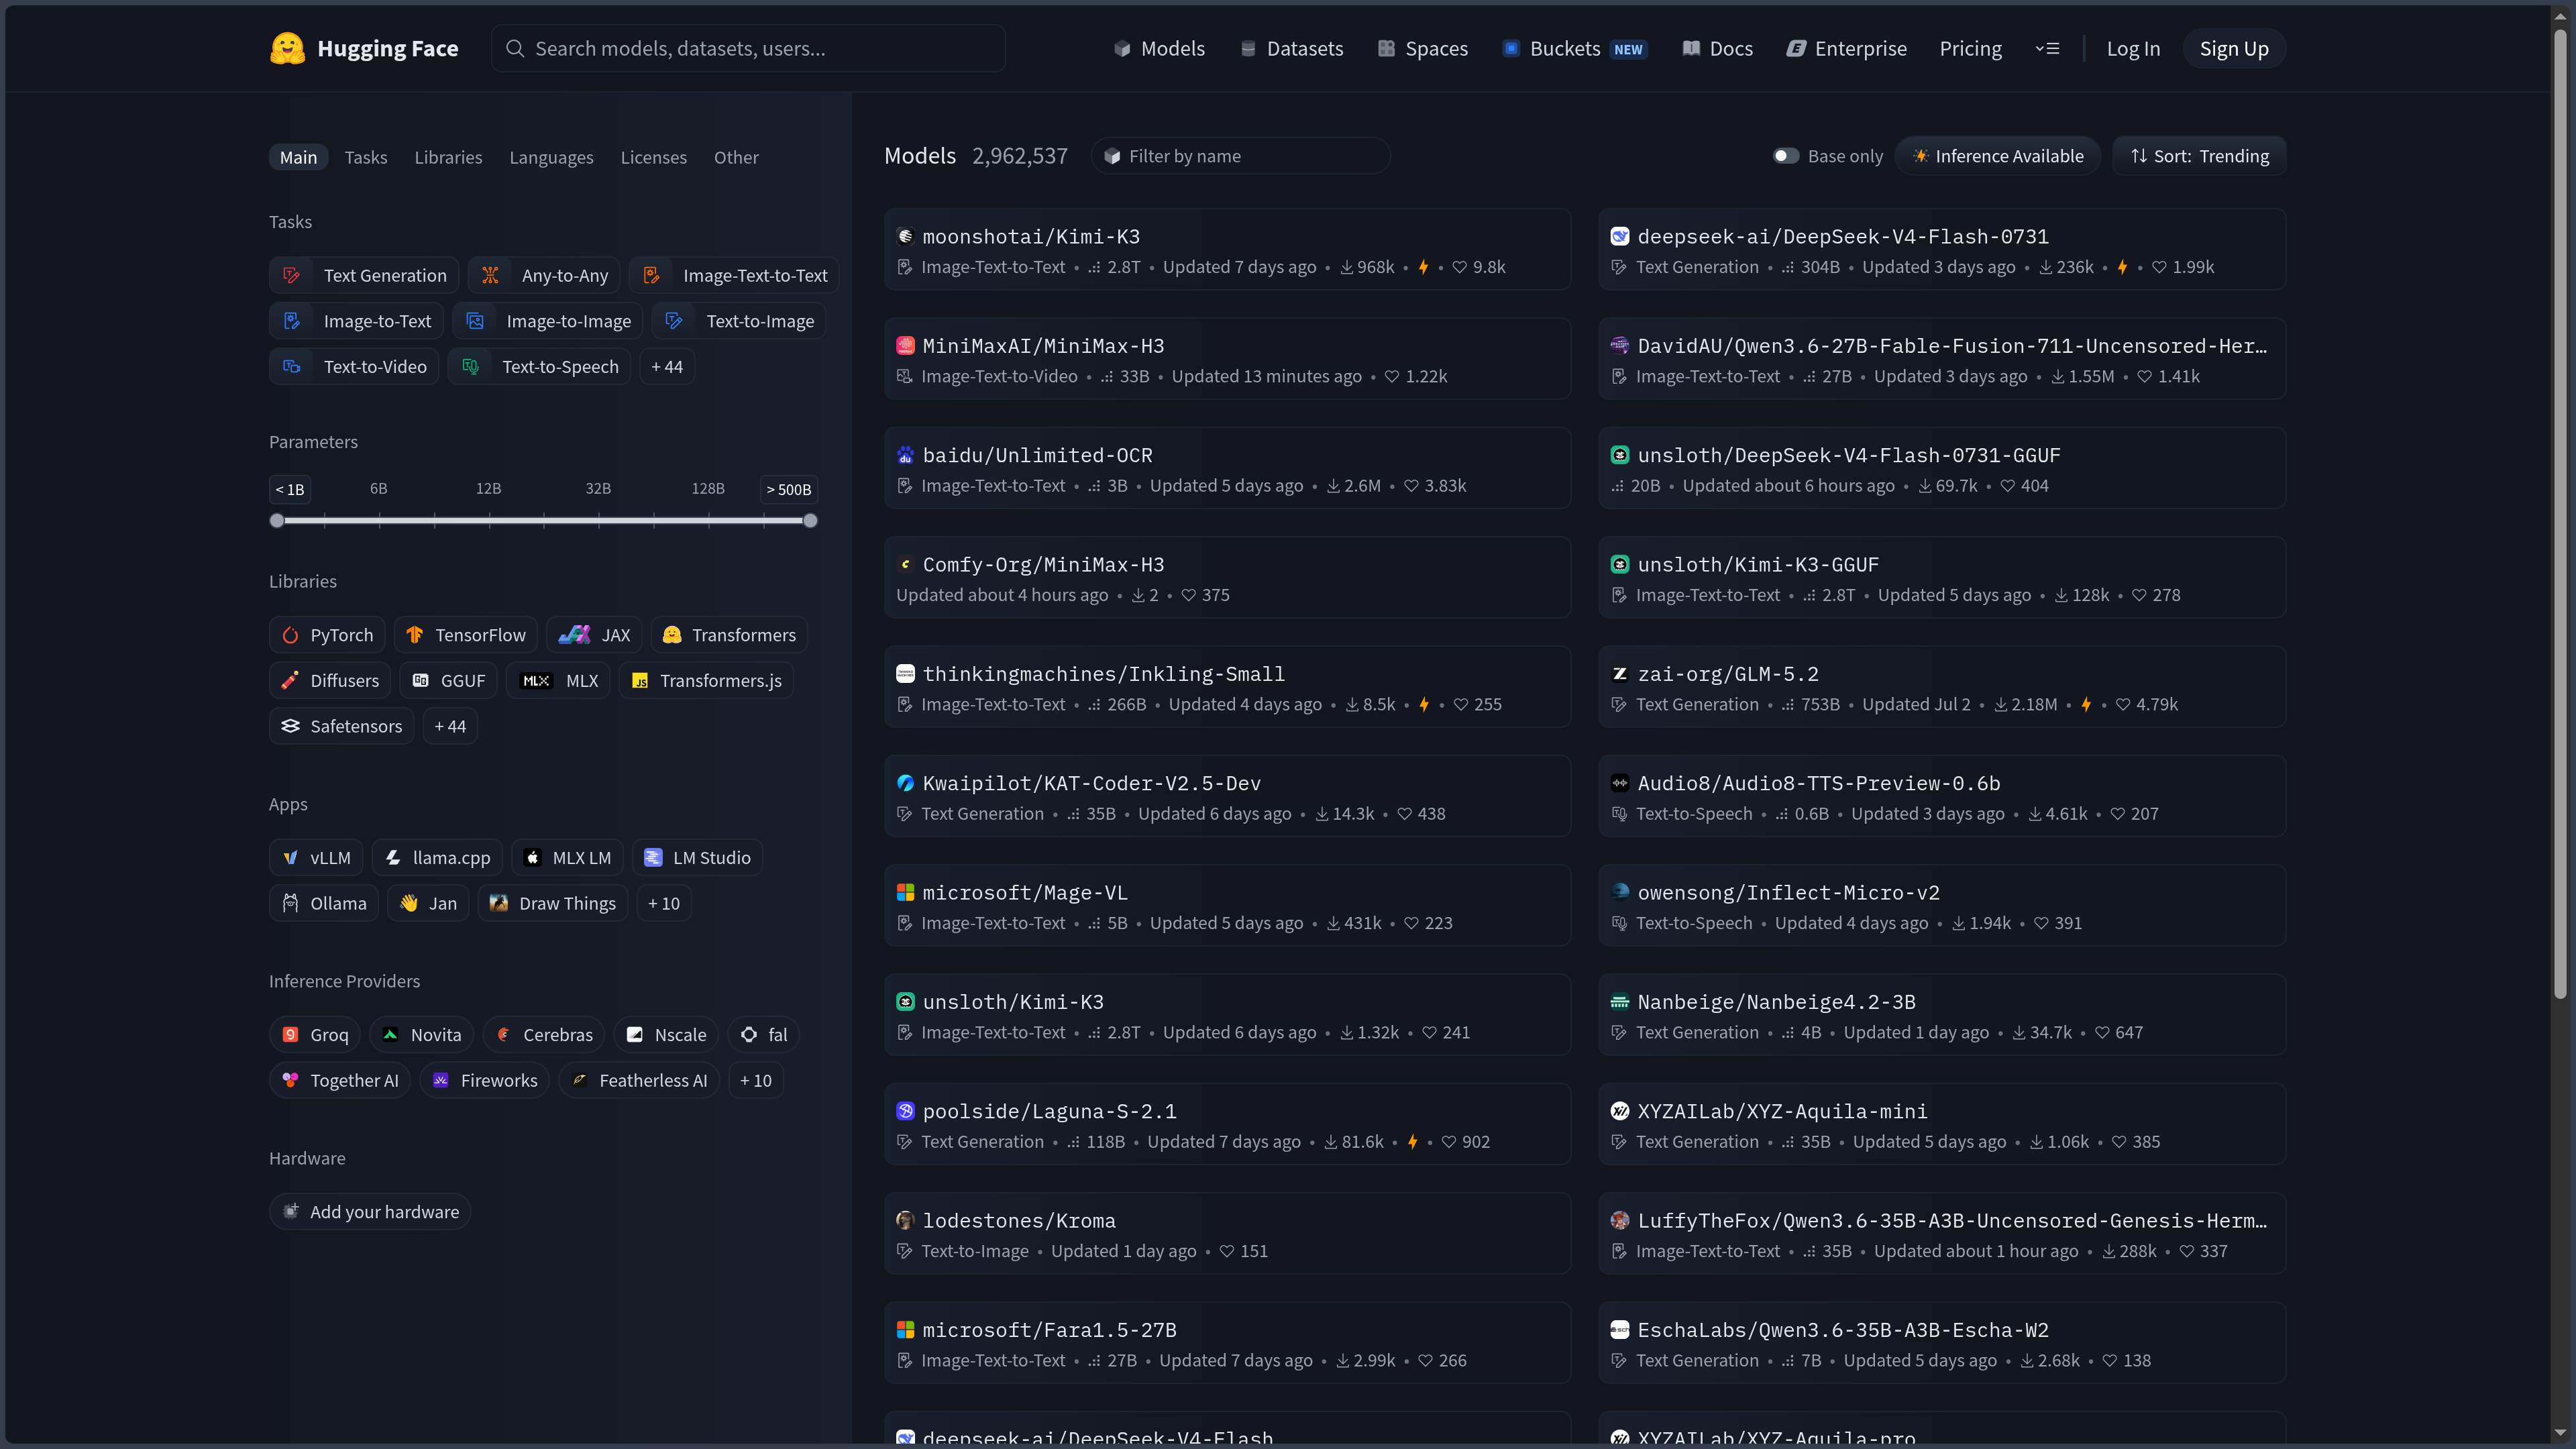
On y trouve des modèles, des datasets, des démonstrations, leur historique, leur documentation et, lorsque les auteurs l’indiquent correctement, leurs licences et résultats d’évaluation.
Cette organisation est ce qui rend Hugging Face si important.
La plateforme ne se contente pas de montrer qu’un modèle existe.
Elle permet souvent d’en consulter la fiche, télécharger les fichiers, examiner les dépendances, tester une démonstration puis préparer une exécution locale ou un déploiement distant.
Le Hub couvre un champ très large : langage, image, vision, audio, vidéo, traduction, classification, embeddings, robotique ou agents.
Hugging Face développe également plusieurs bibliothèques open source devenues courantes dans les workflows IA, notamment Transformers, Datasets, Diffusers, Tokenizers, Safetensors et huggingface_hub.
Cette richesse peut donner l’impression d’un immense catalogue.
L’identité de la plateforme est pourtant plus précise :
Hugging Face fournit une couche commune pour distribuer, documenter, tester et exploiter des ressources d’intelligence artificielle.
Elle peut servir à trouver un petit modèle local comme à organiser les ressources privées d’une équipe.
Elle occupe ainsi une position assez particulière.
Hugging Face n’est pas seulement un hébergeur.
Ce n’est pas non plus un fournisseur de modèles unique.
C’est une infrastructure de circulation entre recherche, modèles, datasets, code, démonstrations et déploiement.
Cette ouverture possède une contrepartie importante : la qualité, la sécurité et les licences sont très variables.
La présence d’une ressource sur Hugging Face ne constitue jamais une validation automatique.
Fonctionnalités
Hub : modèles, datasets et dépôts versionnés
Les modèles et jeux de données sont organisés en dépôts disposant de fichiers, versions, historique, documentation et métadonnées.
Cette logique de dépôt est essentielle pour comprendre la plateforme.
Un modèle n’est pas seulement un bouton « télécharger ».
Il peut être associé à :
- une architecture ;
- une configuration ;
- plusieurs formats de poids ;
- des versions ;
- des fichiers de tokenizer ;
- une licence ;
- des exemples ;
- des résultats d’évaluation ;
- des discussions ;
- des dépendances.
Les datasets suivent une logique proche avec leurs fichiers, structure, versions et informations de provenance.
Cette organisation facilite la collaboration et la reproductibilité.
Elle ne garantit pas que la documentation soit complète.
Un dépôt communautaire peut être excellent ou presque vide.
Model Cards, Dataset Cards et documentation
Les Model Cards et Dataset Cards peuvent préciser les usages recommandés, les limites, les données, les performances, la licence ou certains biais connus.
Ces fiches sont particulièrement importantes parce qu’elles donnent un contexte aux fichiers téléchargés.
Deux modèles ayant des performances proches sur un benchmark peuvent avoir été entraînés pour des usages, langues ou licences complètement différents.
Une bonne Model Card peut donc influencer davantage une décision qu’un simple classement.
La qualité reste variable.
Une fiche produite par l’auteur n’est pas une certification indépendante.
Elle doit être confrontée aux tests réels et aux conditions du projet.
Tester avec Spaces et démonstrations
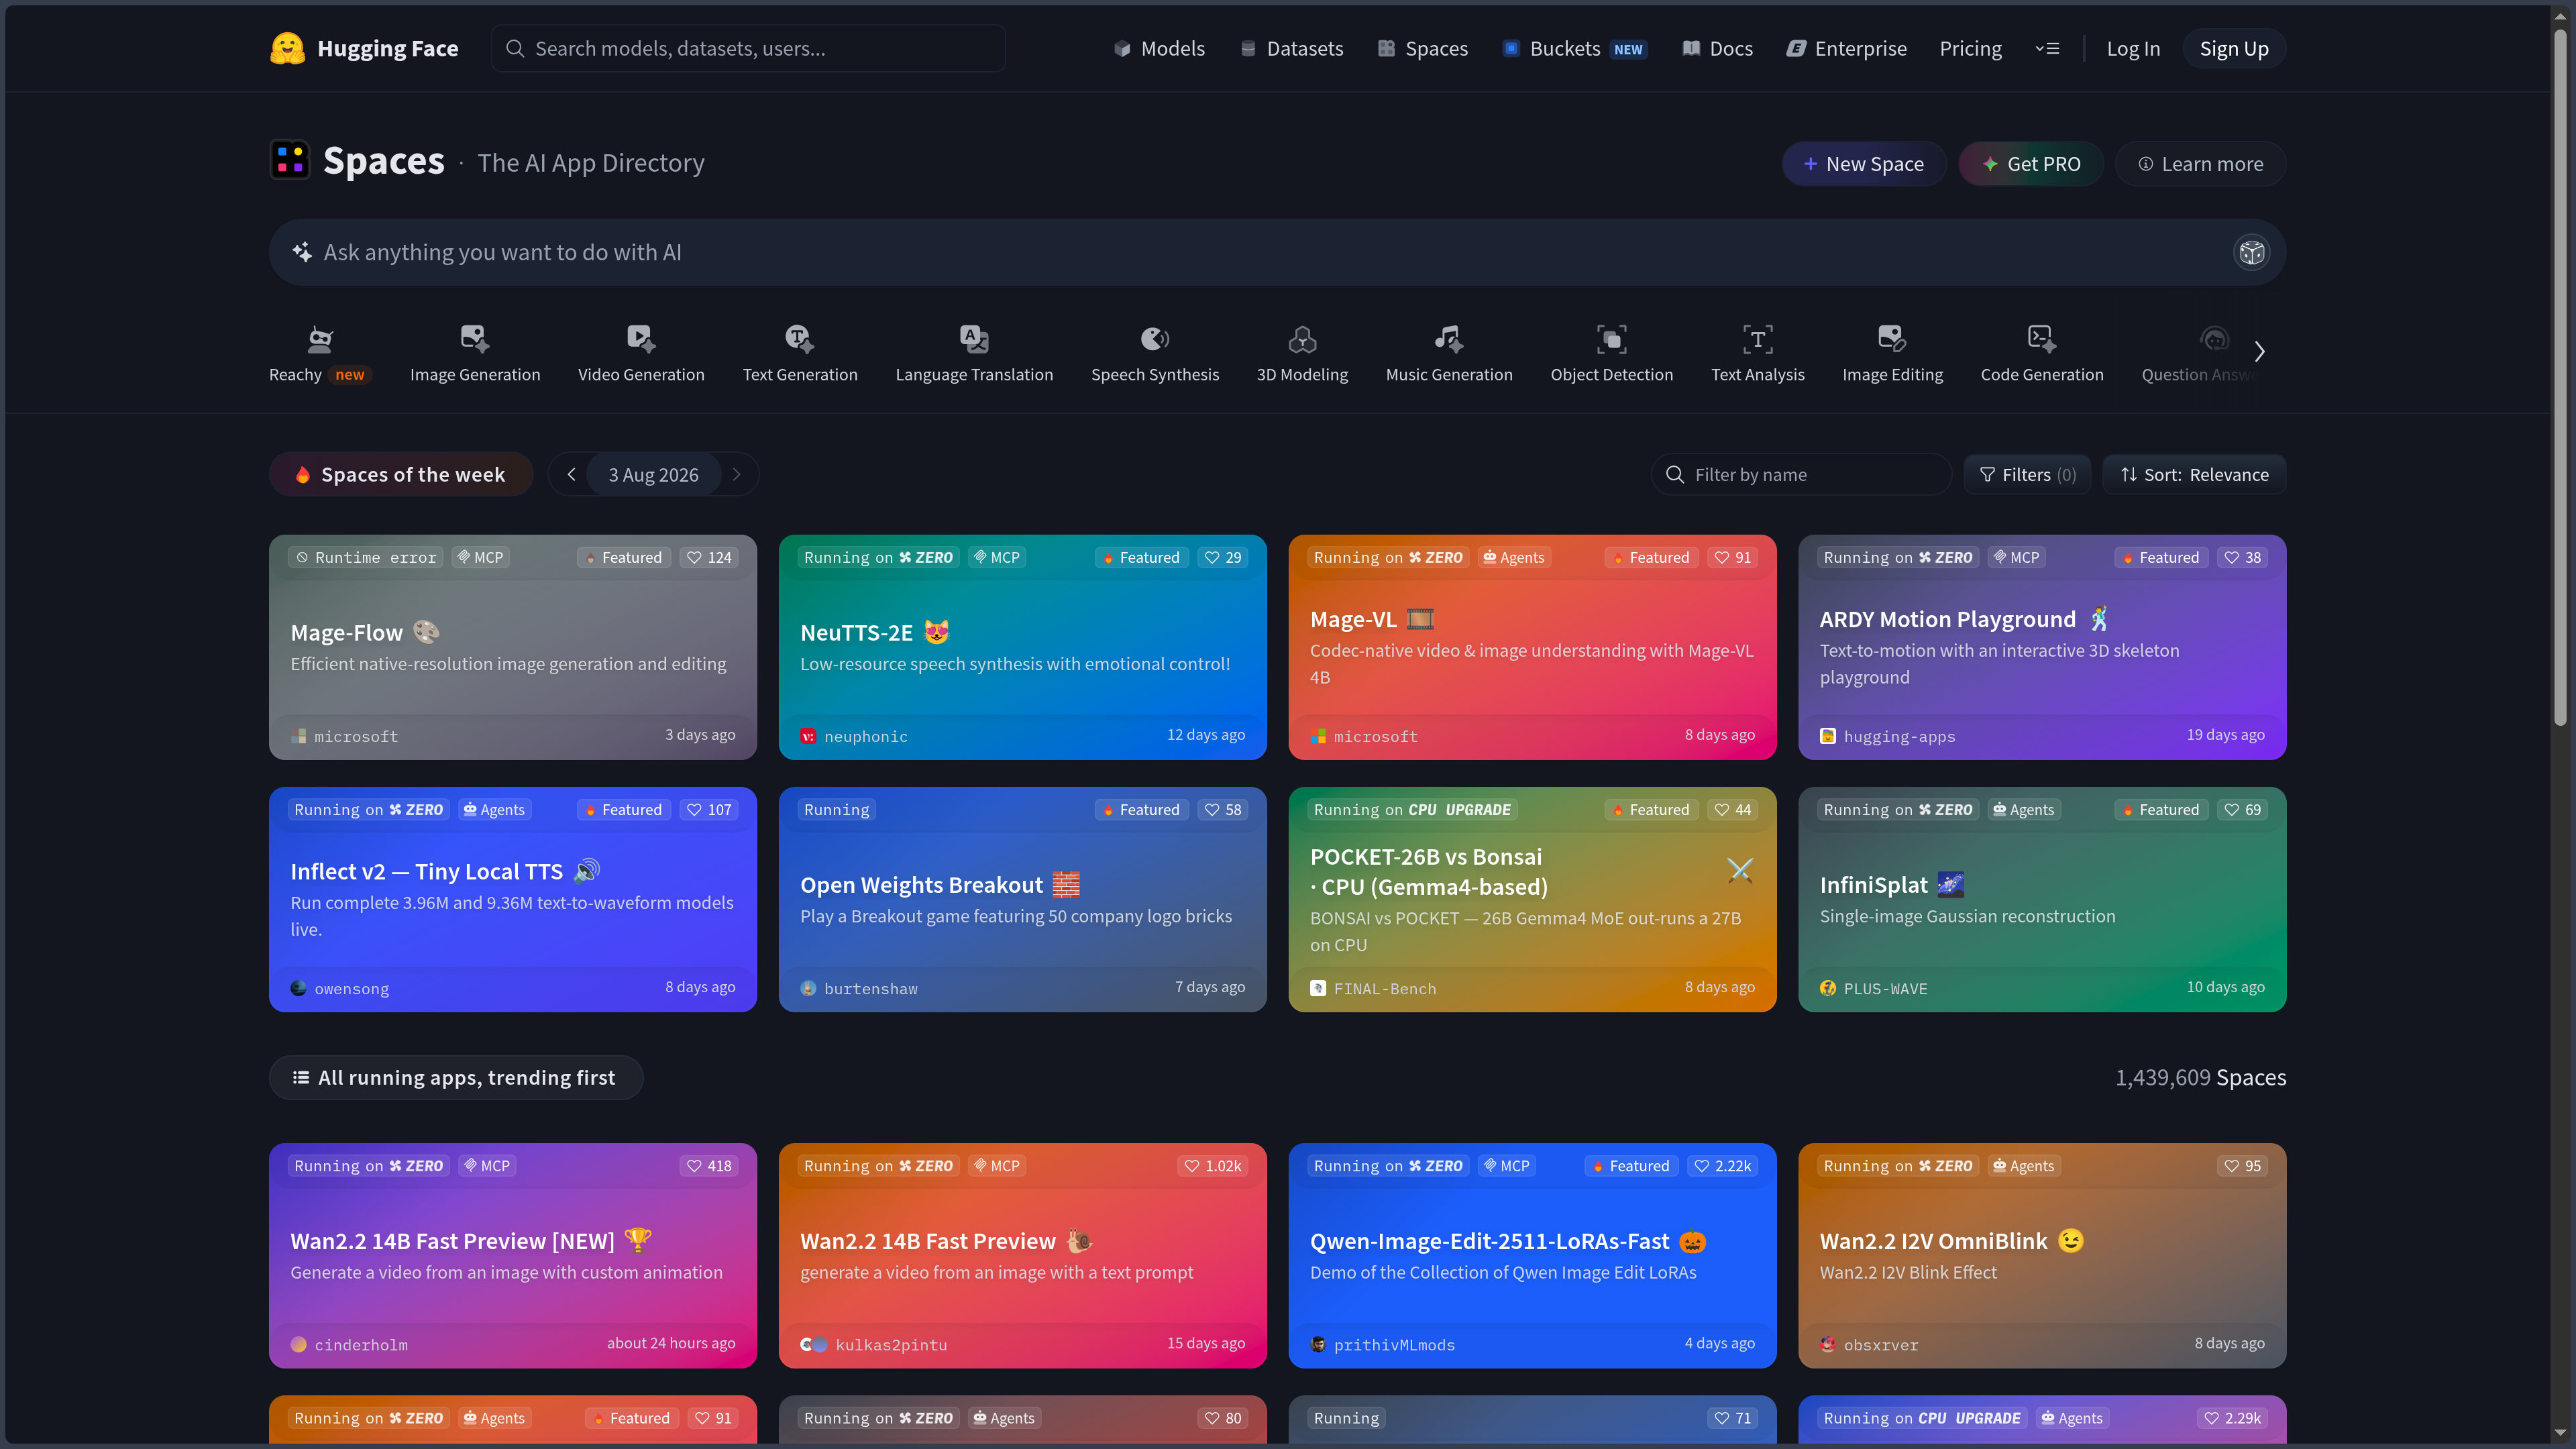
Hugging Face Spaces permet de publier des applications et démonstrations interactives.
Un Space peut servir à tester un modèle, présenter un prototype ou partager rapidement une interface.
C’est l’un des ponts les plus visibles entre dépôt technique et expérience utilisateur.
Un modèle abstrait devient immédiatement testable.
Pour les chercheurs et créateurs, cette possibilité est très pratique avant de préparer une installation locale ou une intégration complète.
Un Space communautaire reste toutefois une démonstration.
Disponibilité, sécurité, confidentialité, maintenance et performances ne sont pas garanties au niveau d’un service de production.
L’opérateur du Space et les données envoyées doivent être identifiés avant d’utiliser du contenu sensible.
Télécharger et exécuter localement
Un modèle peut être téléchargé pour fonctionner sur une station de travail, un serveur ou une infrastructure privée avec des bibliothèques et moteurs compatibles.
Cette possibilité fait de Hugging Face un point de passage important pour les utilisateurs qui souhaitent quitter une API hébergée et reprendre davantage de contrôle sur l’exécution.
Le Hub joue alors le rôle de distribution.
L’exécution réelle peut avoir lieu dans Transformers, Diffusers, llama.cpp, ComfyUI, Ollama, LM Studio ou d’autres environnements.
Cette distinction est importante.
Hugging Face héberge les ressources.
Le moteur d’inférence utilisé localement détermine ensuite une partie des performances, de la compatibilité et des contraintes matérielles.
Formats, quantification, précision numérique et architecture peuvent fortement modifier l’expérience.
Bibliothèques open source
L’écosystème Hugging Face ne se limite pas au site Web.
Transformers fournit une interface commune à de nombreuses architectures de modèles.
Diffusers joue un rôle similaire dans plusieurs workflows de génération visuelle.
Datasets facilite le chargement et le traitement de jeux de données.
Tokenizers, Safetensors et huggingface_hub répondent à d’autres couches du workflow.
Ces bibliothèques ont contribué à standardiser de nombreuses pratiques autour des modèles ouverts.
Elles restent cependant des projets logiciels distincts.
Une fiche Hugging Face doit montrer leur rôle dans l’écosystème sans devenir une formation à chacune d’elles.
API, Inference Providers et Endpoints
Hugging Face fournit des API, SDK et services de déploiement.
Les Inference Providers permettent d’accéder à différents fournisseurs d’inférence depuis une couche commune.
Les Inference Endpoints permettent de déployer des modèles dans des environnements dédiés.
Cette continuité offre plusieurs chemins :
tester → intégrer rapidement → déployer plus durablement → reprendre éventuellement le contrôle de l’infrastructure.
Elle est utile pour les équipes qui ne savent pas encore quel niveau de gestion elles souhaitent assumer.
Elle implique aussi des coûts, des conditions de fournisseur et des niveaux de confidentialité différents.
Organisations, dépôts privés et collaboration
Hugging Face peut également servir d’infrastructure privée pour des équipes.
Organisations, dépôts privés, groupes d’accès et fonctions professionnelles permettent de gérer modèles, datasets et applications internes.
Cette dimension est moins visible que le Hub public, mais elle montre que la plateforme peut servir autant à la découverte ouverte qu’à la gestion de ressources propriétaires.
La question des droits d’accès devient alors centrale.
Un modèle privé peut contenir des informations sensibles même si son code d’utilisation paraît banal.
Communauté et recherche
Profils, collections, discussions, publications scientifiques et pages d’organisations créent un écosystème dépassant largement le simple stockage de fichiers.
Pour la veille technique, cette proximité entre recherche, modèle et démonstration est particulièrement précieuse.
Un papier peut être relié à son implémentation.
Une implémentation peut être testée dans un Space.
Un modèle peut ensuite être téléchargé.
Cette continuité explique une grande partie du rôle central de Hugging Face dans l’écosystème IA ouvert.
Cas d’usage
Trouver un modèle pour un projet
Le Hub permet de rechercher par tâche, langue, architecture, bibliothèque, licence ou compatibilité.
Il constitue souvent le premier point de départ pour identifier un modèle local.
Exécuter une IA localement
Les fichiers peuvent être téléchargés puis utilisés avec différents moteurs d’inférence.
Hugging Face joue alors le rôle de bibliothèque de distribution.
Tester et comparer
Fiches, métadonnées, démonstrations et évaluations fournissent une première lecture des différences entre plusieurs ressources.
Le test réel doit néanmoins être effectué avec ses propres données et contraintes.
Créer une démonstration
Spaces permet de transformer rapidement un prototype en application accessible depuis le Web.
Publier un modèle, dataset ou prototype
Chercheurs, développeurs et entreprises peuvent versionner leurs ressources, les documenter et les partager publiquement ou dans des espaces privés.
Intégrer ou déployer
Les API et services d’inférence permettent de passer d’un modèle découvert sur le Hub à une intégration dans un logiciel ou un service.
Organiser les ressources d’une équipe
Les dépôts privés et organisations peuvent servir à centraliser modèles, datasets et démonstrations internes.
Suivre la recherche
Les liens entre publications, modèles et implémentations facilitent la veille scientifique et technique.
Conclusion
Une infrastructure plus qu’un catalogue
Réduire Hugging Face à une bibliothèque de modèles masque sa vraie valeur.
La plateforme crée une continuité entre :
découverte → documentation → distribution → démonstration → intégration → déploiement.
Cette continuité explique pourquoi elle est devenue centrale dans de nombreux workflows IA.
Le dépôt est une bonne abstraction
L’idée de gérer un modèle ou un dataset comme une ressource versionnée apporte une structure extrêmement utile.
Le poids du modèle n’est plus isolé de sa documentation, de ses versions et de sa licence.
Cette logique rapproche la gestion des ressources IA de pratiques déjà connues dans le développement logiciel.
Une porte d’entrée vers le local
Le Hub est particulièrement intéressant lorsqu’un projet souhaite comparer un service hébergé à une solution exécutée sur son propre matériel.
Il ne rend pas l’IA locale simple par magie.
Il rend surtout les ressources trouvables, documentées et partageables.
L’ouverture déplace la responsabilité vers l’utilisateur
Un modèle populaire peut avoir une licence restrictive, une documentation incomplète, des dépendances dangereuses ou des performances médiocres sur un cas précis.
Hugging Face fournit beaucoup d’indices.
Il ne remplace pas l’évaluation.
Les bibliothèques donnent une profondeur technique réelle
Transformers, Diffusers et les autres projets expliquent pourquoi Hugging Face est plus qu’un site Web.
La plateforme influence également la manière dont les développeurs chargent, testent et partagent les modèles.
Cette profondeur justifie une fiche plus riche qu’un simple annuaire de modèles.
Une plateforme technique
L’interface reste accessible.
Exploiter réellement les ressources demande souvent de comprendre formats, dépendances, matériel, quantification et déploiement.
Pour un débutant, le catalogue peut donc sembler beaucoup plus simple que le travail nécessaire après le clic « Download ».
Points d’attention
- Vérifier chaque licence : modèles, datasets et Spaces ne partagent pas une licence commune.
- Open weight ne signifie pas automatiquement open source.
- Examiner les Model Cards et la documentation avant d’intégrer une ressource.
- La documentation communautaire peut être incomplète ou incorrecte.
- Privilégier les formats sûrs lorsque des fichiers téléchargés peuvent exécuter du code au chargement.
- Ne pas confondre Space communautaire et service de production.
- Identifier l’opérateur réel avant d’envoyer des données sensibles à une démonstration ou un fournisseur.
- Anticiper le stockage et les ressources matérielles : certains modèles sont très volumineux.
- Quantification et moteur d’inférence peuvent modifier fortement les performances d’un modèle local.
- Les services d’inférence et GPU peuvent générer des coûts importants même si l’accès au Hub est largement gratuit.
- Tester un modèle dans son propre contexte plutôt que de se fier uniquement aux benchmarks publics.
- Évaluer la maintenance et les dépendances du dépôt avant une intégration à long terme.
- Les dépôts privés nécessitent une vraie gouvernance des accès.